
PostgreSQL / 系统课时
形成连接治理手册
形成连接治理手册
这一课把连接治理从临时排障动作整理成可执行手册:先建立容量与配置基线,再按统一顺序收集证据、止损、恢复和复盘,避免每次连接耗尽都靠个人经验临场判断。
学习目标
- 把容量预算与连接池配置整理成可检查的基线
- 建立从现象到根因、止损、恢复的标准排障路径
- 为连接事故定义复盘证据、改进项和治理门禁
手册先固定几个基线
治理手册第一部分不是故障处理,而是“正常状态长什么样”。至少记录每个应用实例的池最大连接数、最小连接数、获取超时、连接空闲回收策略,以及 PostgreSQL 的 max_connections、保留连接和实例总连接预算。
不要简单把所有应用池上限相加后再与数据库连接上限直接比较。数据库还需要为管理连接、迁移任务、运维操作及其他工作负载预留空间,连接预算应该从数据库总容量反推到应用实例。
建议用一个固定表格维护基线:
| 项目 | 基线内容 | 发生变化时检查 |
|---|---|---|
| 数据库容量 | PostgreSQL 连接上限与预留空间 | 实例扩缩容、版本或拓扑变化 |
| 应用池 | 最大/最小连接、获取超时 | 发布、扩容、连接池升级 |
| 运行信号 | 等待、超时、事务年龄 | 告警或容量异常 |
| 止损能力 | 降低并发、摘除实例、限制新任务 | 连接耗尽事故 |
固定故障定位顺序
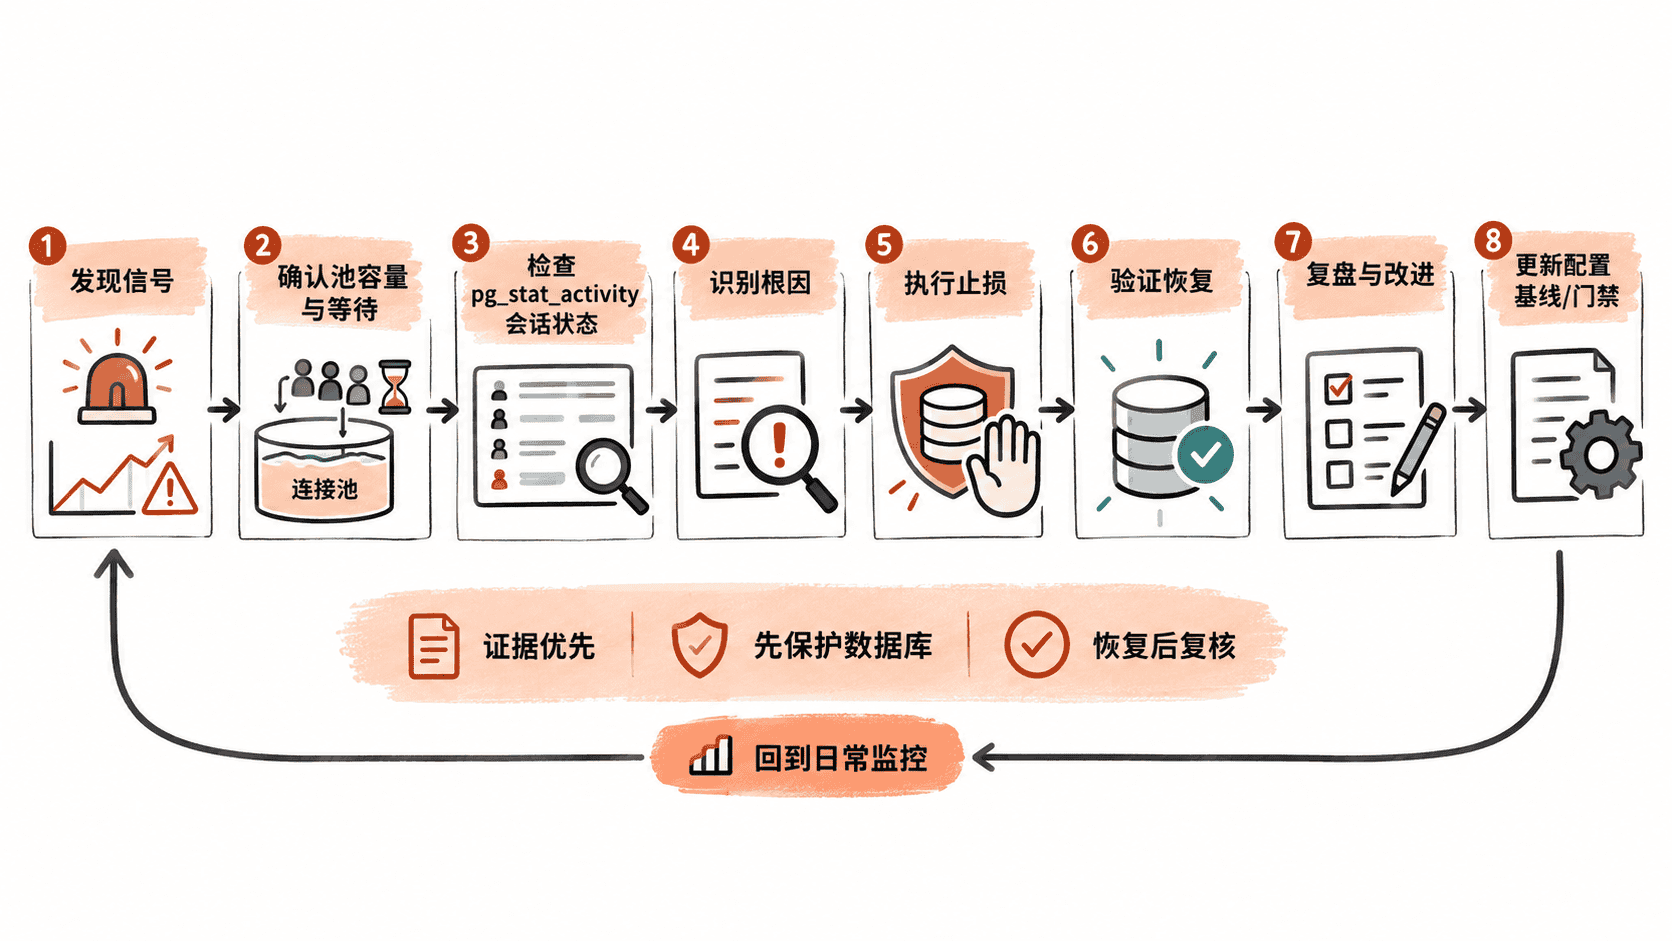
连接异常发生时,手册应要求值班人员按同一顺序采集证据,而不是先重启数据库。第一步确认应用池是否出现等待和获取超时;第二步确认 PostgreSQL 会话数量与状态;第三步确认是否大量 idle in transaction、长事务或等待事件;第四步回看最近发布、流量变化和连接池配置变化。
可以把现场检查固化成一个最小 SQL 片段:
SELECT
  state,
  count(*) AS sessions,
  count(*) FILTER (WHERE wait_event IS NOT NULL) AS waiting
FROM pg_stat_activity
WHERE datname = current_database()
GROUP BY state
ORDER BY state;
预期结果
         state          | sessions | waiting
------------------------+----------+---------
 active                 |      <N> |      <N>
 idle                   |      <N> |      <N>
 idle in transaction   |      <N> |      <N>
这一步的目的只是快速建立现状,不直接得出根因。比如 idle 很高可能只是池预留了较多空闲连接;真正值得继续追的是获取等待、事务年龄和数据库等待事件。
止损动作要有明确优先级
止损必须优先保护数据库,而不是追求立刻恢复全部流量。连接快速耗尽时,可以先限制新实例扩容带来的连接增长,必要时降低高峰期连接池上限,暂停非关键批处理,并避免把数据库重启当成首选恢复手段。
如果确认某一应用实例出现连接泄漏或长期不归还连接,应优先隔离该实例,再恢复健康实例。若发现大量 idle in transaction,应继续确认事务来源和年龄后再决定是否终止会话,避免误杀仍在执行关键工作的事务。
手册中应把“什么情况下允许结束会话、谁有权限执行、执行后如何验证”写成明确规则。排障动作如果只有命令没有判断条件,现场很容易把止损变成新的数据风险。
恢复后必须验证
恢复连接压力后,不应以“应用恢复 200”为唯一完成条件。至少再次确认池等待和获取超时回落、数据库会话数恢复到合理区间、idle in transaction 没有持续增长,并观察一段时间确保连接数没有再次攀升。
把复盘写成治理动作
复盘不要只记录“连接池调大了”。应至少回答四个问题:为什么连接需求超过预算,为什么监控没有更早暴露,为什么止损动作能够或不能快速执行,哪些配置或代码需要从根上修改。
每次事故都应沉淀可验证的改进项,例如补充连接获取超时指标、增加 idle in transaction 年龄告警、校准池大小与实例数的容量预算、为批任务设置独立连接上限,或在发布流程中增加连接配置变更检查。
连接治理真正形成闭环的标志,是下一次事故不再依赖“谁比较有经验”。当容量预算、配置基线、监控信号、排障路径、止损权限和复盘动作都写进手册并能被演练验证,连接耗尽才从偶发救火问题变成可持续治理的问题。