
PostgreSQL / 系统课时
设置连接获取超时
设置连接获取超时
连接池耗尽后,请求不会凭空消失,而是在池外继续等待。若等待时间没有明确上限,线程、协程、请求上下文和上游连接都会持续占用,最终把一个局部的连接不足放大成整条服务链路的拥塞。本课要建立的是一个明确的失败边界:等不到连接就及时失败,而不是无限排队。
学习目标
- 能区分连接获取超时、SQL 执行超时和请求超时。
- 能根据请求总预算设置合理的池内等待上限。
- 能在超时后停止继续放大数据库和应用侧压力。
先明确“等待连接”发生在哪里
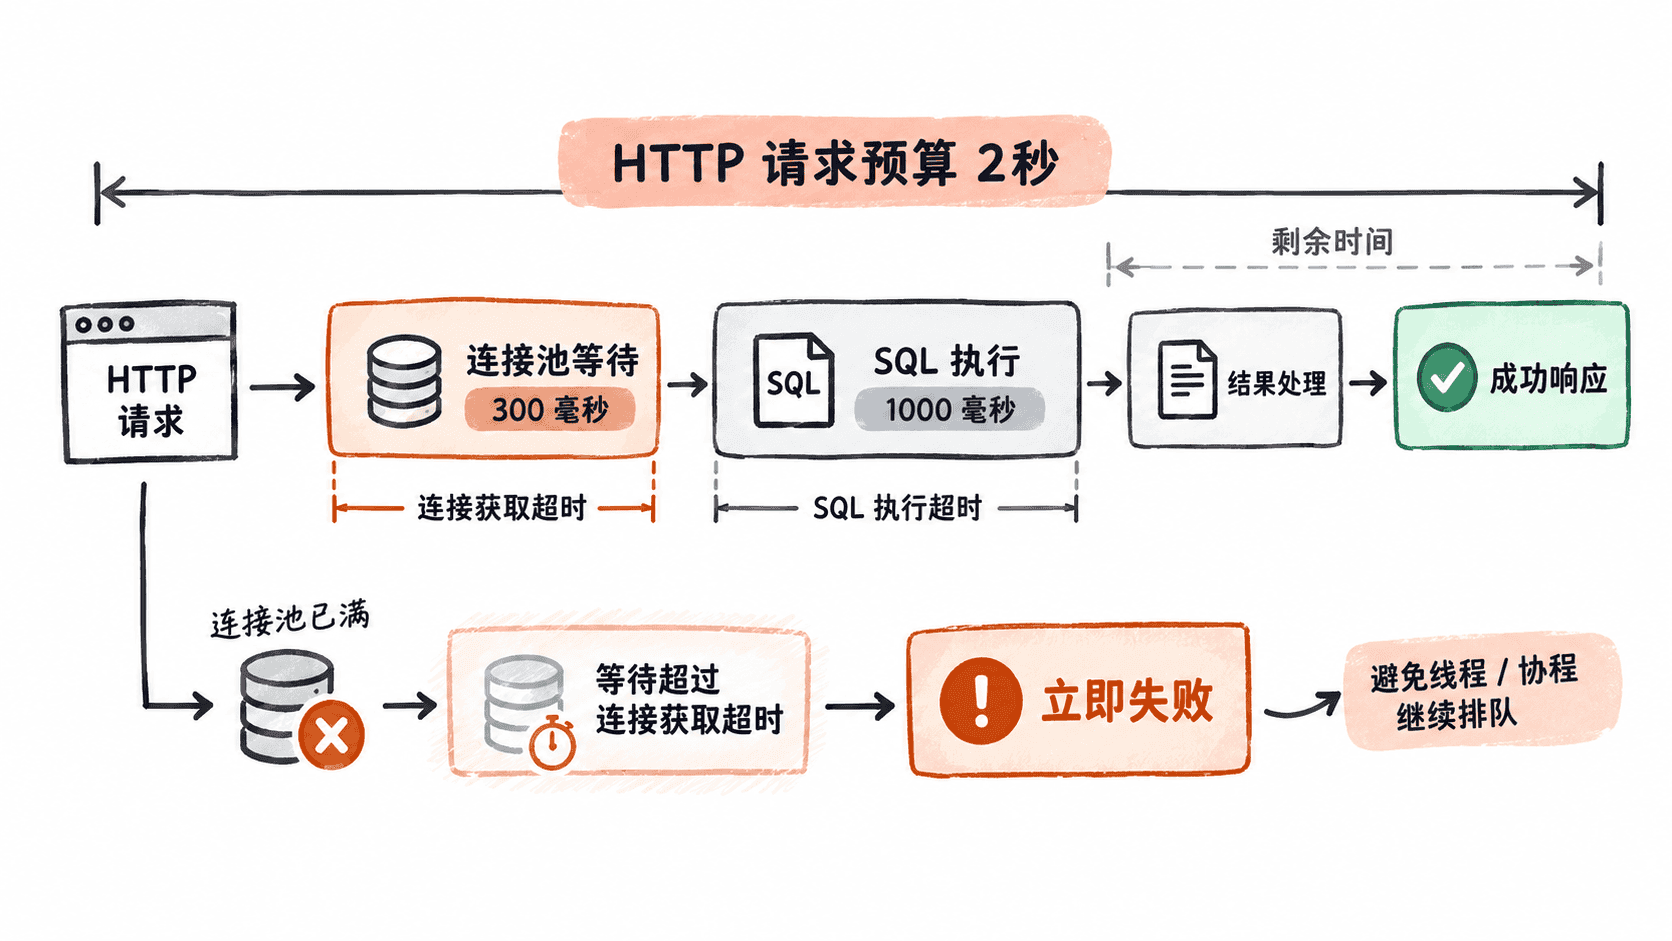
一次数据库请求至少可以分成两个阶段:先从连接池借到连接,再使用连接执行 SQL。连接池满时,应用卡住的是第一阶段;连接拿到后,如果数据库执行缓慢,卡住的则是第二阶段。两者必须分别设置超时,否则你可能已经限制了 SQL 执行时间,却仍让请求在连接池里无限等待。
例如一个 HTTP 请求总预算只有 2 秒,如果它先在池里等待 5 秒,后面即使 SQL 立即执行完,也已经失去请求时限。因此池内等待时间通常应明显小于上游请求超时,为后续 SQL 执行、序列化和响应留出时间。
设置连接获取超时
以 HikariCP 为例,connectionTimeout 控制从连接池获取连接时允许等待的时间,单位是毫秒。下面是一个片段示例,依赖已有的 JDBC 数据源配置。
HikariConfig config = new HikariConfig();
config.setJdbcUrl("jdbc:postgresql://<HOST>:<PORT>/<DB>");
config.setUsername("<USER>");
config.setPassword("<PASSWORD>");
config.setMaximumPoolSize(20);

// 池耗尽时最多等待3秒,超时后让请求进入明确的失败路径。
config.setConnectionTimeout(3000);

HikariDataSource dataSource = new HikariDataSource(config);
预期结果
当池中没有可用连接且等待超过3000毫秒时,获取连接的调用会失败,而不是继续无限等待。实际异常类型与完整消息取决于HikariCP版本和调用位置。这里的 3000 毫秒不是通用答案。它需要从请求总预算倒推。例如上游请求超时是 2 秒,就不能机械地把连接获取超时设成 3 秒。一个更合理的关系是:连接等待预算 < 请求总预算,并为 SQL 执行、重试策略和响应处理预留余量。
超时后为什么要“尽快失败”
连接获取超时的价值不只是让日志多一条异常,而是阻断排队链。假设连接池已经满了,新请求继续等待;等待中的请求又占用 Web 线程或协程资源;线程不足后,上游开始超时重试;重试继续制造更多等待请求。此时数据库连接数可能没有增加,但整个服务已经因为池外排队而失去吞吐能力。
因此池内超时应与上游限流、请求超时和重试策略一起看。数据库已经明显过载时,宁可让一部分请求快速失败,也不要让所有请求长时间占住应用资源。
用一个超时探针验证配置
下面的代码展示如何显式尝试获取连接并记录耗时。它是可运行的 Java 片段示例,依赖前文已经创建好的 dataSource。
long start = System.nanoTime();
try (Connection connection = dataSource.getConnection()) {
    long elapsedMs = (System.nanoTime() - start) / 1_000_000;
    System.out.println("connection acquired in " + elapsedMs + " ms");
} catch (SQLException e) {
    long elapsedMs = (System.nanoTime() - start) / 1_000_000;
    System.out.println("connection acquisition failed after " + elapsedMs + " ms");
    throw e;
}
预期结果
正常获得连接时:connection acquired in <TIME> ms
池已耗尽并超过连接获取超时时:connection acquisition failed after <TIME> ms
<TIME> 是实际运行时间,受机器负载、池状态和调度影响。验证重点是失败时间应接近配置的连接获取超时,而不是无限增长。
避免把多个超时混成一个参数
连接获取超时、SQL 执行超时和 HTTP 请求超时分别保护不同资源。可以按下面的原则建立预算:连接获取时间最先受控,SQL 执行时间其次受控,请求总超时放在更外层兜底。这样当数据库异常时,请求会在较早阶段停止,而不是一路占用资源直到最外层超时。
还要特别检查客户端重试:如果一次请求在连接获取超时后立刻重试,单个调用可能连续占用多个等待窗口,反而延长压力。连接池已经紧张时,应优先减少重试次数或采用退避,而不是把连接获取超时无限拉长。
连接获取超时真正要解决的是排队边界。当池已满,应用必须在一个有限窗口内做出“拿到连接并继续”或“快速失败并释放资源”的决定。只有这样,连接池才能成为压力缓冲层,而不是把数据库拥塞继续扩散到线程池、协程池和上游请求。