
PostgreSQL / 系统课时
定位应用池等待
定位应用池等待
应用响应变慢时,最容易误判成“数据库慢”。本课先判断请求是不是卡在获取连接这一步,再把池等待与 PgBouncer、PostgreSQL 的状态对齐,从而区分池容量不足、连接泄漏和数据库处理过慢。
学习目标
- 能识别连接池获取超时、等待队列增长和业务延迟之间的关系。
- 能按客户端池 → PgBouncer → PostgreSQL 的顺序定位等待发生在哪里。
- 能用连接获取耗时、等待数量和数据库会话状态验证根因,而不是只看 SQL 慢查询。
先判断请求卡在哪里
一次典型数据库请求至少包含“获取连接 → 执行 SQL → 归还连接”三个阶段。若请求在获取连接阶段等待,那么数据库 SQL 本身可能尚未开始执行;此时增加 SQL 日志分析并不能直接解释用户延迟。
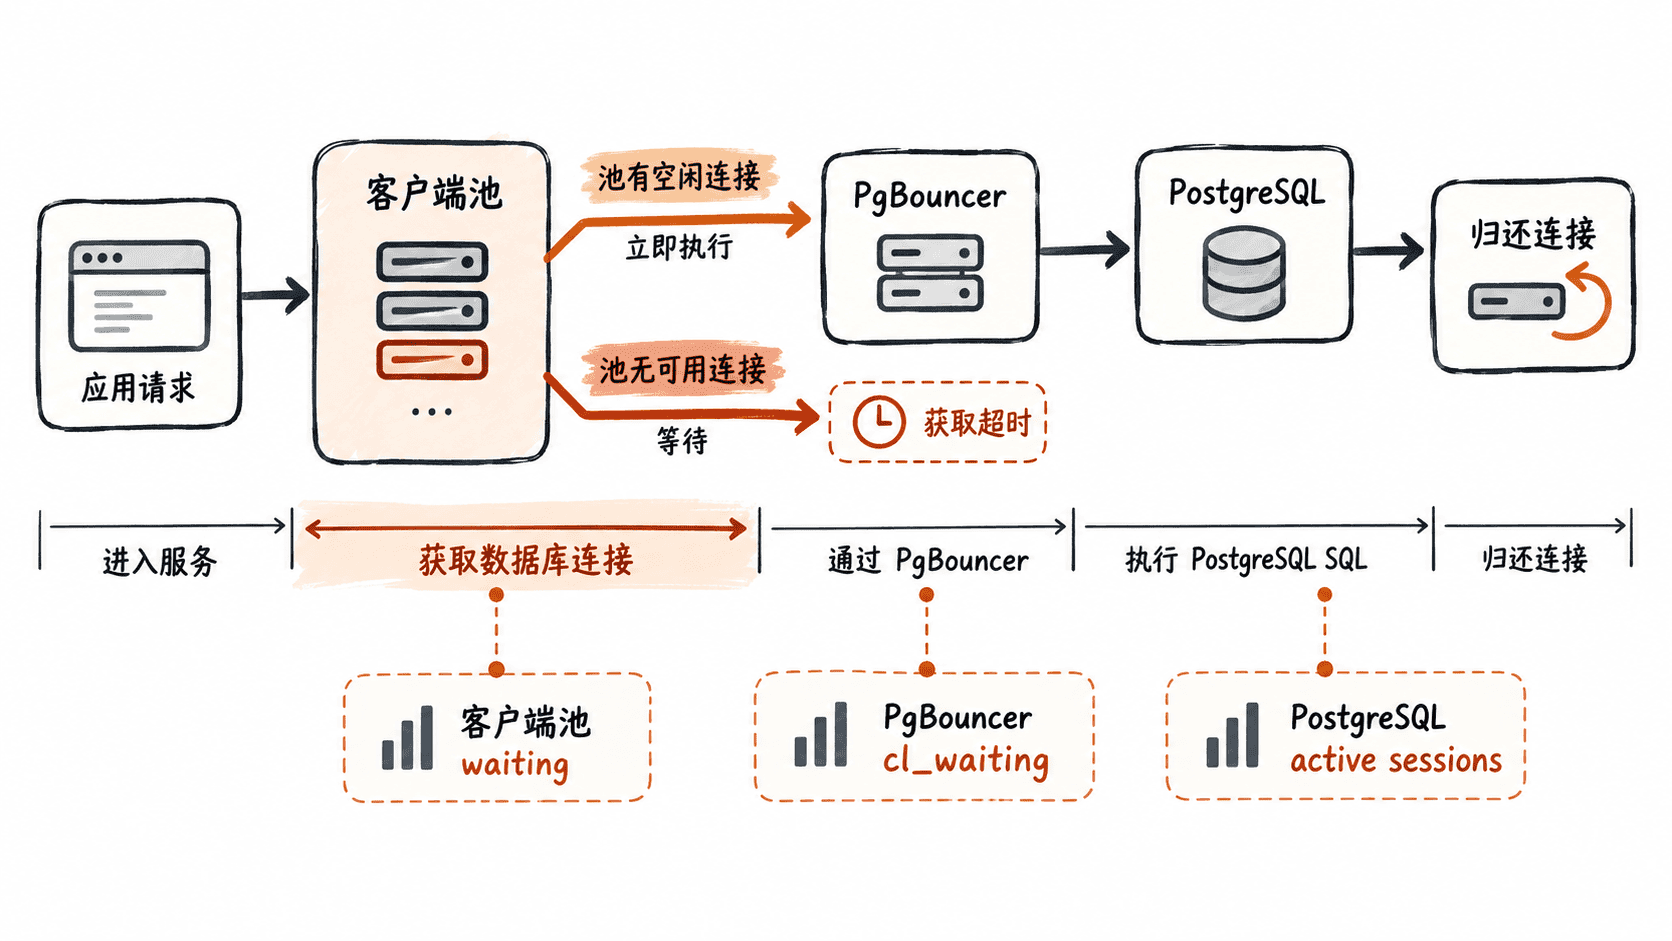
判断入口很简单:如果“连接获取耗时”已经明显升高,而拿到连接后的 SQL 执行时间仍正常,那么主要问题在池容量、连接归还、连接寿命或下游连接资源;如果获取连接几乎不等待,但 SQL 执行时间明显变长,则应转向数据库执行性能或锁等待分析。
用连接获取超时建立证据
不同客户端连接池的指标名称不同,但通常都能提供 active、idle、pending/waiting、timeout 或 connection acquisition latency。下面以命令行模拟一个最小检查点:你需要把 <TIME> 替换成实际采样时间,并从应用监控系统读取对应池指标。
printf 'sample_time=<TIME>\n'
printf 'pool_active=<VALUE>\n'
printf 'pool_idle=<VALUE>\n'
printf 'pool_waiting=<VALUE>\n'
printf 'pool_acquire_timeout=<VALUE>\n'
预期输出
sample_time=<TIME>
pool_active=32
pool_idle=0
pool_waiting=18
pool_acquire_timeout=6
这组结果表示池内连接已经全部被占用,还有请求排队,并且部分请求已经因为超过获取超时而失败。它足以证明“存在应用池等待”,但还不能证明等待的根因在 PostgreSQL;下一步必须观察下游连接。
对齐 PgBouncer 与 PostgreSQL
等待应用池的请求通常还没有真正占用一个 PostgreSQL 后端。因此要把应用等待与 PgBouncer 的客户端等待、服务器连接使用情况放到同一时间点观察。先执行:
psql -h <HOST> -p <PORT> -U <ADMIN_USER> -d pgbouncer -c "SHOW POOLS;"
psql -h <HOST> -p <PORT> -U <DB_USER> -d <DB_NAME> -c "SELECT state, count(*) FROM pg_stat_activity WHERE datname = current_database() GROUP BY state ORDER BY state;"
预期结果
 database | cl_active | cl_waiting | sv_active | sv_idle
----------+-----------+------------+-----------+---------
 <DB_NAME>|        20 |          0 |        20 |       0

  state  | count
---------+------
 active  |    20
 idle    |     2
这里出现一个重要信号:应用池已经有大量 waiting,但 PgBouncer cl_waiting 为 0,PostgreSQL 也没有异常堆积。此时应优先检查应用池自身是否过小、连接是否没有及时归还,或应用侧是否设置了过短的获取超时,而不是直接认定数据库连接数不足。
反过来,如果应用等待增长的同时 cl_waiting 也增长,并且 sv_active 长时间贴近池上限,则 PgBouncer 也在等待服务器连接。此时继续向下检查 PostgreSQL 是否处理过慢、长事务是否占用连接,以及最大连接预算是否过低。
区分三类常见根因
池太小的典型特征是应用 waiting 上升,但 PostgreSQL 实际负载并不高,连接归还很快;扩大池可能缓解表象,却可能把更多并发压力传给数据库,因此应先确认数据库连接预算。
连接没有及时归还通常表现为 active 长时间接近上限、idle 很少,且部分请求的连接持有时间远高于 SQL 执行时间。常见原因是事务边界过大、业务代码遗漏归还,或者把外部调用放进了持有连接的区域。
数据库本身过慢则更常见为连接已经成功获取,但随后执行时间持续升高;如果 PostgreSQL 后端长期处于 active,应继续检查慢 SQL、锁等待、I/O 或 CPU,而不是继续调大应用池。
验证修复是否真正生效
修复后不要只观察错误率下降。至少同时确认 pool_waiting 和连接获取耗时回落、获取超时停止增长,并检查 PostgreSQL 活跃连接没有因为扩大池而突破设计上限。最理想的结果是:业务请求恢复正常,池有少量可控等待,数据库连接维持在预设预算内。
定位应用池等待的关键是把“请求慢”拆成时间段来观察。只要能证明延迟主要发生在获取连接阶段,再用 PgBouncer 与 PostgreSQL 的状态验证下游是否同步受限,就能把调参从猜测变成证据驱动的故障定位。