
PostgreSQL / 系统课时
验证容量模型有效性
验证容量模型有效性
容量模型不能靠公式自证正确,必须用受控压测把连接数、吞吐、延迟和数据库资源放在同一时间轴上验证。完成本课后,你能判断池容量是否真的限制了并发,以及瓶颈究竟落在连接、CPU、锁还是查询执行。
学习目标
- 用压测逐步提高并发,观察池等待与数据库活动连接的变化
- 用 PostgreSQL 统计信息区分连接瓶颈、CPU 饱和、锁等待和查询执行问题
- 根据实测拐点修正连接池容量,而不是只按经验设置最大连接数
先定义模型的可验证假设
容量模型至少要给出三个可观测假设:池最大连接数是多少、应用在稳定负载下需要多少并发数据库会话、数据库在什么资源水平下仍能保持目标延迟。一个常见模型是把数据库可承载连接预算分给多个应用实例,而不是让每个实例都直接使用数据库的全部 max_connections。
压测时不要只看 QPS。至少同时记录应用请求延迟、池中正在使用的连接数、等待获取连接的请求数,以及 PostgreSQL 的活跃会话、CPU、锁等待和最慢查询。只有这些指标能互相对上,容量模型才有证据支撑。
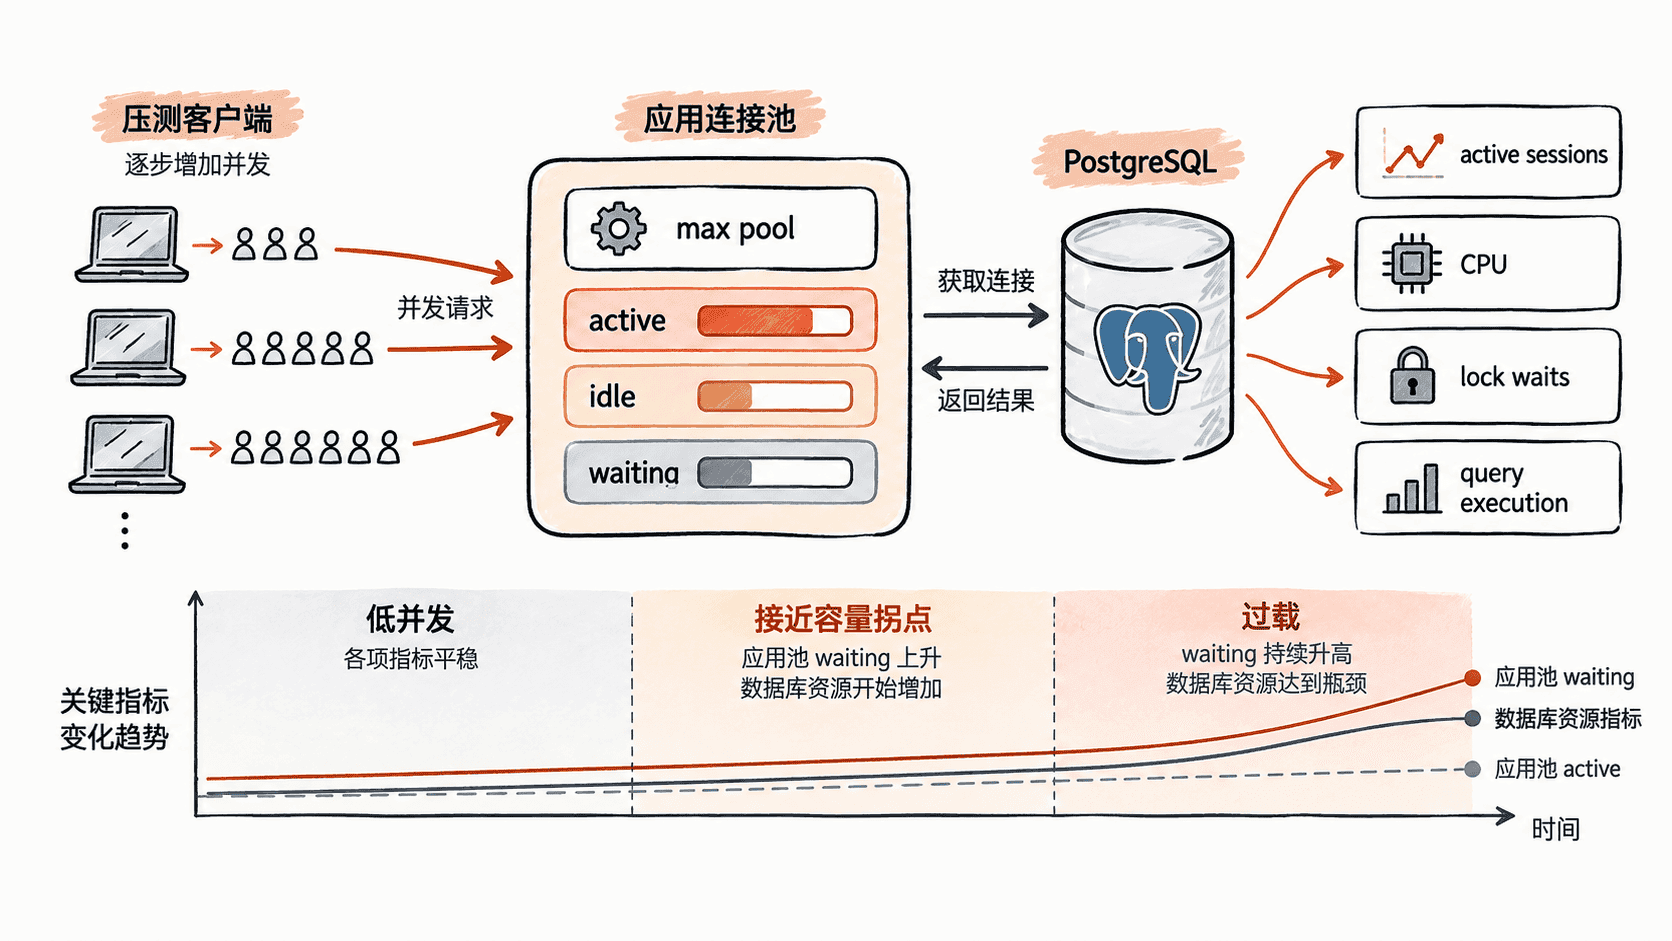
用阶梯压测寻找拐点
不要一开始就把并发拉到峰值。更有效的方法是设置多个稳定台阶,例如从低并发开始,每个台阶保持足够时间,再逐步增加。观察延迟是否线性增长、池等待是否突然出现,以及数据库活动会话是否继续增长。
pgbench 可以快速制造稳定的 PostgreSQL 请求负载。下面示例先初始化一个最小测试库,再以固定客户端数运行一段时间;<VALUE> 与 <TIME> 应替换为你的实验参数。
createdb capacity_lab
pgbench -i -s 10 capacity_lab
pgbench -c <VALUE> -j 4 -T <TIME> -P 5 capacity_lab
预期结果
pgbench: client 0 executing script "tpcb-like"
progress: 5.0 s, 1234.5 tps, lat 8.1 ms stddev 1.9
progress: 10.0 s, 1251.7 tps, lat 7.9 ms stddev 1.7
transaction type: <builtin: TPC-B (sort of)>
number of transactions actually processed: <VALUE>
latency average = <VALUE> ms
这里最重要的不是某个固定 TPS,而是不同并发台阶之间的趋势。若并发继续增加而吞吐基本不再增长、延迟却快速上升,就出现了容量拐点。此时还要检查连接池是否先出现等待,避免把所有延迟都误判成 PostgreSQL 本身变慢。
用数据库证据定位真正瓶颈
连接数升高并不等于连接是瓶颈。先在压测过程中查看会话状态,重点区分 active、等待事件以及长期不退出的连接。
SELECT
  state,
  wait_event_type,
  wait_event,
  count(*) AS sessions
FROM pg_stat_activity
WHERE datname = current_database()
GROUP BY state, wait_event_type, wait_event
ORDER BY sessions DESC;
预期结果
 state   | wait_event_type |       wait_event        | sessions
---------+-----------------+-------------------------+---------
 active  |                 |                         | 12
 active  | Lock            | transactionid           | 3
 idle    | Client          | ClientRead              | 8
state 已纳入分组,因此查询可以直接执行。结果中,若大量会话处于 active 且没有明显等待,CPU 或查询执行本身更值得检查;如果大量会话正在等待锁,继续增大连接池通常只会放大竞争;如果数据库活动连接并不高,但应用端已经出现大量获取连接等待,则更像是池容量不足或连接长期占用。
查询执行时间可以结合 pg_stat_statements 聚合观察。下面查询用于定位平均耗时和总耗时较高的语句;实验环境需要先启用该扩展。
SELECT
  calls,
  round(mean_exec_time::numeric, 2) AS mean_ms,
  round(total_exec_time::numeric, 2) AS total_ms,
  left(query, 100) AS query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
预期结果
 calls | mean_ms | total_ms  | query
-------+---------+-----------+----------------------------------------
 12000 |   12.40 | 148800.00 | SELECT ...
  3400 |   38.10 | 129540.00 | UPDATE ...
结果中的 SQL 只是示意,实际文本取决于压测脚本。判断瓶颈时,要把它和同一压测阶段的 CPU、锁等待、池等待一起看,而不能单看 mean_ms。
用数据修正连接池容量
验证容量模型时,可以把每个实验台阶记成一行:并发客户端数、池活跃连接、池等待数、数据库活动连接、平均延迟、P95、CPU 和锁等待。真正值得调整的是出现明显拐点之前的连接容量,而不是追求数据库中最大的同时连接数。
例如,若池从 20 提升到 40 个连接后吞吐几乎不变,但 P95 明显上涨,同时 PostgreSQL 锁等待增加,应降低池容量并继续优化事务或 SQL;若池只有 10 个连接时应用已经大量等待,而数据库 CPU 和锁压力都很低,则可以适度提高池容量,再次压测验证。
最终验收标准不是“压测通过”,而是容量模型能够解释观察到的现象:连接池等待增长时,能指出为什么;继续加连接后性能恶化时,能指出在哪里;目标负载下还能留出多少安全余量,也能用数据证明。