
PostgreSQL / 系统课时
建立连接监控指标
建立连接监控指标
这一课把连接池治理变成可观测指标:同时观察池容量、获取等待、PostgreSQL 会话状态与事务年龄,并用组合信号判断瓶颈究竟在连接池还是数据库资源。
学习目标
- 建立连接池、数据库会话与事务状态三层监控模型
- 正确区分会话状态、活跃等待与真正的数据库资源竞争
- 定义可用于告警、容量分析和故障定位的核心指标
先把监控分成三层
连接池指标回答“应用为什么拿不到连接”,数据库指标回答“这些连接现在在做什么”,业务指标则回答“连接异常是否已经影响请求”。三层缺一不可,否则很容易把连接池等待误判成数据库故障。
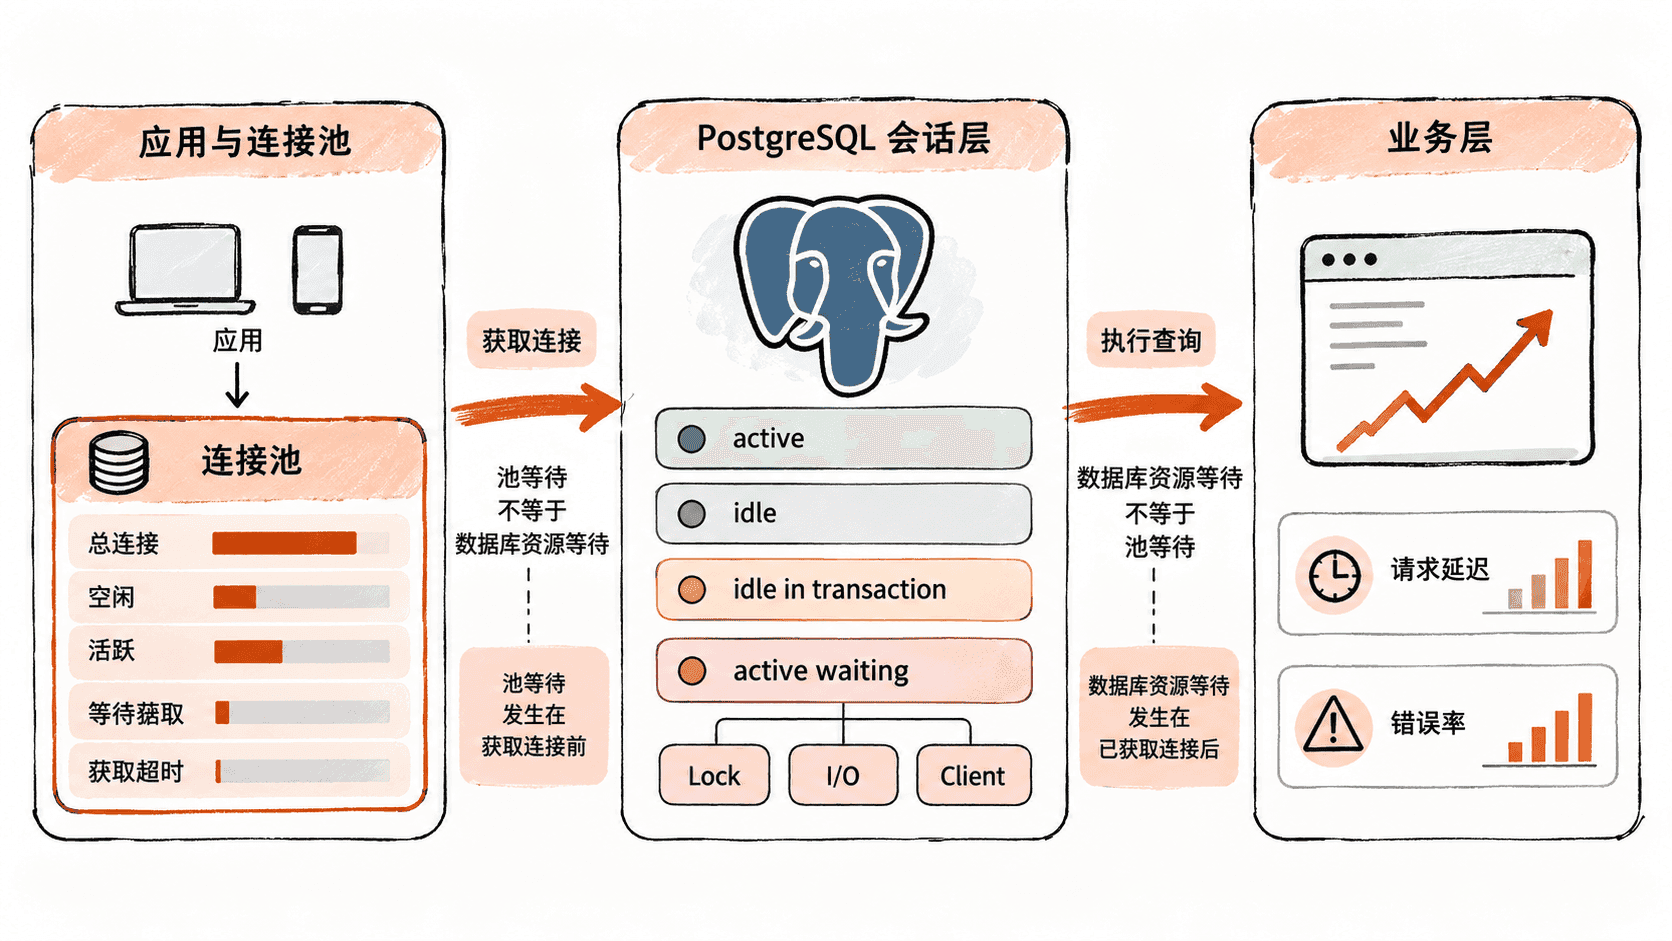
池层至少记录当前总连接数、空闲连接数、活跃连接数、等待获取连接的请求数,以及获取连接超时次数。不同连接池的命名可能不同,但这些语义应保持一致。
“池命中情况”不要只做一个模糊的 hit ratio。更实用的是同时记录成功获取次数、创建物理连接次数、等待获取次数和获取超时次数,这样才能判断连接是被复用、扩容,还是已经因容量不足发生排队。
PostgreSQL 侧看什么
数据库侧优先观察 pg_stat_activity 与 pg_stat_database。前者用于看每个会话的状态、等待类型和等待事件,后者用于辅助观察数据库级工作量与连接相关活动。监控时不要只看连接总数,还要区分 active、idle、idle in transaction,以及处于等待状态的活跃会话。
注意,wait_event 非空不能直接等价于“数据库内部资源竞争”。普通 idle 会话等待客户端发送下一条请求时,也可能出现 ClientRead。因此更适合单独统计“活跃且正在等待”的会话,再按 wait_event_type 和 wait_event 分类判断是锁、I/O 还是客户端通信等待。
SELECT
  count(*) AS total_sessions,
  count(*) FILTER (WHERE state = 'active') AS active_sessions,
  count(*) FILTER (WHERE state = 'idle') AS idle_sessions,
  count(*) FILTER (WHERE state = 'idle in transaction') AS idle_in_transaction,
  count(*) FILTER (WHERE state = 'active' AND wait_event IS NOT NULL) AS active_waiting_sessions,
  count(*) FILTER (WHERE state = 'active' AND wait_event_type = 'Lock') AS active_lock_waiters
FROM pg_stat_activity
WHERE datname = current_database();
预期结果
 total_sessions | active_sessions | idle_sessions | idle_in_transaction | active_waiting_sessions | active_lock_waiters
----------------+-----------------+---------------+---------------------+-------------------------+--------------------
<N> | <N> | <N> | <N> | <N> | <N>实际数字会随业务流量变化;重点是区分“会话在等待客户端”与“活跃会话正在等待”,不要追求固定数值。active_waiting_sessions 也不等于数据库内部锁等待,它可能包含 I/O 或其他等待类型。
idle 通常表示会话当前没有执行语句,本身不等于异常。idle in transaction 则说明事务已经开始但当前没有执行语句,它可能长期持有事务快照或锁,因此应单独统计持续时间。
可以进一步找出已经处于 idle in transaction 的会话:
SELECT
  pid,
  usename,
  application_name,
  client_addr,
  now() - xact_start AS xact_age,
  state,
  wait_event_type,
  wait_event
FROM pg_stat_activity
WHERE datname = current_database()
  AND state = 'idle in transaction'
ORDER BY xact_start;
预期结果
 pid  | usename | application_name | client_addr | xact_age |         state         | wait_event_type | wait_event
------+---------+------------------+-------------+----------+-----------------------+-----------------+-----------
<PID> | <USER>  | <APP>            | <IP>        | <TIME>   | idle in transaction   | <TYPE>          | <EVENT>
这里的 <PID>、<USER>、<APP> 等值会因环境不同而变化。真正用于告警的应是“数量 + 最大事务年龄”,而不是某一个瞬时连接数。
把指标变成可行动信号
连接数本身不能直接说明故障。建议至少建立以下几组指标:池容量利用率、池等待数量、获取连接超时次数、数据库会话总量、idle in transaction 数量及最大事务年龄、活跃等待会话数量,以及池成功获取与物理建连的比例。
例如,池利用率可以表达为 ;但不要把高利用率直接定义成故障。持续高利用率且等待数同步上升,才说明池容量开始限制吞吐。获取超时则属于更强的信号,因为它已经说明请求无法在规定时间内拿到连接。
数据库等待也要按类型解释。Lock 等待持续增加时,应检查锁竞争;I/O 类等待持续升高时,应进一步观察存储和查询负载;若主要是 Client 类等待,则不能仅凭这个指标认定数据库内部资源耗尽。
告警最好采用组合条件。例如“等待请求持续存在 + 获取超时持续增加”优先判断连接池容量或连接归还异常;“池等待不高 + 活跃锁等待快速增加”则更应检查数据库内部资源竞争。这样的组合比单独对连接数设置阈值更可靠。
监控口径要保持一致
同一套指标必须明确统计窗口、采样周期和维度。池指标至少按实例记录,数据库指标至少按数据库记录;同时保留应用名或连接池名,才能在故障时从“哪个数据库有问题”继续定位到“哪个应用池正在耗尽”。
最终,连接监控的核心不是做一张漂亮的图,而是建立从“连接池拿不到连接”到“PostgreSQL 活跃会话正在等待什么”的证据链。只要池等待、获取超时、会话状态、等待类型和事务年龄可以互相对照,后续的容量调整、故障止损和复盘才有可靠依据。