
PostgreSQL / 系统课时
区分连接数与并发请求
区分连接数与并发请求
这节解决一个常见误判:请求数很高,不代表 PostgreSQL 必须同时建立同样多的连接。最终要能用池化复用把业务并发、连接占用和数据库执行并发拆开观察。
学习目标
- 区分业务请求并发、连接池连接数和数据库实际执行并发
- 理解连接复用为什么能降低连接建立与数据库连接槽位压力
- 能用 PostgreSQL 运行时视图验证“连接多但执行并发低”的场景
三个数量不是一回事
业务并发描述同时到达或等待处理的请求数量;连接池连接数描述应用持有的数据库连接数量;数据库执行并发描述此刻真正占用数据库执行资源的连接数量。三者只有在极简单的同步模型下才会接近。
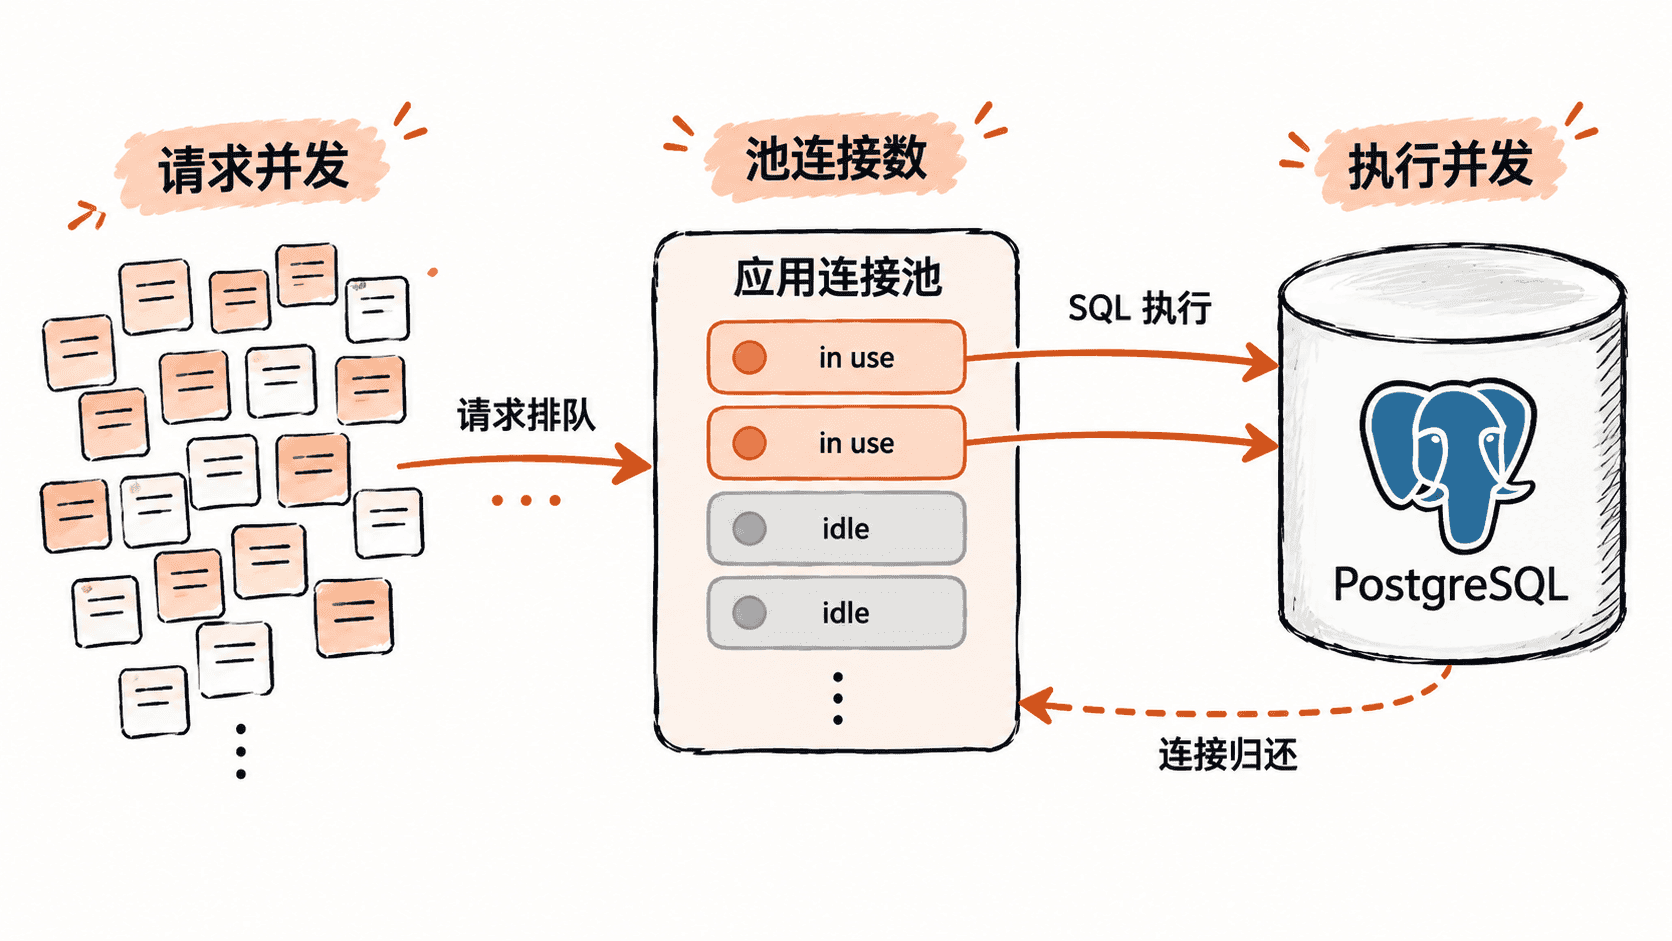
例如,一个服务同时有 200 个 HTTP 请求,其中只有 20 个请求进入数据库阶段,而连接池最大连接数是 30,那么数据库连接槽位最多主要受这 30 个池连接约束,并不需要为 200 个请求各建立一个连接。若其中只有 5 个请求正在执行 SQL,另外 15 个连接处于空闲或等待事务边界,数据库执行并发仍可能只有 5。
这里最容易混淆的是“连接存在”和“连接正在工作”。连接可以长期保持打开,以便后续请求复用;它也可以处于空闲状态,并不持续消耗一个等价于 SQL 执行的计算并发槽位。真正需要重点关注的是活跃连接、等待中的连接以及长时间占用连接的请求。
用 PostgreSQL 观察实际连接状态
可以直接从 pg_stat_activity 看当前服务端连接及其状态。下面的查询按数据库和连接状态统计,用于建立连接容量基线。
SELECT
  datname,
  state,
  count(*) AS connections
FROM pg_stat_activity
WHERE datname IS NOT NULL
GROUP BY datname, state
ORDER BY datname, state;
预期结果
datname   | state  | connections
----------+--------+------------
appdb     | active | 5
appdb     | idle   | 15
实际行数取决于当前负载和其他客户端;这里示例表达的是“20 个连接存在,但只有 5 个连接当前处于 active”。active 也不等于“CPU 正在持续执行”,它表示该连接当前有正在处理的查询,因此还要结合等待事件与 SQL 本身判断是否真正消耗了主要执行资源。
连接池为什么能解耦两者
连接池把“创建数据库连接”从每次请求的生命周期中抽离出来。请求到达后先获取一个已有连接;没有空闲连接时进入池内等待;SQL 完成并结束事务后归还连接,而不是关闭 TCP 连接。
因此,连接池解决的核心不是把数据库并发无限放大,而是用有限的连接复用大量短请求,并通过池大小给数据库施加一个应用侧并发上限。池越大,并不自动意味着吞吐越高;当数据库 CPU、锁或 I/O 已成为瓶颈时,继续增加连接反而可能放大上下文切换、锁竞争和排队成本。
典型的“连接多但执行并发低”场景
最常见的是流量平稳但连接池预热较充分:池已经打开较多连接,绝大部分处于 idle,只有少量请求正在访问数据库。另一个场景是业务请求包含大量非数据库工作,例如远程调用、序列化或缓存访问,连接只在短时间窗口内被借用。
因此治理连接容量时,不能只看“当前连接数”。至少应同时观察请求并发、池的 active/idle/waiting、数据库端 active/idle 连接,以及请求持有连接的时间。只有把这些数量放到同一条时间线上,才能判断问题究竟出在连接容量还是业务执行阶段。
最终判断标准很简单:请求并发回答“有多少请求”,连接池回答“有多少连接可复用”,数据库执行并发回答“此刻有多少连接真的在做事”。 三者必须分开测量,后续才能合理确定连接池上限。