
PostgreSQL / 系统课时
计算多实例连接放大
计算多实例连接放大
在单实例上设置的连接池上限,到了 Kubernetes 多副本环境会被同时复制。本文建立从副本数、每实例池大小到数据库总连接占用的计算方法,并用一个可执行例子判断部署是否会把数据库连接容量推到危险区间。
学习目标
- 能计算多实例连接池叠加后的理论最大连接数
- 能区分实例级池上限、数据库级连接上限和安全余量
- 能根据实例扩缩容结果反推合理的单实例池大小
先把连接放大算清楚
最基本的模型是:
其中 是实际运行的应用实例数, 是每个实例允许建立的连接池最大连接数。这个值表示应用侧可能同时占用的数据库连接总量,而不是“当前已经使用”的连接数。
例如 8 个 Pod,每个 Pod 的连接池上限是 30,那么理论最大连接数就是 。如果还有后台任务、管理工具或其他服务共享同一个 PostgreSQL,240 还不是完整容量需求。
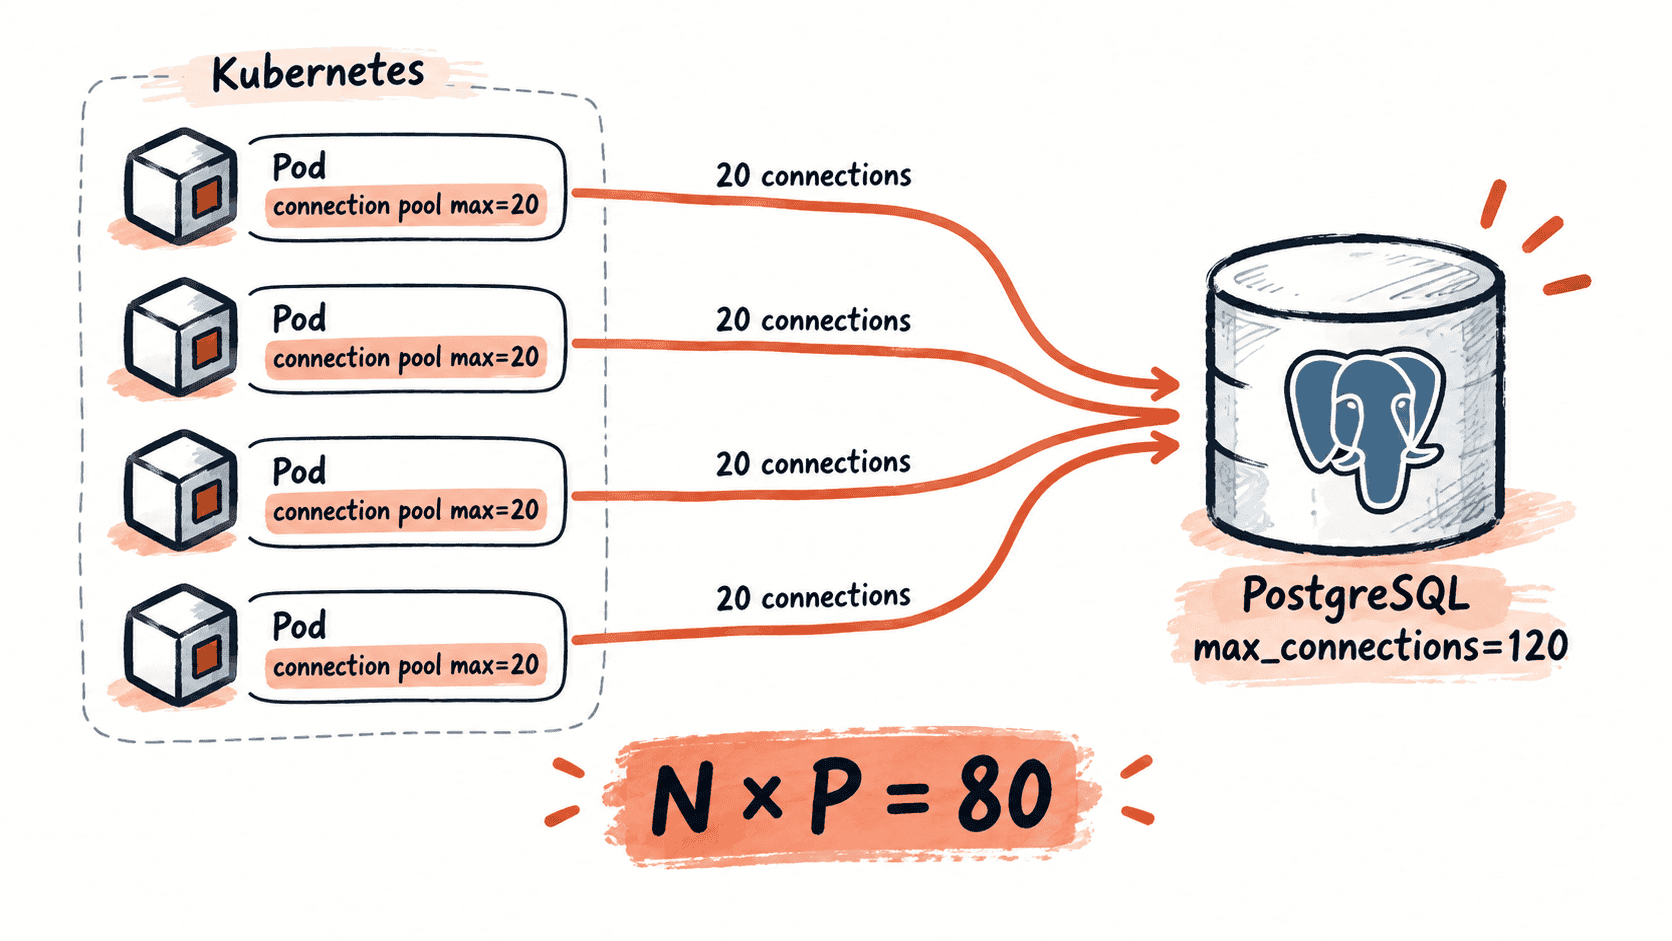
扩缩容会让容量动态变化
Kubernetes 环境里, 不是固定值。最容易忽略的是 HPA、滚动发布和故障重建都会短时间改变实例数量,因此不能只拿“平时 6 个 Pod”计算容量。
滚动发布期间,旧实例和新实例可能同时存在;如果旧版本有 6 个 Pod,新版本先扩到 6 个 Pod,再逐步缩减旧版本,某个时间窗口内可能同时出现约 12 个实例。此时连接池上限也会随实例数一起放大。
可以直接用一个最小脚本计算理论峰值,并把扩容后的结果一起算出来:
#!/usr/bin/env bash
set -euo pipefail

replicas="${1:-8}"
pool_max="${2:-30}"

total=$((replicas * pool_max))
printf 'replicas=%s pool_max=%s theoretical_max_connections=%s\n' "$replicas" "$pool_max" "$total"

rollout_replicas=$((replicas * 2))
rollout_total=$((rollout_replicas * pool_max))
printf 'rollout_replicas=%s rollout_theoretical_max_connections=%s\n' "$rollout_replicas" "$rollout_total"
预期输出
replicas=8 pool_max=30 theoretical_max_connections=240
rollout_replicas=16 rollout_theoretical_max_connections=480
这里的 480 不是说数据库一定会立刻建立 480 个连接,而是说明发布过程如果确实存在 16 个副本,应用侧允许的连接上限已经放大到 480。容量设计必须能覆盖这样的峰值,或者通过发布策略、连接池上限和数据库容量共同控制它。
别把理论最大值当成数据库全部预算
更完整的模型可以写成:
其中每个服务 都有自己的副本数和连接池上限; 是运维、管理和故障处理所需的连接; 是其他未纳入当前服务部署的客户端连接。
因此,不能只看到某个服务的“8×30=240”就直接配置 PostgreSQL 的 max_connections=240。数据库还需要给其他服务和治理操作留下空间,而且实际连接数还受到池实现、事务持续时间和连接建立策略影响。
用数据库侧数据校验假设
计算完成后,应当用数据库实际连接数据反查模型。下面的查询可以按应用名查看当前连接数;连接建立时应通过连接参数设置稳定的 application_name,例如 orders-api。
SELECT
    application_name,
    COUNT(*) AS connections
FROM pg_stat_activity
WHERE backend_type = 'client backend'
GROUP BY application_name
ORDER BY connections DESC;
预期结果
 application_name | connections
------------------+------------
 orders-api       |         37
 billing-worker   |          9
 psql             |          2
(3 rows)
这张表只能反映当前快照,不能替代理论峰值计算。容量治理真正关注的是“实例数变化后,连接池理论上最多能扩到多少”,再用运行数据确认实际行为是否符合预期。
反推单实例池大小
当数据库允许分配给某个服务的连接预算为 ,预计最多运行 个实例时,可以先得到单实例预算:
例如服务最多 10 个实例,预算为 100 个数据库连接,那么单实例连接池上限不应超过 10。若发布或弹性伸缩可能临时达到 12 个实例,就应按 12 个实例重新计算,而不是继续沿用 10×10 的旧模型。
真正稳健的连接容量模型,核心不是“每个 Pod 配多少连接”,而是把副本数、每实例池上限、滚动发布峰值以及其他客户端放进同一个总量模型。只要实例数翻倍而池上限不变,理论连接容量就会同步翻倍。