
PostgreSQL / 系统课时
治理连接泄漏
治理连接泄漏
本课解决“连接已经建立,却没有被正确归还”的问题。最终要形成一条可验证的闭环:发现长期占用连接,定位异常路径,修复事务与连接生命周期,再用超时和监控机制阻止同类问题持续扩大。
学习目标
- 能区分连接未归还、事务未结束与慢查询造成的长期占用。
- 能设计带超时、异常回收和日志标识的连接使用方式。
- 能使用 PostgreSQL 会话信息定位疑似泄漏连接。
先区分真正的泄漏
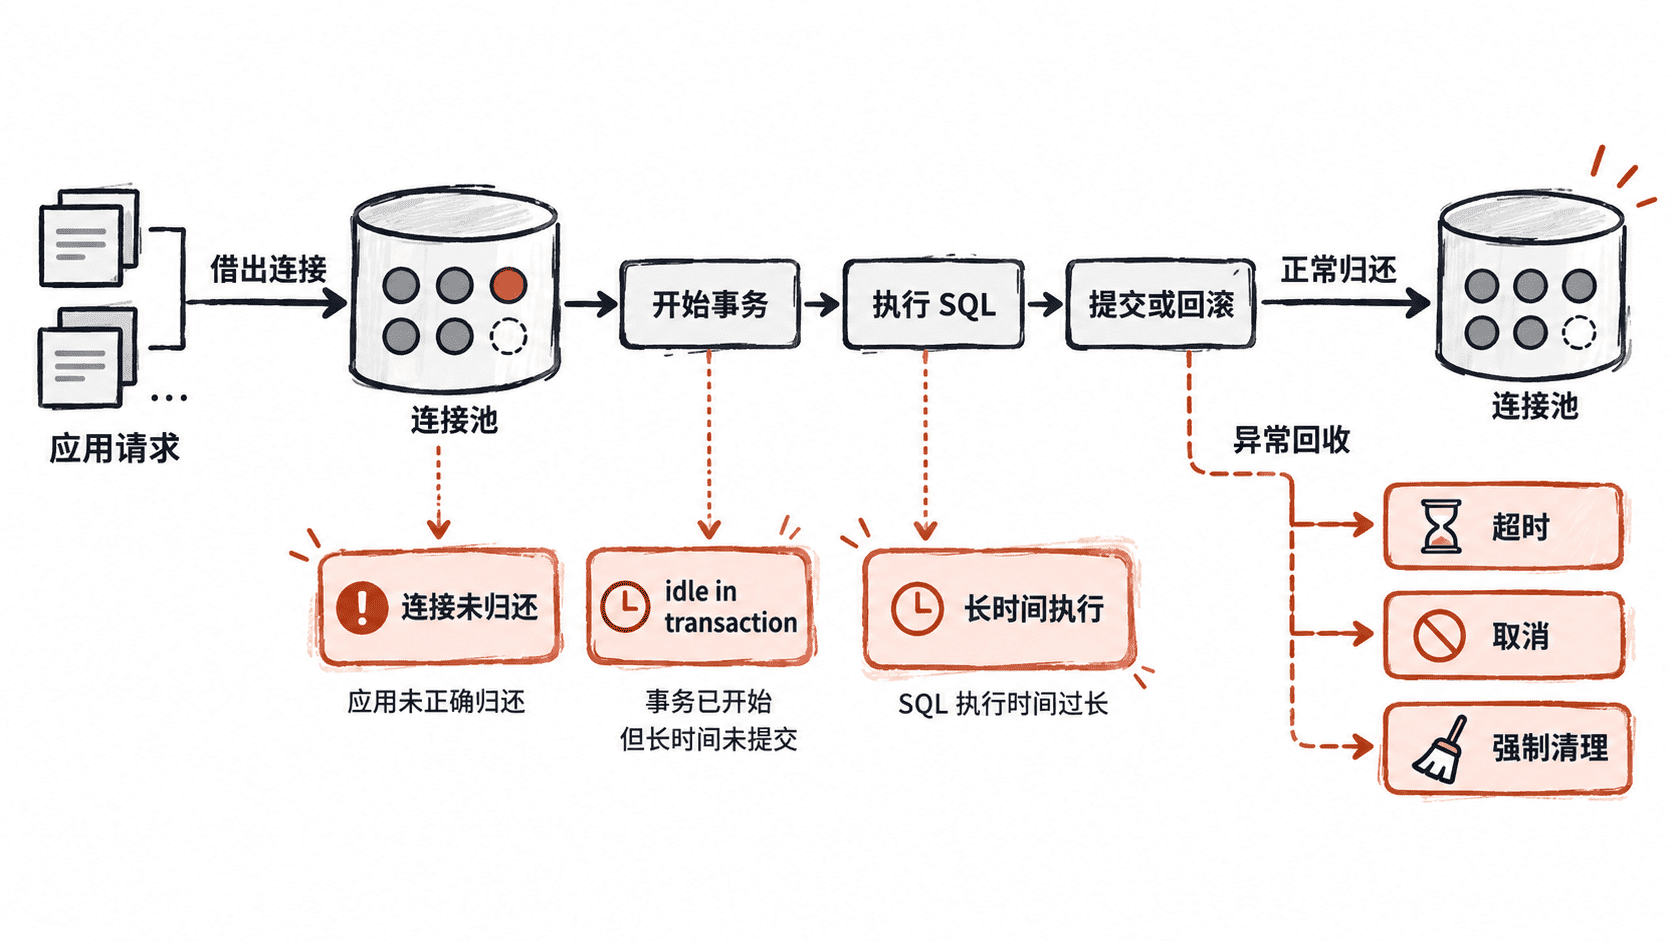
连接池中的连接通常会在业务代码借出后返回池中。所谓连接泄漏,是应用借出连接后没有按预期归还,导致连接长期脱离可复用状态,并最终把池容量逐步吃光。
不要把所有长时间存在的数据库会话都叫作泄漏。一个正常的空闲连接可能只是池为了复用而保留;一个 idle in transaction 会话则意味着事务没有结束,它不一定是“连接没归还”,但同样可能长期占用数据库资源并阻碍清理。
因此排查时应同时看三个维度:连接池是否归还、事务是否结束、SQL 是否仍在执行。只有把这三层区分开,才能避免错误回收正常连接。
在应用侧建立归还闭环
最可靠的方式是让连接归还动作与代码作用域绑定,而不是依赖开发人员记住“最后一定要 close”。不同语言的 API 名称不同,但设计原则一致:借出连接后,正常路径和异常路径都必须进入归还逻辑;事务结束后也必须进入明确的提交或回滚路径。
下面用 Python psycopg 展示一个片段示例。它依赖已经创建的连接池对象 pool,重点演示资源作用域,而不是完整应用框架。
from psycopg_pool import ConnectionPool

pool = ConnectionPool("postgresql://app:<PASSWORD>@db:<PORT>/app", open=True)


def create_order(order_id: int) -> None:
    # 上下文退出时负责释放连接,异常会触发事务回滚。
    with pool.connection() as conn:
        with conn.cursor() as cur:
            cur.execute(
                "INSERT INTO orders (id, status) VALUES (%s, %s)",
                (order_id, "CREATED"),
            )
预期结果
函数正常返回:事务提交,连接归还连接池
SQL 执行异常:事务回滚,连接仍归还连接池
这里的关键不是具体语法,而是让“归还连接”成为作用域生命周期的一部分。使用手工 getconn() 与 putconn() 时,也必须保证所有异常路径都执行归还,否则一次异常就可能永久占住池中的一个槽位。
用数据库会话定位疑似泄漏
连接池报警时,不要直接从应用日志猜原因。先在 PostgreSQL 查看会话状态、事务开始时间和当前查询,确认连接到底卡在哪个阶段。
SELECT
    pid,
    usename,
    application_name,
    state,
    xact_start,
    query_start,
    now() - xact_start AS transaction_age,
    now() - query_start AS query_age,
    left(query, 120) AS query
FROM pg_stat_activity
WHERE backend_type = 'client backend'
ORDER BY transaction_age DESC NULLS LAST, query_age DESC NULLS LAST;
预期结果
 pid  | usename  | application_name | state               | transaction_age | query_age | query
------+----------+------------------+---------------------+-----------------+-----------+-------------------------
 <PID>| app_core | api-core         | idle in transaction | <TIME>          |           | UPDATE orders ...
 <PID>| app_core | api-core         | active              | <TIME>          | <TIME>    | SELECT ...
 <PID>| app_core | api-core         | idle                |                 |           | COMMIT
idle 本身并不代表泄漏;真正值得优先调查的是长时间 idle in transaction、异常长的 active,以及应用侧已经报告池耗尽但数据库侧存在对应长期会话的情况。xact_start 为空时,不应据此判断连接一定泄漏。
为泄漏设置兜底机制
应用层修复后还需要数据库与连接池共同提供保险。池侧可以设置获取连接的等待超时,让请求在连接资源耗尽时快速失败,而不是无限等待。数据库侧则可以使用 idle_in_transaction_session_timeout 限制长期处于事务空闲状态的会话。
例如,在明确允许的应用角色或会话范围内设置事务空闲超时:
SET idle_in_transaction_session_timeout = '60s';预期结果
SET这个设置针对的是 idle in transaction,不是正在执行的长查询,也不是普通 idle 连接。因此它不能代替应用侧连接归还机制,更不能作为所有连接泄漏问题的统一解决方案。
生产环境还应记录连接借出时间、归还时间、池名称、请求标识和数据库 application_name。当池使用率持续升高时,可以把“借出后持续多久未归还”作为应用侧证据,再与 pg_stat_activity 的 pid、事务年龄和查询状态交叉验证。
修复后的验证方式
修复不能只看“报警消失”。应重新制造一次原来的请求路径,确认异常分支执行后连接仍回到池中;随后观察池的活跃连接数是否恢复,以及数据库中是否还出现持续增长的长期会话。
一个实用的验收标准是:正常请求完成后,池中可用连接恢复到稳定区间;异常请求不会永久减少池容量;长事务和长查询有独立的超时或治理策略;监控能够提供足够的标识把应用请求与 PostgreSQL 会话对应起来。
连接泄漏治理的核心不是“定期杀连接”,而是让连接、事务和请求拥有明确的生命周期,并为异常路径设置可观测、可超时、可回收的兜底边界。