
PostgreSQL / 系统课时
设计多级分区与合理粒度
设计多级分区与合理粒度
按月分区后,一部分租户查询仍然扫描大量数据,才有必要评估第二层。本课建立“月份加租户 HASH”的最小层级,计算对象数量与查询触达范围,验证多级裁剪,并说明何时单层配合索引更合适。
学习目标
- 创建 RANGE 与 HASH 组成的两级分区
- 按月数和桶数估算叶子与索引数量
- 用真实查询条件验收第二层是否有收益
为两层各指定一个用途
假设事件保留 24 个月,按月整批下线;热点查询通常同时给出月份和 tenant_id。第一层 RANGE 服务生命周期,第二层 HASH 把同月租户分布到固定数量的桶。HASH 桶不是 tenant_id 除以桶数的余数,而是数据库对键计算哈希后的路由。
在 PostgreSQL 18 独立练习库执行以下完整示例;只建一个月、两个桶,便于看清层级。
CREATE TABLE tenant_events_lab (
    tenant_id bigint NOT NULL,
    occurred_on date NOT NULL,
    id bigint NOT NULL
) PARTITION BY RANGE (occurred_on);

CREATE TABLE tenant_events_lab_202601 PARTITION OF tenant_events_lab
FOR VALUES FROM ('2026-01-01') TO ('2026-02-01')
PARTITION BY HASH (tenant_id);

-- 两个余数完整覆盖该月 HASH 路由。
CREATE TABLE tenant_events_lab_202601_h0
PARTITION OF tenant_events_lab_202601 FOR VALUES WITH (MODULUS 2, REMAINDER 0);
CREATE TABLE tenant_events_lab_202601_h1
PARTITION OF tenant_events_lab_202601 FOR VALUES WITH (MODULUS 2, REMAINDER 1);

INSERT INTO tenant_events_lab VALUES
(10, '2026-01-10', 1), (11, '2026-01-11', 2);
SELECT relid::regclass AS relation, parentrelid::regclass AS parent,
       isleaf, level
FROM pg_partition_tree('tenant_events_lab')
ORDER BY level, relid::regclass::text;
预期结果:共 4 个节点,根表 level=0、月份节点 level=1、两个叶子 level=2。数据实际存储在叶子表。层级检查函数见 系统信息函数参考。
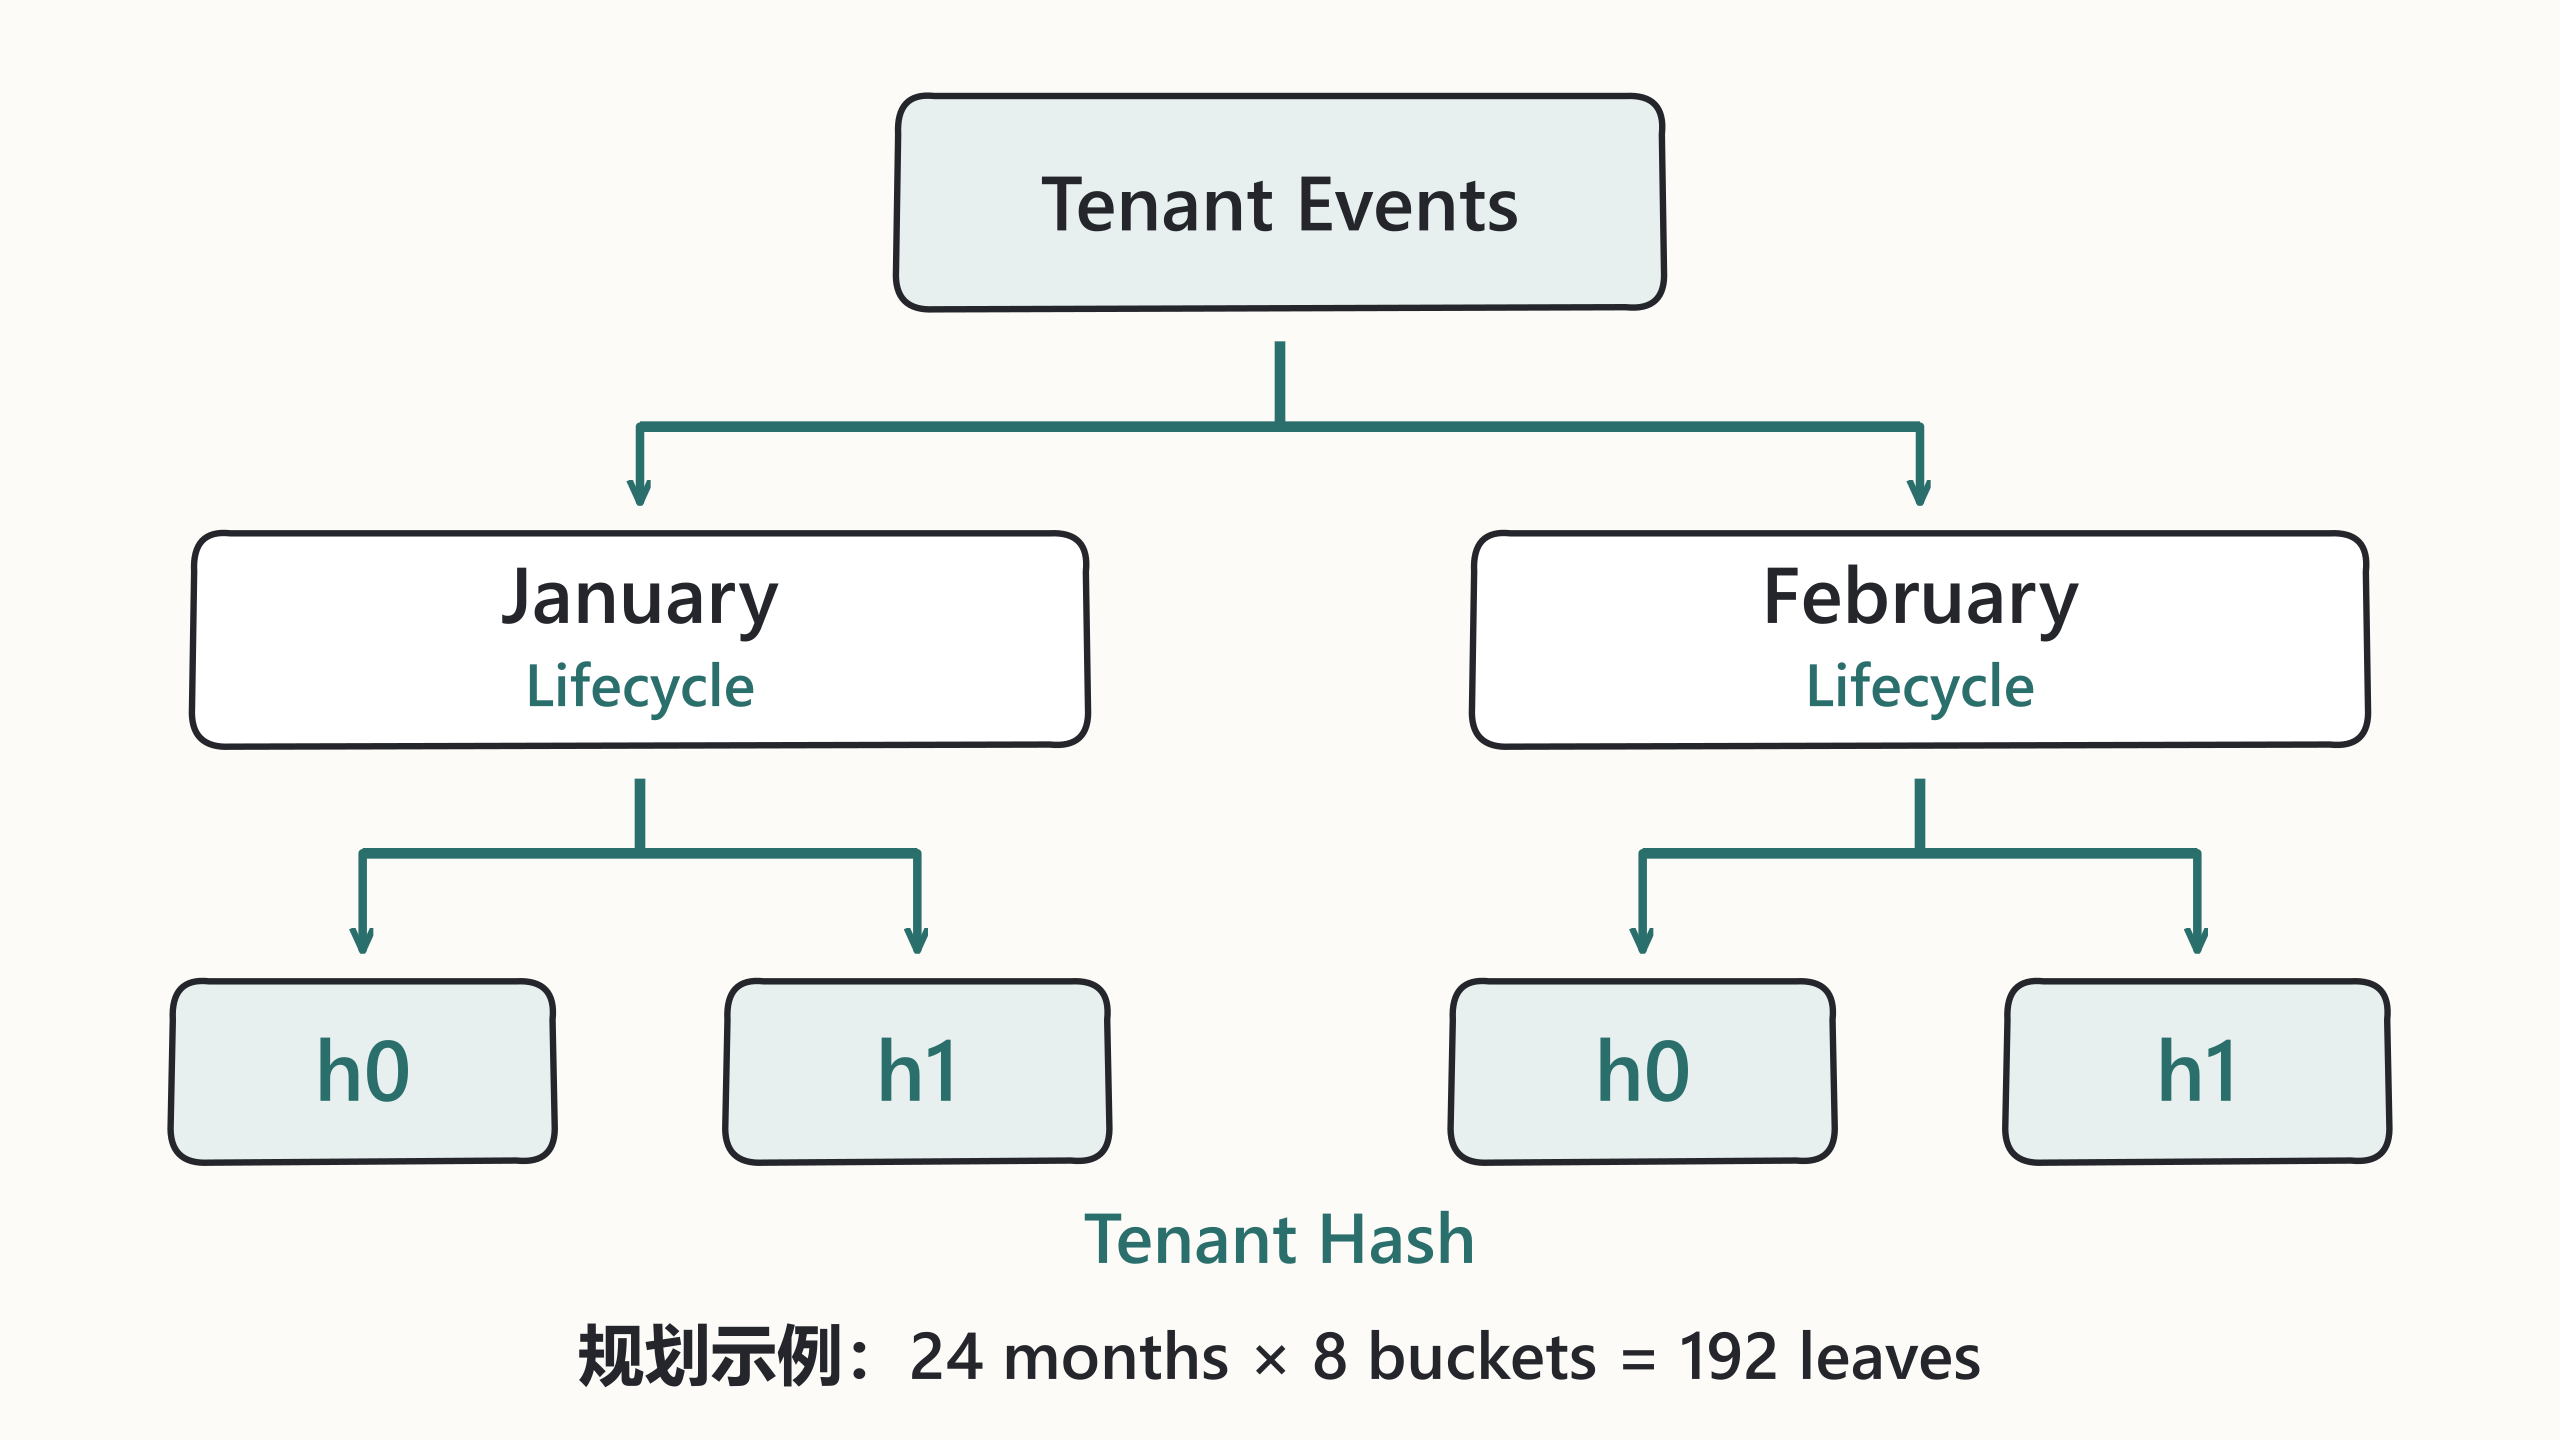
用对象总量约束桶数
24 个月乘以 8 桶是 192 个叶子,加 24 个月份节点和 1 个根,共 217 个表节点。每个叶子若有 3 个索引,至少要管理 576 个实际索引。把桶数改成 32 后,叶子变为 768 个,备份、目录访问和维护任务也随之增加。
桶数应由热点工作集、单叶子大小与维护时间预算决定。单个超大租户始终落在一个桶,增加桶数不会把这个租户均匀拆散;租户倾斜问题不能靠桶数无限增长解决。分区也不会自动让所有查询获得并行收益。
让查询同时提供两层条件
EXPLAIN (COSTS OFF)
SELECT id FROM tenant_events_lab
WHERE occurred_on >= DATE '2026-01-01'
  AND occurred_on < DATE '2026-02-01'
  AND tenant_id = 10;
预期结果:计划只访问包含 tenant_id=10 的一个一月叶子,具体 h0 或 h1 不预先猜测。去掉 tenant_id 条件后,一月两个桶都可能需要扫描;去掉月份条件后,每个月仍可能有一个匹配桶。验收不能只看 SQL 返回正确,还要记录实际访问叶子数。
在单层方案旁边做对照
若查询大多跨全部租户做月报,第二层很难减少访问范围,单层月分区加合适索引可能更简单。若每月只有几千行,拆成几十个桶往往把数据维护变成对象维护。
对比时固定数据分布、索引和业务 SQL,分别记录 Planning Time、Execution Time、缓冲读取和索引维护耗时。迁移现有层级涉及新表、数据搬迁与路由切换,不能假设修改 MODULUS 就能原地重分配。只有第二层解决了可测的瓶颈,才把它写入长期维护方案。