
PostgreSQL / 系统课时
设计 RANGE 时间分区
设计 RANGE 时间分区
按月归档的事件表,需要让一月数据与二月数据准确落到不同分区。本课确定时间类型和边界,用三条跨月数据验证路由,再把分区周期与查询范围、保留期限连接起来,避免上线后才发现下个月无处写入。
学习目标
- 用左闭右开边界建立月度 RANGE 分区
- 验证跨月时间与实际目标分区
- 根据查询和保留需求选择时间粒度
先统一时间口径
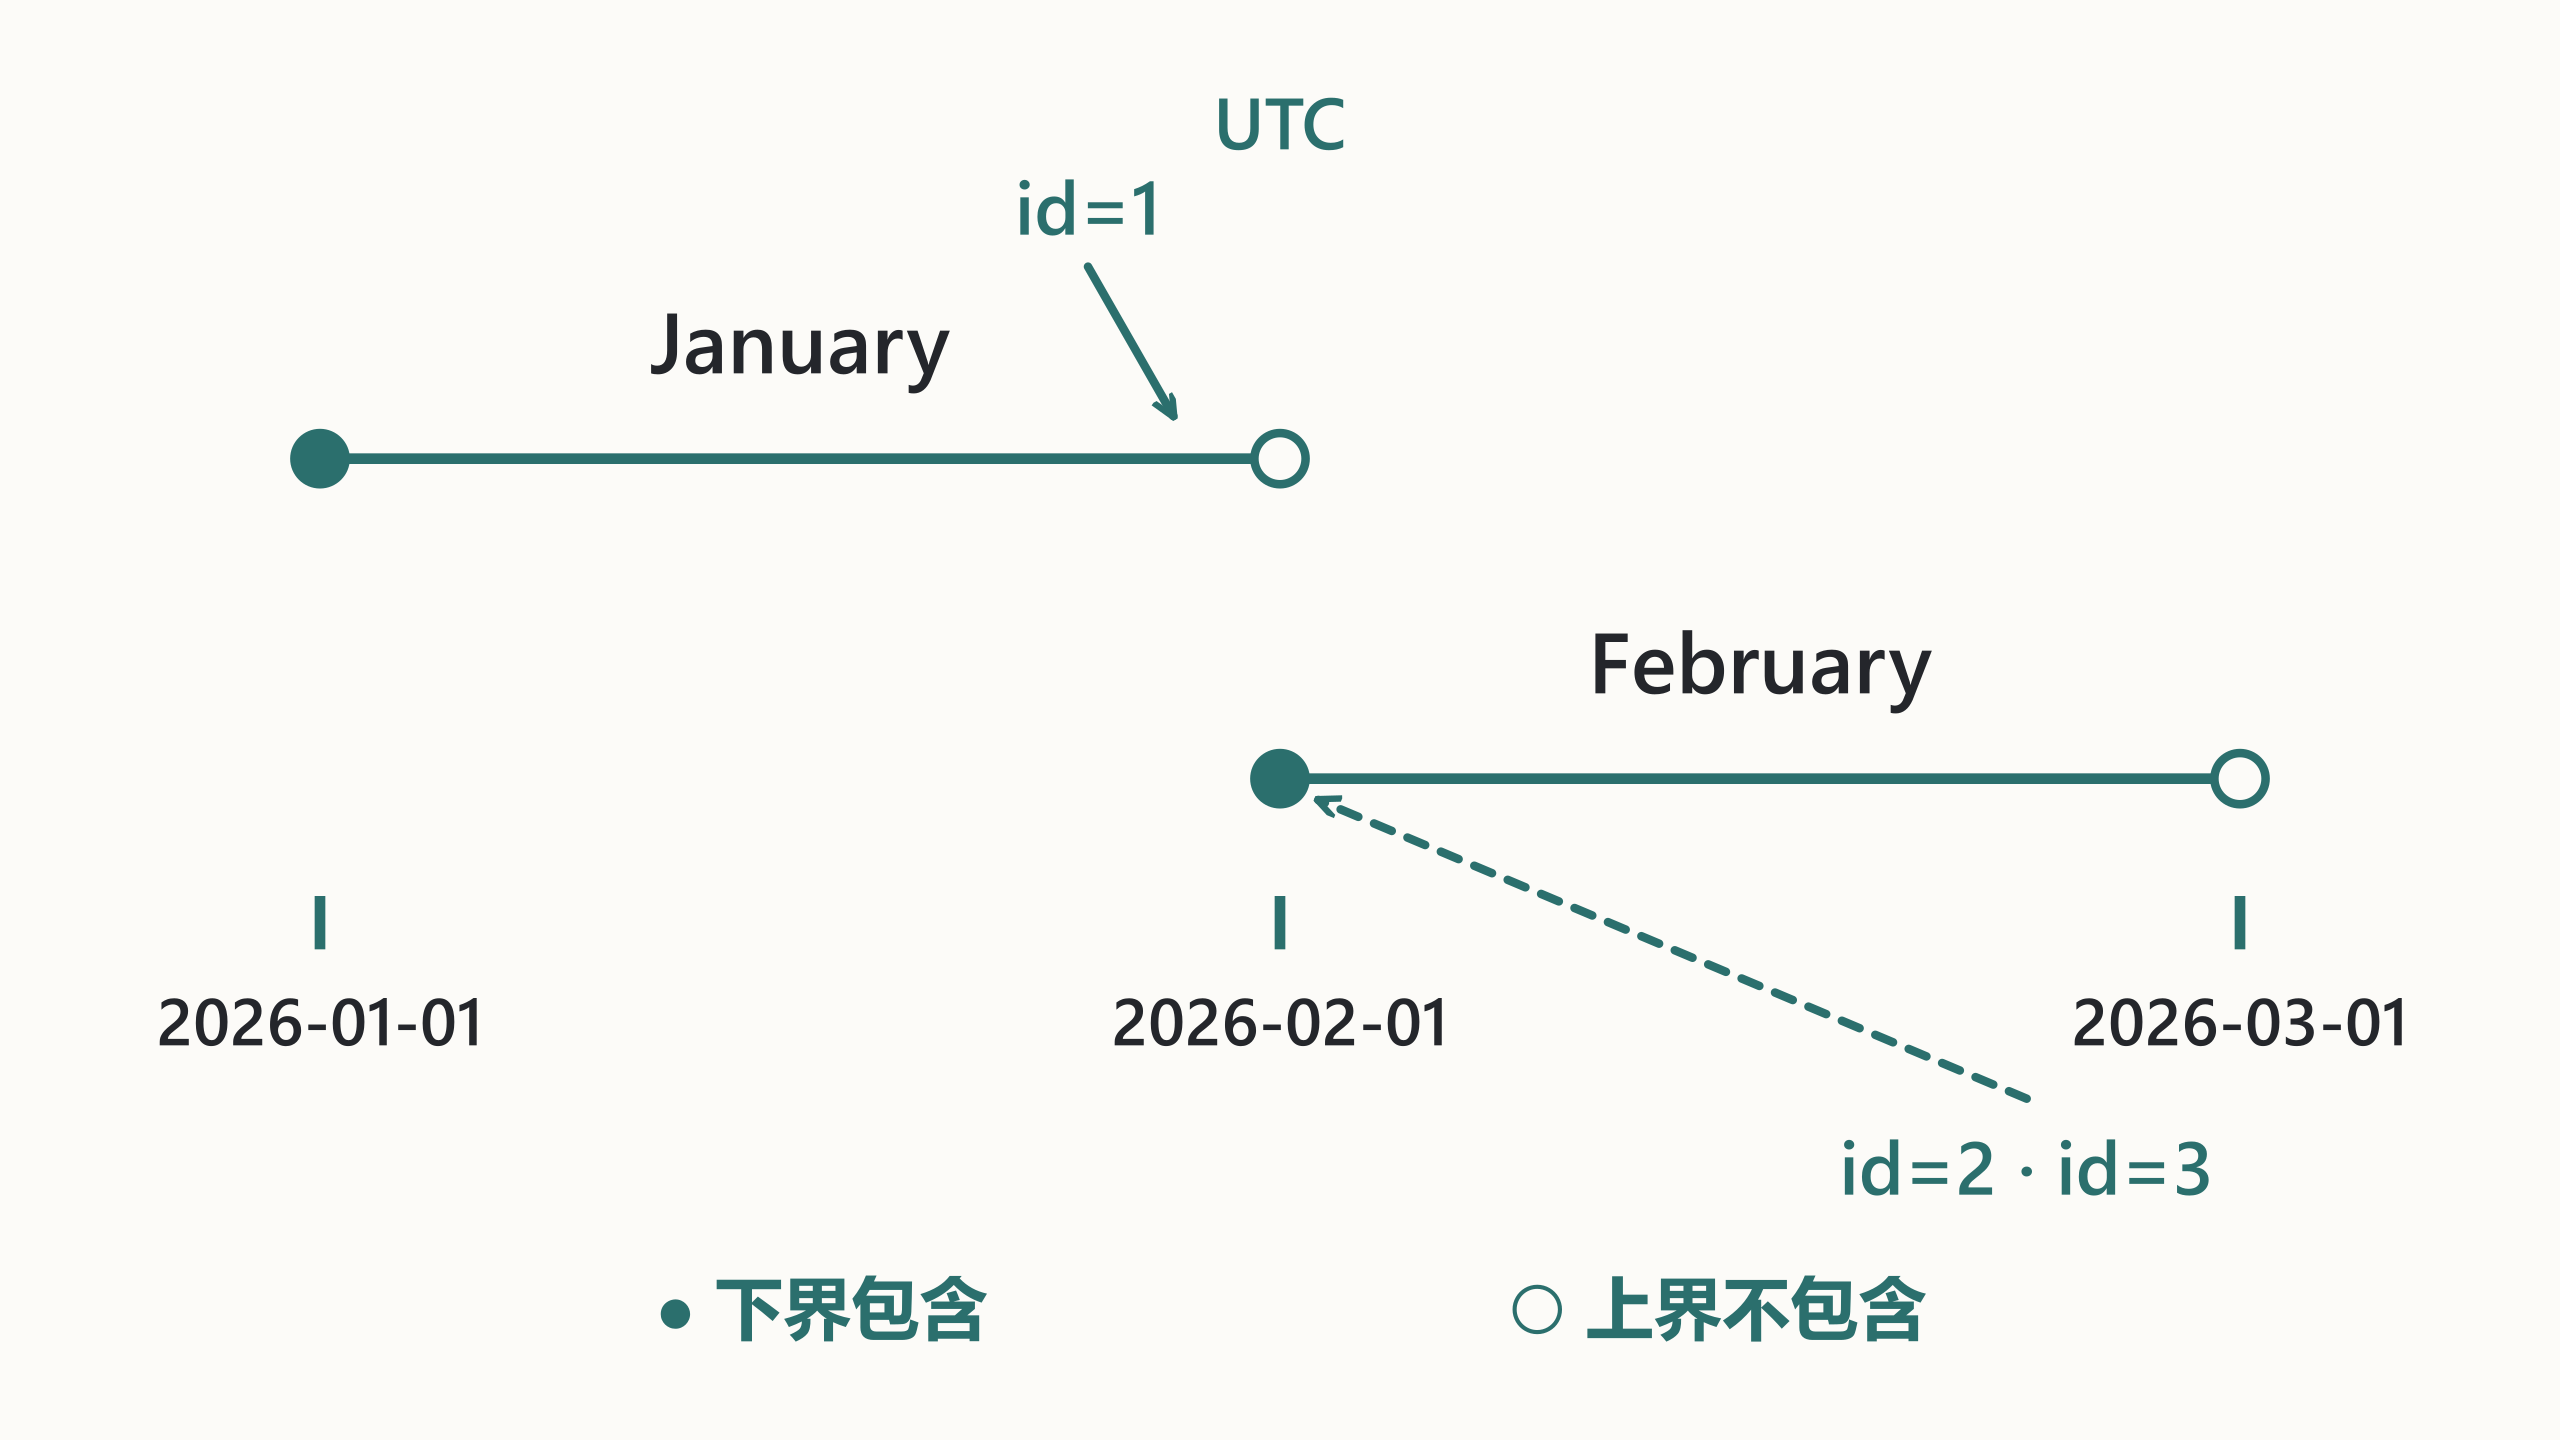
示例在 PostgreSQL 18 的独立练习数据库执行。事件记录时间点,使用 timestamptz;分区按 UTC 自然月划分。边界字面量明确写 +00,避免连接的 TimeZone 改变边界含义。业务若按北京时间月末结算,应先明确其对应时间点,不能混用 UTC 月与本地月。
CREATE TABLE range_events_lab (
    id bigint NOT NULL,
    occurred_at timestamptz NOT NULL,
    payload text,
    PRIMARY KEY (id, occurred_at)
) PARTITION BY RANGE (occurred_at);

-- 下界包含,上界不包含;两个月共用一个边界。
CREATE TABLE range_events_lab_202601 PARTITION OF range_events_lab
FOR VALUES FROM ('2026-01-01 00:00:00+00') TO ('2026-02-01 00:00:00+00');
CREATE TABLE range_events_lab_202602 PARTITION OF range_events_lab
FOR VALUES FROM ('2026-02-01 00:00:00+00') TO ('2026-03-01 00:00:00+00');

INSERT INTO range_events_lab VALUES
(1, '2026-01-31 23:59:59+00', 'january'),
(2, '2026-02-01 00:00:00+00', 'february'),
(3, '2026-02-01 08:00:00+08', 'same instant');
SELECT id, tableoid::regclass AS partition
FROM range_events_lab ORDER BY id;
预期结果:id=1 落到 range_events_lab_202601,id=2 和 id=3 都落到 range_events_lab_202602。后两条字面量表示同一个时间点,不应因为显示时区不同而分到不同月份。
父表上的主键包含 occurred_at,只保证这个组合唯一,不保证 id 跨月全局唯一。若业务必须保证单个 id 全局唯一,应单独设计 ID 分配或唯一性协调,不能把本例约束误读成全局索引。
把查询写成同样的区间
-- 与分区边界相同的半开区间,避免重复统计月初记录。
SELECT id FROM range_events_lab
WHERE occurred_at >= TIMESTAMPTZ '2026-02-01 00:00:00+00'
  AND occurred_at < TIMESTAMPTZ '2026-03-01 00:00:00+00'
ORDER BY id;
预期输出:id 为 2、3。BETWEEN 包含两端,若上界填下一月零点,会把下个月的边界记录也算进去。把分区键包装成 to_char 或日期提取表达式,也可能降低直接按边界裁剪的机会。
用维护单位选择粒度
假设每天 200 万行,保留 24 个月,主要查询最近 7 天、每月归档一次。月分区约 6000 万行、24 个叶子;日分区约 730 个叶子。日分区可以缩小单次维护单位,但会增加对象、索引和 DDL 管理数量;月分区可能已经满足按月摘除的需求。
先在代表性数据量上比较 7 天、1 个月和跨年的查询计划,再测单分区索引建立及归档耗时。不能只因“数据很多”就选最细粒度。RANGE 的基本规则见 分区表文档。
在下一个写入周期前验收
当前样例没有三月分区,三月写入会失败,数据库不会自动创建它。生产应提前准备未来分区,监控覆盖到的最大上界,并纳入迟到数据与保留期之外补录的处理规则。
DEFAULT 分区可以接住未匹配数据,但它会把缺分区问题变成兜底表增长问题;后续挂接分区还要处理其中冲突的数据。选择使用时必须同时设置兜底量告警和搬迁流程。验收至少包括月初、月末、等价时区时间点与缺失月份四类输入。