
PostgreSQL / 系统课时
使用分区级连接与聚合
使用分区级连接与聚合
分区裁剪只解决“少扫哪些分区”,分区级连接与聚合进一步决定“每个分区能否各自完成连接和计算”。本课用一组可运行 SQL 验证计划形态,并给出是否值得开启的判断标准。
学习目标
- 判断查询是否满足分区级连接与聚合的基本条件
- 用执行计划确认连接和聚合是否下沉到分区
- 在执行收益、规划时间与内存开销之间做取舍
什么时候值得分区级执行
enable_partitionwise_join 允许规划器把两个分区表的匹配分区分别连接;当前默认值为 off。要形成这种计划,连接条件需要包含全部分区键,分区键类型兼容,并且两侧子分区能够一一对应。enable_partitionwise_aggregate 同样默认关闭,它允许每个分区先做聚合;若 GROUP BY 不包含全部分区键,通常只能先做局部聚合,再在上层完成最终聚合。:contentReference[oaicite:0]{index=0}
这种优化最适合“同一分区策略的事实表互联”或“大范围扫描后聚合”。收益来自把一个大连接拆成多个更小的连接,让每个分区更早缩减行数;但它不是免费加速开关。扫描分区越多,计划节点也可能越多,规划 CPU、规划内存以及受 work_mem 约束的执行节点数量都可能上升。:contentReference[oaicite:1]{index=1}
连接与聚合如何下沉
下面的查询同时扫描订单和支付表的 8、9 月分区。开启分区级连接后,规划器可以先让 8 月订单只连接 8 月支付、9 月订单只连接 9 月支付;开启分区级聚合后,每个分区连接结果还可以先计算局部 count 和 sum,最后再汇总。
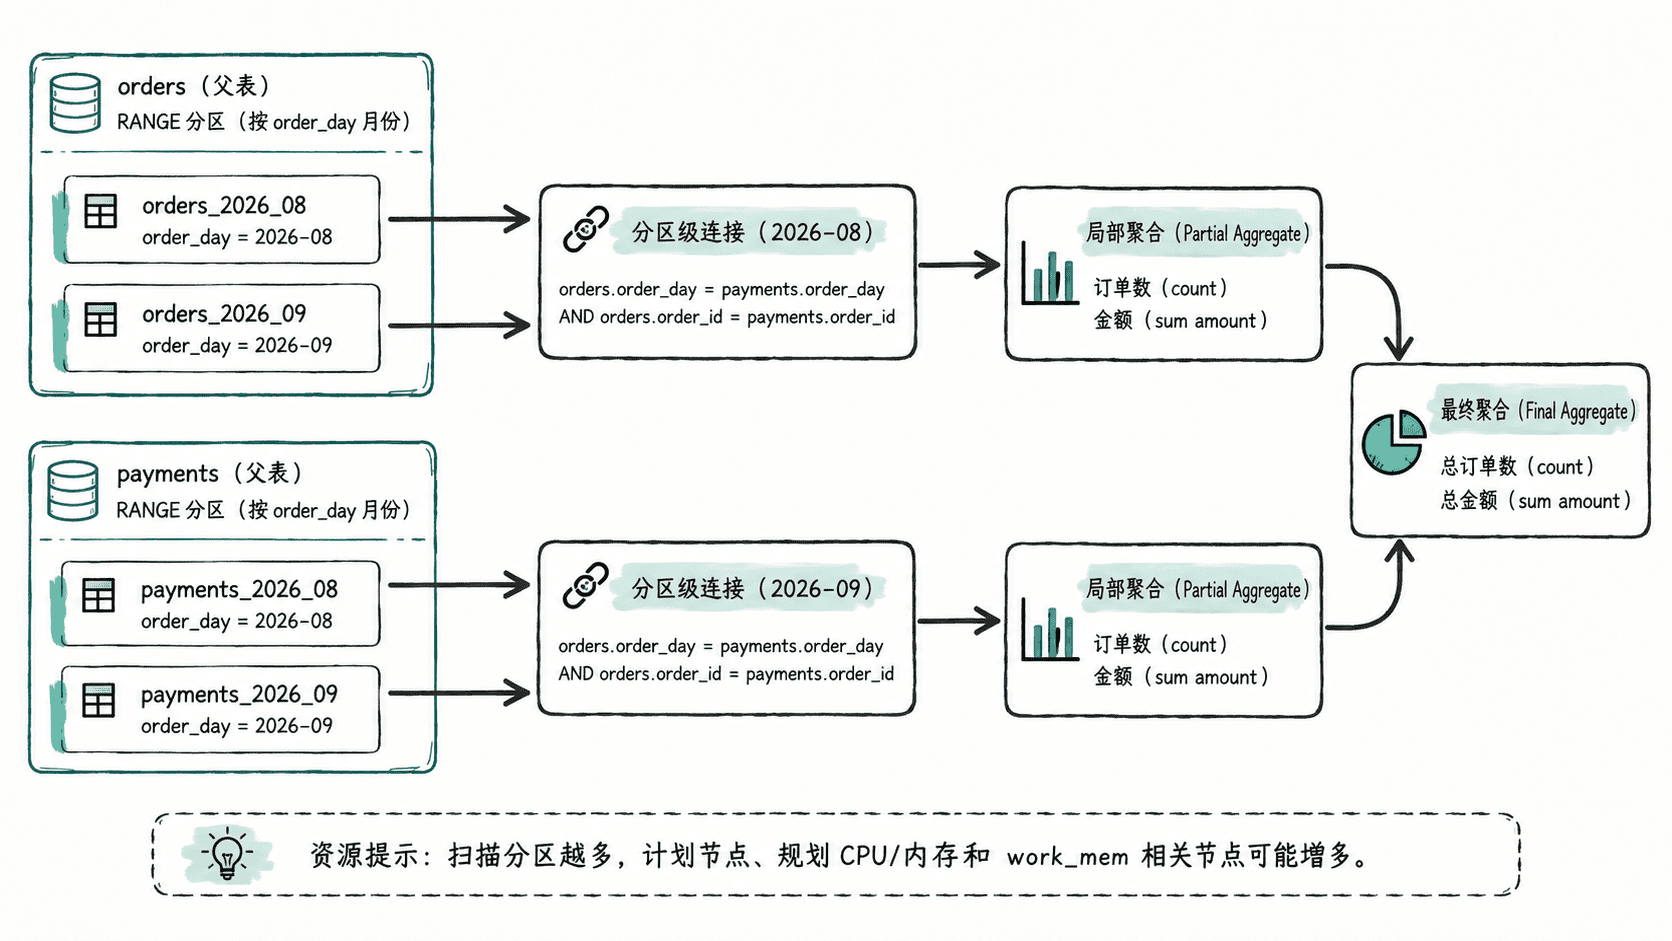
关键不是看到某个固定的 Join 算法,而是确认匹配分区被分别处理。每个分区内部究竟使用 Hash Join、Merge Join 还是 Nested Loop,仍由统计信息、索引和成本估算决定。
用执行计划验证
以下示例创建两张采用相同月分区边界的表。连接条件显式包含 order_day,这样规划器才有机会识别匹配分区。示例在事务内用 SET LOCAL 开启两个参数,避免影响其他会话。
CREATE TABLE pw_orders (
    order_id bigint NOT NULL,
    order_day date NOT NULL,
    amount numeric(12,2) NOT NULL
) PARTITION BY RANGE (order_day);

CREATE TABLE pw_orders_202608 PARTITION OF pw_orders
    FOR VALUES FROM (DATE '2026-08-01') TO (DATE '2026-09-01');
CREATE TABLE pw_orders_202609 PARTITION OF pw_orders
    FOR VALUES FROM (DATE '2026-09-01') TO (DATE '2026-10-01');

CREATE TABLE pw_payments (
    order_id bigint NOT NULL,
    order_day date NOT NULL,
    paid_amount numeric(12,2) NOT NULL
) PARTITION BY RANGE (order_day);

CREATE TABLE pw_payments_202608 PARTITION OF pw_payments
    FOR VALUES FROM (DATE '2026-08-01') TO (DATE '2026-09-01');
CREATE TABLE pw_payments_202609 PARTITION OF pw_payments
    FOR VALUES FROM (DATE '2026-09-01') TO (DATE '2026-10-01');

INSERT INTO pw_orders VALUES
    (1, DATE '2026-08-05', 100.00),
    (2, DATE '2026-08-20', 50.00),
    (3, DATE '2026-09-06', 80.00),
    (4, DATE '2026-09-18', 20.00);

INSERT INTO pw_payments VALUES
    (1, DATE '2026-08-05', 100.00),
    (2, DATE '2026-08-20', 50.00),
    (3, DATE '2026-09-06', 80.00),
    (4, DATE '2026-09-18', 20.00);

ANALYZE pw_orders;
ANALYZE pw_payments;

BEGIN;
SET LOCAL enable_partitionwise_join = on;
SET LOCAL enable_partitionwise_aggregate = on;

EXPLAIN (ANALYZE, BUFFERS, SETTINGS, SUMMARY, COSTS OFF)
SELECT count(*) AS paid_orders,
       sum(p.paid_amount) AS paid_amount
FROM pw_orders AS o
JOIN pw_payments AS p
  ON p.order_day = o.order_day
 AND p.order_id = o.order_id
WHERE o.order_day >= DATE '2026-08-01'
  AND o.order_day < DATE '2026-10-01';

SELECT count(*) AS paid_orders,
       sum(p.paid_amount) AS paid_amount
FROM pw_orders AS o
JOIN pw_payments AS p
  ON p.order_day = o.order_day
 AND p.order_id = o.order_id
WHERE o.order_day >= DATE '2026-08-01'
  AND o.order_day < DATE '2026-10-01';

ROLLBACK;
预期结果
EXPLAIN 的具体 Join/Aggregate 节点会随版本、统计信息和成本估算变化。
应重点看到 2026-08 与 2026-09 的匹配分区分别参与连接,并在上层完成最终汇总。

 paid_orders | paid_amount
-------------+-------------
           4 |      250.00
如果计划仍把两侧所有分区统一 Append 后再做一次大连接,先检查连接谓词是否遗漏分区键、两侧分区边界是否匹配,以及参数是否真的在当前事务中生效。
用规划成本决定是否开启
不要只比较 Execution Time。同一条代表性 SQL 应分别在两个参数关闭和开启时执行多次,比较 Planning Time、Execution Time、临时块、Hash/Sort 内存和并发下的总体吞吐。PostgreSQL 18 还可以给 EXPLAIN 增加 MEMORY 选项直接观察规划阶段内存;旧版本没有这一项时,应在压测环境结合进程内存监控判断。:contentReference[oaicite:2]{index=2}
决策时优先看“裁剪后实际会扫描多少分区”。只访问少量分区且每个分区数据量较大时,分区级执行更容易带来净收益;一次查询横跨数百个分区时,即使单个分区更快,规划和执行内存也可能抵消收益。生产环境更适合按工作负载在会话或事务级验证后再决定是否全局开启,而不是把两个参数当成固定的性能开关。