
PostgreSQL / 系统课时
判断大表是否值得分区
判断大表是否值得分区
分区不是“表一大就开”的性能开关。本课用查询裁剪、数据生命周期和运维成本三类信号判断是否值得分区,并给出一套可在现有表上采集基线、再决定是否进入分区设计的最小检查法。
学习目标
- 判断哪些工作负载能从分区裁剪和分区级维护中获益
- 用表规模与访问统计建立分区前基线
- 识别分区收益不足或约束代价过高的场景
先看分区能解决什么
值得分区的关键不是“行数很多”,而是数据天然存在稳定边界,并且查询或维护动作会反复利用这个边界。最常见的是按时间淘汰历史数据、按时间范围读取少量近期数据,或需要把冷数据从活跃数据中分离。
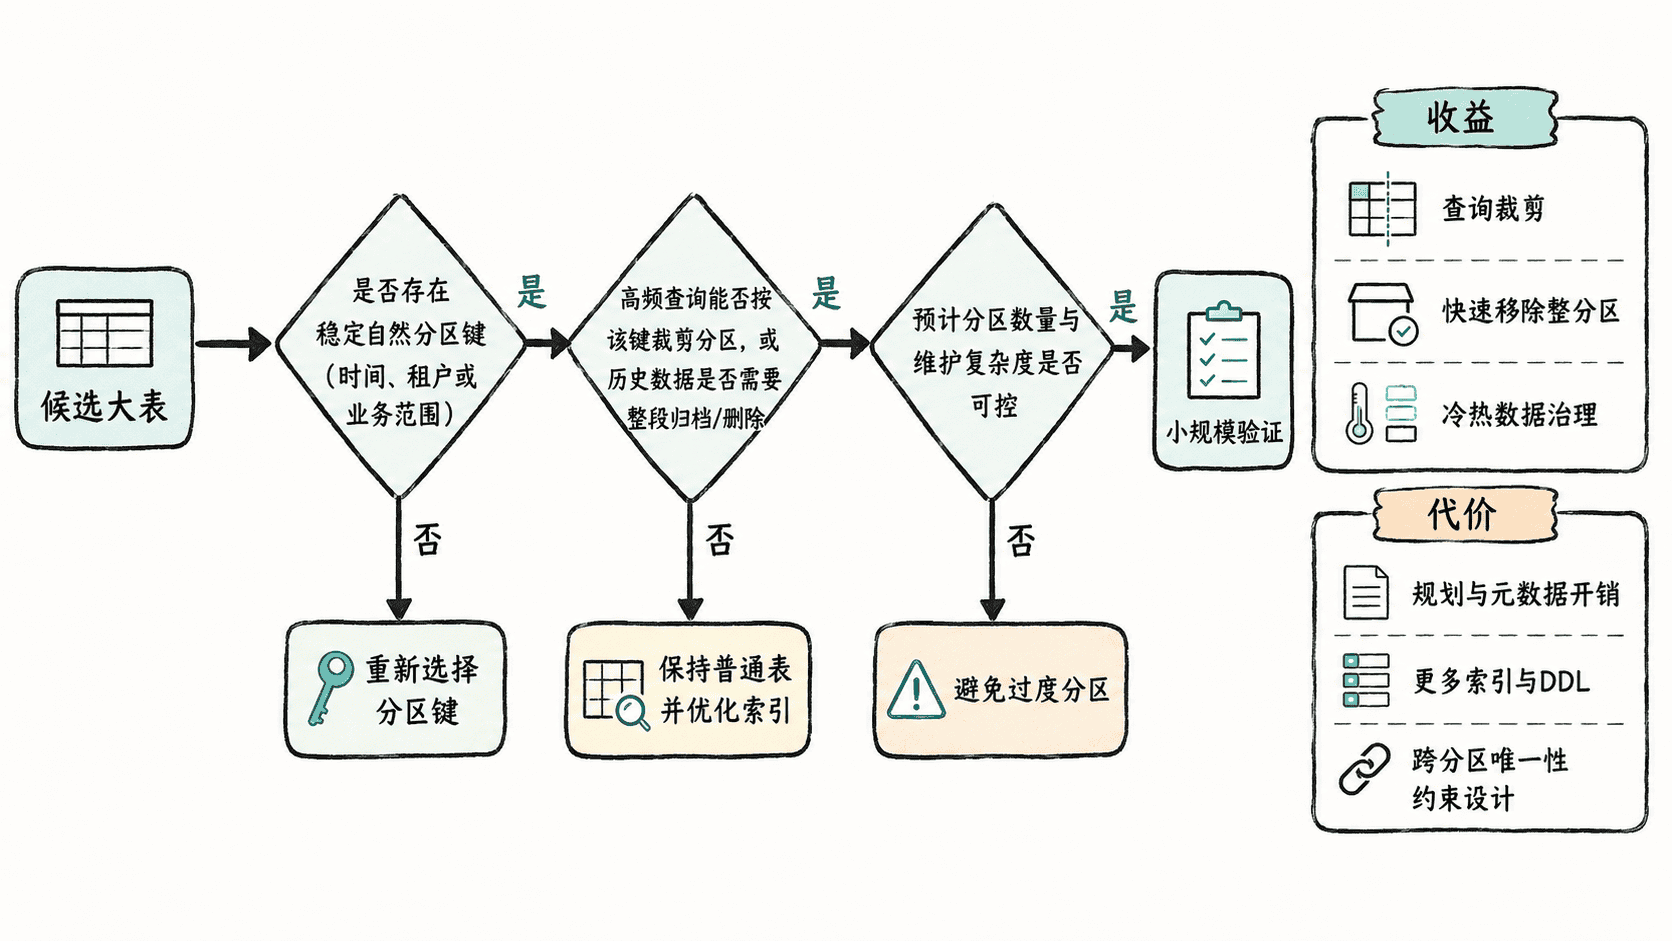
判断时重点看三类信号:高频查询是否总带候选分区键;历史数据是否成批归档、删除或迁移;单表及其索引是否已经让维护窗口、缓存命中或批量删除成本难以接受。只有表大而没有这些信号,分区往往只是把一个对象变成更多对象。
用现有表建立决策基线
先记录对象规模与访问统计,再结合真实 SQL 的过滤条件判断分区键。下面是片段示例,依赖现有表 public.events;如果你的表名不同,只替换两处表名,不要把某个固定行数或固定容量当成分区阈值。
SELECT
    pg_size_pretty(pg_total_relation_size('public.events')) AS total_size,
    s.n_live_tup,
    s.n_dead_tup,
    s.seq_scan,
    s.idx_scan
FROM pg_stat_user_tables AS s
WHERE s.relid = 'public.events'::regclass;
预期结果
 total_size | n_live_tup | n_dead_tup | seq_scan | idx_scan
------------+------------+------------+----------+----------
<VALUE> | <VALUE> | <VALUE> | <VALUE> | <VALUE>实际数值会随数据量、统计估算和统计计数器重置时间变化。total_size 用来观察表与索引的总体体量,n_live_tup 与 n_dead_tup 帮助判断活跃数据和更新删除压力,seq_scan、idx_scan 只能作为访问模式线索,不能单独证明“应该分区”。
下一步要把慢查询样本按过滤条件归类。若大多数关键查询都能限定到少量时间段,而候选分区键正是这个时间列,分区裁剪才有机会减少需要访问的分区;若查询总是按与分区键无关的随机键点查,普通索引通常更直接。
明确不该急着分区的场景
小表、索引已经能稳定满足点查、没有成批生命周期操作时,分区通常得不偿失。另一个危险信号是候选键无法稳定出现在查询条件中,此时分区数量增加了,查询却仍可能访问很多分区。
还要提前核对约束模型。声明式分区并不提供任意字段上的跨分区全局唯一性;如果业务依赖与分区键无关的唯一约束,就必须先重新设计约束或分区键,而不是先拆表再补救。
用三个闸门做最终决定
可以把决策收敛为三个闸门:存在稳定且可长期维护的分区键;至少有一个明确收益来源,即查询裁剪、整分区生命周期操作或冷热数据治理;预计分区数量、唯一约束和运维自动化成本可控。三个条件都成立,再进入分区方案设计和基准验证;否则继续保留普通表往往更稳妥。