
PostgreSQL / 系统课时
评估存量大表迁移方案
评估存量大表迁移方案
把存量普通大表迁成分区表,最容易出错的不是建表语法,而是迁移期间谁是事实来源、什么时候可以切换、失败后能退到哪里。本课先用可量化的检查项评估停机迁移、影子表迁移和复用现有表三类路径,再为后续实施划定明确的切换与回退边界。
学习目标
- 采集决定迁移方案的容量、写入、约束和依赖证据
- 根据停机容忍度与数据组织方式选择迁移路径
- 定义迁移各阶段的唯一事实来源和可执行回退条件
先把大表现状量化
PostgreSQL 不能把一张普通表原地转换成分区表,因此迁移至少需要一个新的分区化父表,或者先把现有普通表作为某个新父表的分区挂载。对于跨越多个目标区间的单体大表,通常仍要把数据拆到多个分区中。
评估前不要只看总行数。表体积决定复制窗口和磁盘余量,写入速率决定增量追平难度,主键与唯一约束决定分区键设计是否可落地,外键、触发器、RLS、生成列和应用 SQL 则决定切换是否只是“改表名”这么简单。
下面是片段示例,依赖数据库中已经存在 public.orders。统计计数来自 PostgreSQL 统计视图,适合做迁移评估,不应当成精确业务账。
SELECT
    c.oid::regclass AS table_name,
    pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size,
    s.n_live_tup AS estimated_live_rows,
    s.n_tup_ins AS inserts_since_stats_reset,
    s.n_tup_upd AS updates_since_stats_reset,
    s.n_tup_del AS deletes_since_stats_reset
FROM pg_class AS c
JOIN pg_stat_user_tables AS s
  ON s.relid = c.oid
WHERE c.oid = 'public.orders'::regclass;

SELECT
    conname,
    contype,
    pg_get_constraintdef(oid) AS definition
FROM pg_constraint
WHERE conrelid = 'public.orders'::regclass
ORDER BY contype, conname;

SELECT
    conrelid::regclass AS referencing_table,
    conname,
    pg_get_constraintdef(oid) AS definition
FROM pg_constraint
WHERE confrelid = 'public.orders'::regclass
  AND contype = 'f'
ORDER BY conrelid::regclass::text, conname;
预期结果
table_name | total_size | estimated_live_rows | inserts_since_stats_reset | updates_since_stats_reset | deletes_since_stats_reset
orders     | <SIZE>     | <ROWS>              | <VALUE>                   | <VALUE>                   | <VALUE>

conname | contype | definition
<NAME>  | <TYPE>  | <CONSTRAINT>

referencing_table | conname | definition
<TABLE> | <NAME> | <FOREIGN_KEY><SIZE>、<ROWS>、<VALUE>、<NAME> 等会随实际数据库变化。还应单独记录业务高峰写入速率、可接受的写暂停时长、备库延迟上限和可用临时磁盘空间;这些指标不能仅从一次系统目录查询中推断。
用迁移约束选择路径
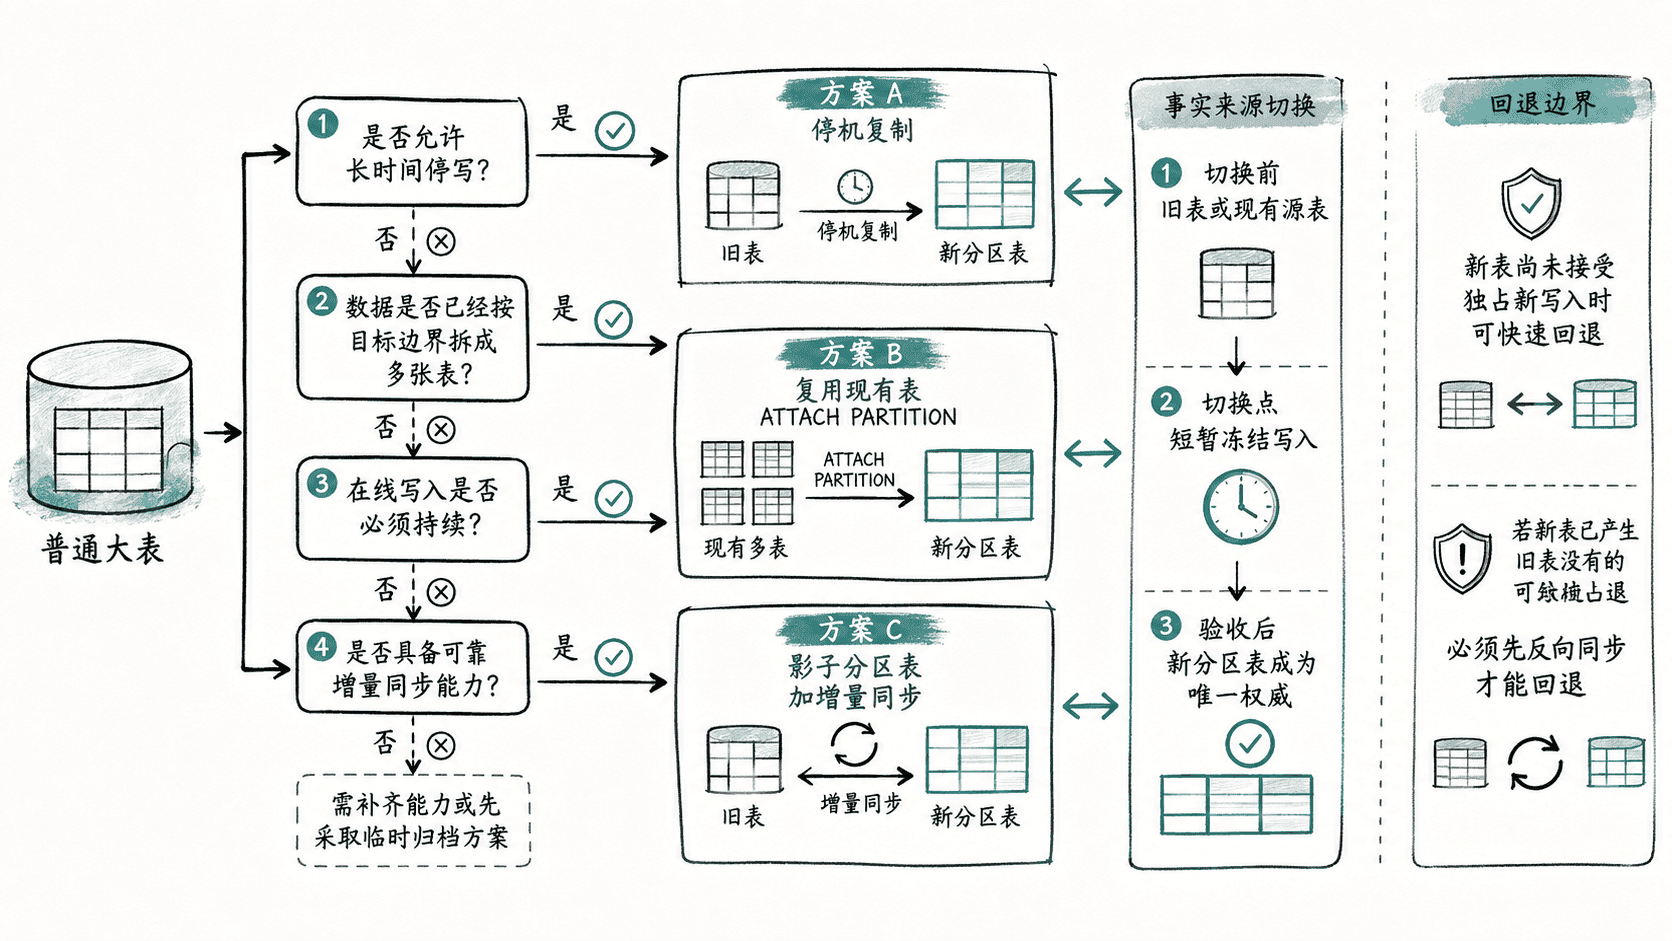
三类常见路径的核心差别不是“哪种更高级”,而是谁承担复制成本以及切换窗口多长。
| 路径 | 适合条件 | 主要代价 | 事实来源 |
|---|---|---|---|
| 停机复制到新分区表 | 可接受完整迁移窗口,写入可以暂停 | 停机时间与数据复制、索引构建时间相关 | 切换前旧表,验收后新表 |
| 影子分区表加增量同步 | 大表持续写入,只能接受短切换窗口 | 需要可靠的 CDC、逻辑同步或应用双写,并处理追平与冲突 | 追平阶段仍指定旧表为唯一权威 |
复用现有普通表并 ATTACH PARTITION |
数据已经按目标范围拆成多张独立表,且每张表满足单一边界 | 需要列、约束和边界一致性验证 | 挂载前各源表,挂载后分区父表 |
如果目标分区键是 created_at,但原主键只有 order_id,还要提前处理唯一性设计。分区表上的 PRIMARY KEY 或 UNIQUE 约束要能在整棵分区结构上成立时,约束列必须包含全部分区键列,而且分区键不能使用表达式。若业务必须保持“仅 order_id 全局唯一”的数据库约束,就不能假装迁移后原约束还能原样复制,应先重新设计键、业务约束或分区方案。
把事实来源写进迁移阶段
迁移计划至少要把四个阶段写清楚。复制阶段由旧表提供线上读写,新分区表只是影子副本;追平阶段即使两边都有数据,仍然只指定一个权威来源;切换阶段短暂冻结或串行化写入,确认最终增量已同步后再修改应用入口;验收通过后,新分区表才成为新的唯一事实来源。
“两个表都能写,失败就随便切回去”不是回退策略。只要新表已经接受了旧表没有的独占写入,而又没有持续的反向同步,直接把流量切回旧表就会丢失这些新写入。最清晰的回退边界通常是:新表开始独占接收写入之前可以快速回退;之后若要回退,必须先把新写入同步回旧表。
在批准方案前做一次约束审查
迁移评审至少检查以下事项:目标分区键能否支撑主要查询和归档粒度;主键、唯一约束与外键是否能在新结构中成立;所有必要索引能否在空间预算内重建;旧表到新表的复制是否有足够磁盘余量;长事务会不会拖住切换;序列或 identity 的当前值是否会在切换后发生冲突;触发器、RLS、默认值和权限是否在新表上等价。
还要定义可量化的验收标准,例如按分区时间窗对比行数与关键金额汇总、执行核心查询并确认结果一致、验证新写入能路由到正确分区、确认错误率和复制延迟回到基线。只有这些条件都满足,才能把“旧表仍可回退”改成“旧表进入只读保留或归档”。
一个可执行的迁移方案最终应当回答三个问题:迁移开始后谁是真实数据源、切换发生在哪个明确时刻、在哪个时刻之后回退不再是简单改路由。 这三点没有写清楚,即使数据复制脚本已经准备好,也还不具备上线条件。