
PostgreSQL / 系统课时
设计 HASH 均衡分区
设计 HASH 均衡分区
HASH 分区把分区键先计算哈希,再按 MODULUS 与 REMAINDER 路由到子表,适合没有天然时间或业务区间、但需要把数据均匀摊开的场景。本课重点验证它的路由特性,并说明扩容、裁剪和约束为什么比“平均分成几份”更值得关注。
学习目标
- 理解 HASH 分区的
MODULUS、REMAINDER与路由关系 - 创建并验证多分区数据分布和等值查询裁剪
- 评估 HASH 在扩容、归档和唯一约束上的运维代价
先确认是否真的需要均衡
HASH 适合高基数、分布难预测的键,例如账户 ID、设备 ID 或会话主体。它的价值是避免某个业务值或连续时间段把写入集中到单个分区,并把 VACUUM、索引维护和并行扫描压力分摊到多个物理子表。
但 HASH 不保留业务顺序。按月份删除历史数据、把某个区域整体迁走、只扫描最近一周这类需求,不会因为 HASH 获得天然边界。若数据生命周期主要由时间驱动,RANGE 通常比 HASH 更容易维护。
用 MODULUS 和 REMAINDER 建立分区
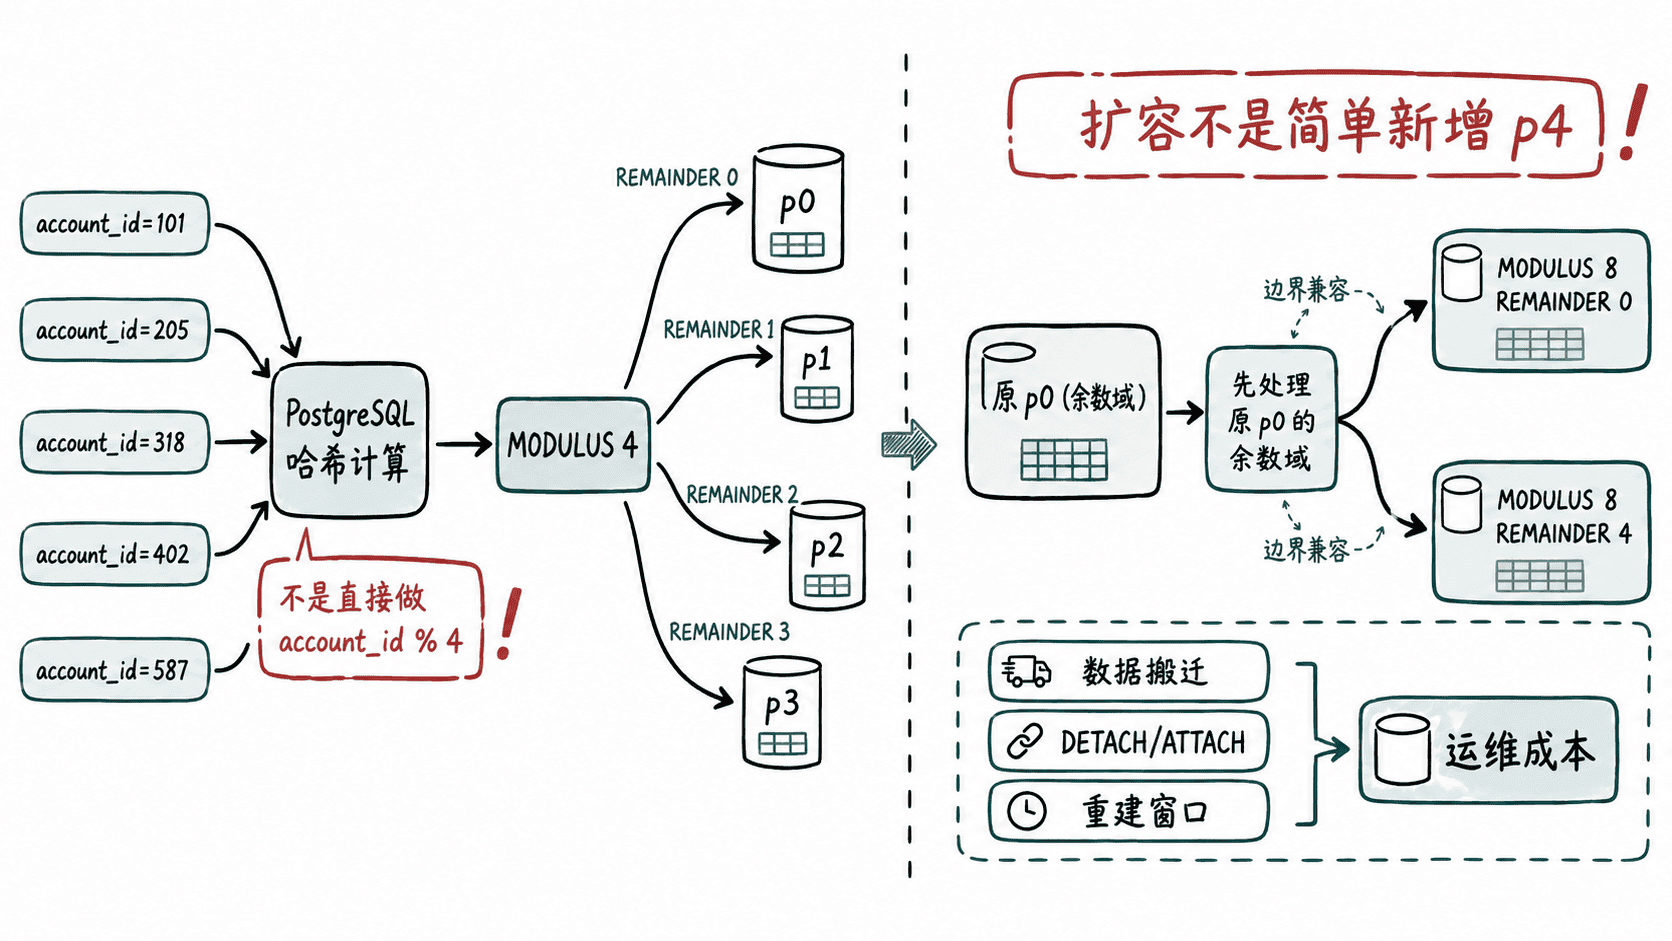
下面把账户事件分成 4 个 HASH 分区。四个子表使用相同 MODULUS 4,并分别占用余数 0 到 3;这些边界共同覆盖父表的哈希空间。
DROP TABLE IF EXISTS account_events_hash CASCADE;

CREATE TABLE account_events_hash (
    event_id bigint NOT NULL,
    account_id bigint NOT NULL,
    event_type text NOT NULL
) PARTITION BY HASH (account_id);

CREATE TABLE account_events_hash_p0
    PARTITION OF account_events_hash
    FOR VALUES WITH (MODULUS 4, REMAINDER 0);

CREATE TABLE account_events_hash_p1
    PARTITION OF account_events_hash
    FOR VALUES WITH (MODULUS 4, REMAINDER 1);

CREATE TABLE account_events_hash_p2
    PARTITION OF account_events_hash
    FOR VALUES WITH (MODULUS 4, REMAINDER 2);

CREATE TABLE account_events_hash_p3
    PARTITION OF account_events_hash
    FOR VALUES WITH (MODULUS 4, REMAINDER 3);

INSERT INTO account_events_hash (event_id, account_id, event_type)
SELECT g, g, 'login'
FROM generate_series(1, 1000) AS g;

SELECT 'account_events_hash_p0' AS partition_name, count(*) AS rows FROM account_events_hash_p0
UNION ALL
SELECT 'account_events_hash_p1', count(*) FROM account_events_hash_p1
UNION ALL
SELECT 'account_events_hash_p2', count(*) FROM account_events_hash_p2
UNION ALL
SELECT 'account_events_hash_p3', count(*) FROM account_events_hash_p3;
最后一条查询的预期输出:
      partition_name       | rows
---------------------------+----------
 account_events_hash_p0    | <COUNT_0>
 account_events_hash_p1    | <COUNT_1>
 account_events_hash_p2    | <COUNT_2>
 account_events_hash_p3    | <COUNT_3>
四个 <COUNT_0> 到 <COUNT_3> 的总和应为 1000,单个计数通常接近但不要求完全相等。实际值由 PostgreSQL 对分区键计算出的哈希结果决定,不能把路由规则理解成 account_id % 4。
验证等值查询能裁剪到单个分区
HASH 最容易从等值条件获益,因为规划器可以对常量分区键计算目标哈希分区。下面查询一个确定账户,并观察父表是否只保留一个子分区。
EXPLAIN (COSTS OFF)
SELECT *
FROM account_events_hash
WHERE account_id = 42;
预期输出的核心结构如下,其中 <N> 取 0 到 3,实际余数由 PostgreSQL 哈希结果决定:
Seq Scan on account_events_hash_p<N>
  Filter: (account_id = 42)
只有一个子分区出现在计划中,说明分区裁剪生效。HASH 不保存键值顺序,因此 account_id BETWEEN 1 AND 100 这类范围条件通常不能像 RANGE 分区那样排除连续的一组分区;没有可裁剪分区键条件的查询仍可能访问全部子表。
把扩容成本算进设计
HASH 分区最容易低估的是扩容。现有 4 个余数域已经覆盖整个哈希空间,不能简单再挂一个“第五分区”就让新写入自动变成五等份。新的 HASH 边界必须与已有 MODULUS、REMAINDER 规则兼容且不能重叠。
PostgreSQL 允许满足因数关系的 HASH 模数共存,这使逐步拆分某个余数域成为可能;但被拆分分区中的既有行仍需要按照新边界重新分配。生产设计应提前准备迁移窗口、额外磁盘空间、锁影响和回滚方案,而不是把“以后再多建几个分区”当成无成本操作。
如果核心目标是在线水平扩容到任意节点数,单机 PostgreSQL 的声明式 HASH 分区也不是分布式分片器。它只是在同一个数据库实例内把表拆成多个关系,不能自动把数据迁移到其他服务器。
约束与运维边界
HASH 子分区适合分别执行 VACUUM、重建索引或控制并行维护,但它不提供按业务域快速删除的自然语义。若需要“整月删除”或“整租户迁移”,应优先让第一层分区键与生命周期一致,再考虑是否在第二层使用 HASH 做均衡。
和其他声明式分区一样,父分区表上的主键或唯一约束若要覆盖整个分区层级,必须包含所有分区键列。因此按 account_id 做 HASH 时,单独的 UNIQUE (event_id) 不能直接作为父表上的全局唯一约束;约束设计必须与分区键一起考虑。
HASH 的适用条件可以归纳为:键值高基数、缺少更有业务意义的范围边界、工作负载需要把读写与维护压力摊开,并且团队能接受后续拆分余数域的数据迁移成本。只为了“看起来更均匀”而忽略生命周期和扩容方式,往往会把简单问题变成长期运维负担。