
PostgreSQL / 系统课时
设计历史分区保留策略
设计历史分区保留策略
历史数据治理的关键不是“多久删一次”,而是把保留期限转换成可执行的分区边界,让在线查询、归档保存和最终删除都以整分区为单位,避免大批量 DELETE 带来的 WAL、死元组与 VACUUM 成本。
学习目标
- 将业务保留期限换算成明确的分区迁移与删除边界。
- 区分在线、归档、删除三个阶段,并为每个阶段选择合适动作。
- 识别精确天数与月分区不对齐时的提前删除风险。
先把保留规则写成分区动作
一条可执行的保留策略至少要回答三个问题:数据何时离开主表、离开后保存多久、什么时候允许不可逆删除。对按时间范围分区的大表,可以把生命周期固定为“在线分区 → 已摘除归档表 → 删除”。
| 阶段 | 数据形态 | 典型动作 | 主要目的 |
|---|---|---|---|
| 在线 | 仍挂在分区父表下 | 正常查询与写入 | 保证近期数据访问 |
| 归档 | 独立表,不再参与父表路由 | DETACH PARTITION |
保留数据并降低主表历史负担 |
| 删除 | 归档表被移除 | DROP TABLE |
以整分区回收过期数据 |
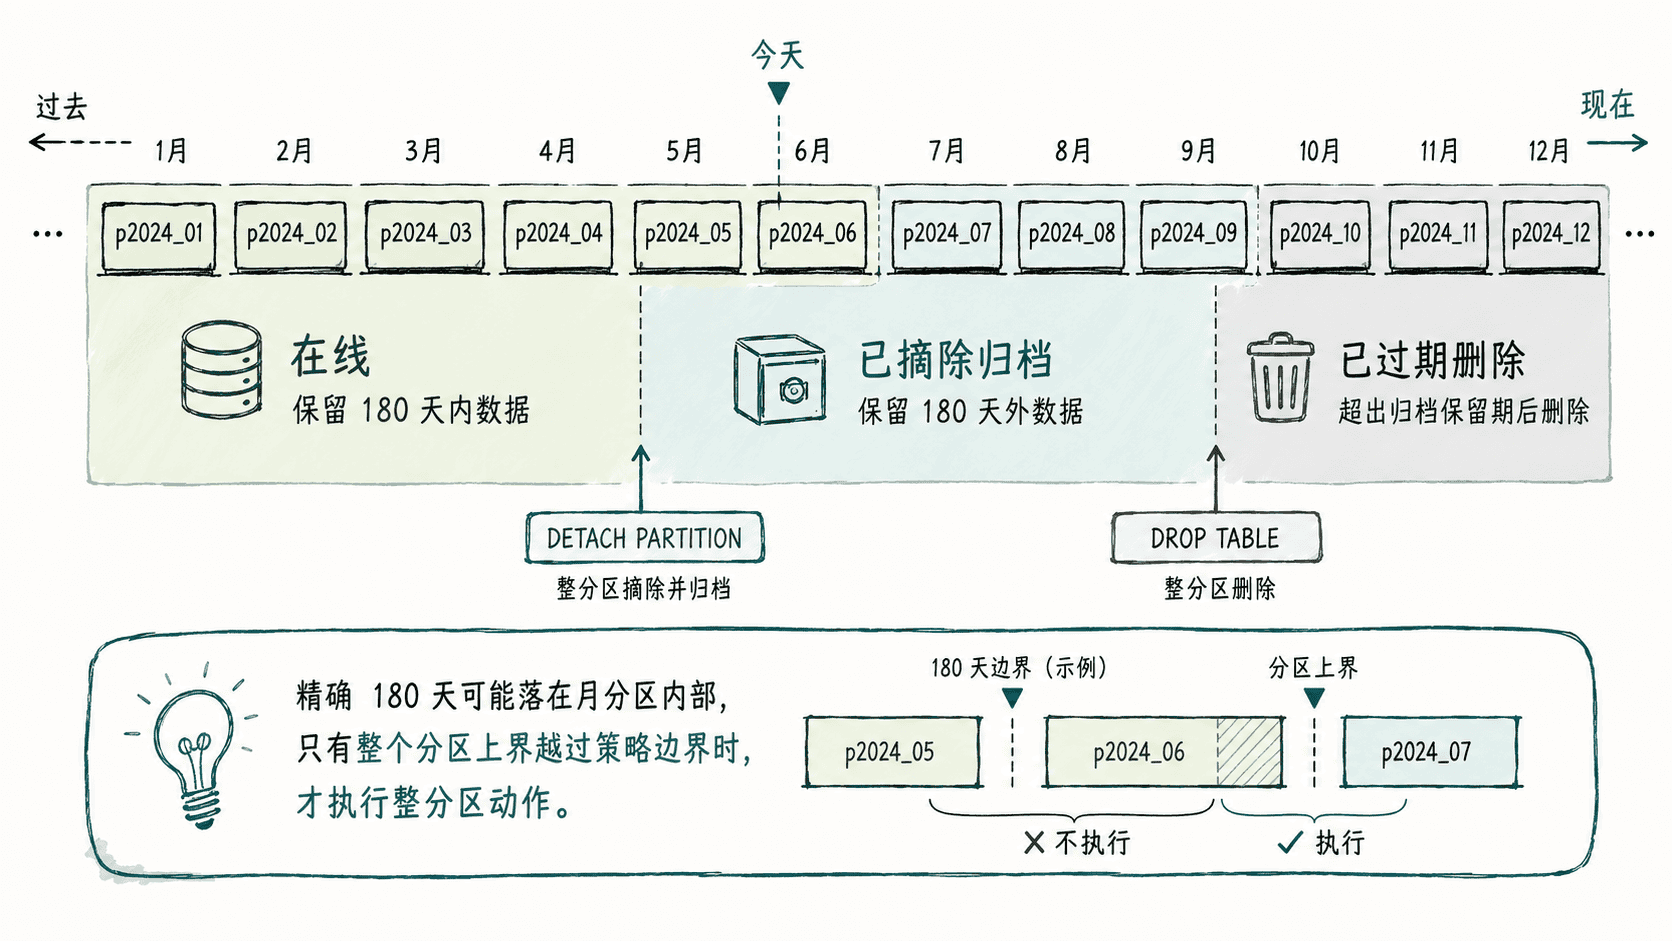
让时间窗口与分区粒度对齐
假设表按自然月分区,策略定义为“当前月加最近 6 个完整月在线,再归档 12 个月,之后删除”。不要直接用“180 天≈6 个月”替换,因为精确 180 天的截止点通常落在某个月分区内部,整表删除会误删仍在保留期内的行。
下面用固定运行日计算两个整月边界,便于在测试环境复现策略。
WITH policy AS (
    SELECT DATE '2026-09-01' AS run_date
)
SELECT
    date_trunc('month', run_date)::date AS current_month,
    (date_trunc('month', run_date) - INTERVAL '6 months')::date AS detach_before,
    (date_trunc('month', run_date) - INTERVAL '18 months')::date AS drop_before
FROM policy;
预期输出:
 current_month | detach_before | drop_before
---------------+---------------+-------------
 2026-09-01    | 2026-03-01    | 2025-03-01
(1 row)对月分区来说,只有分区上界小于等于 detach_before 时,整个分区才可以离开在线集合;只有已归档分区的上界小于等于 drop_before 时,才进入删除候选。这样不会因为一个分区横跨策略边界而提前处理其中部分数据。
用成本决定删除方式
DROP TABLE 删除整个过期分区时,不需要逐行生成删除版本,因此通常比大范围 DELETE 更适合真正到期的数据;但它是不可逆动作,还要考虑依赖对象和锁。DETACH PARTITION 则保留原表,适合先归档、审计或做恢复演练。
行级 DELETE 只应承担“边界无法对齐”或“分区内仍混有未到期数据”这类细粒度任务。若长期靠它清历史数据,说明分区粒度与保留策略没有对齐,维护成本会重新回到大表本身。
把策略变成可审计批次
生产执行时,不要让定时任务仅凭表名推断日期。每次批次都应读取实际分区边界,并记录候选分区、上界、当前阶段、归档是否验证、允许删除日期和执行结果。命名规则可以帮助运维人员阅读,但不能替代数据库中的真实分区约束。
删除动作应放在归档验证之后,并保留一个明确的回滚窗口。只要在线边界、归档边界和最终删除边界都与分区粒度一致,历史数据治理就能从高成本的逐行清理,变成可预测、可审计的分区生命周期操作。