
PostgreSQL / 系统课时
处理参数化查询与运行时裁剪
处理参数化查询与运行时裁剪
参数化 SQL 的计划里出现多个分区,并不等于执行时一定扫描多个分区。本课用预备语句强制对比 generic plan 与 custom plan,学会从 Subplans Removed、参数占位符和实际执行次数判断运行时裁剪是否生效。
学习目标
- 理解参数值在计划期未知时为什么仍可能发生分区裁剪
- 能区分 custom plan 的计划期裁剪与 generic plan 的运行时裁剪
- 能用
EXPLAIN ANALYZE判断实际执行了哪些分区
参数值什么时候可见很关键
普通常量查询在规划时就知道日期范围,规划器可以直接排除不相关分区。预备语句使用 $1、$2 作为参数时,是否能在规划阶段看到具体值,取决于本次执行使用 custom plan 还是 generic plan。
custom plan 会针对本次参数重新规划,具体值能参与计划期裁剪。generic plan 必须复用于不同参数,因此计划中保留参数符号;但执行器拿到真实参数后,仍可以在执行初始化阶段移除不可能命中的分区。
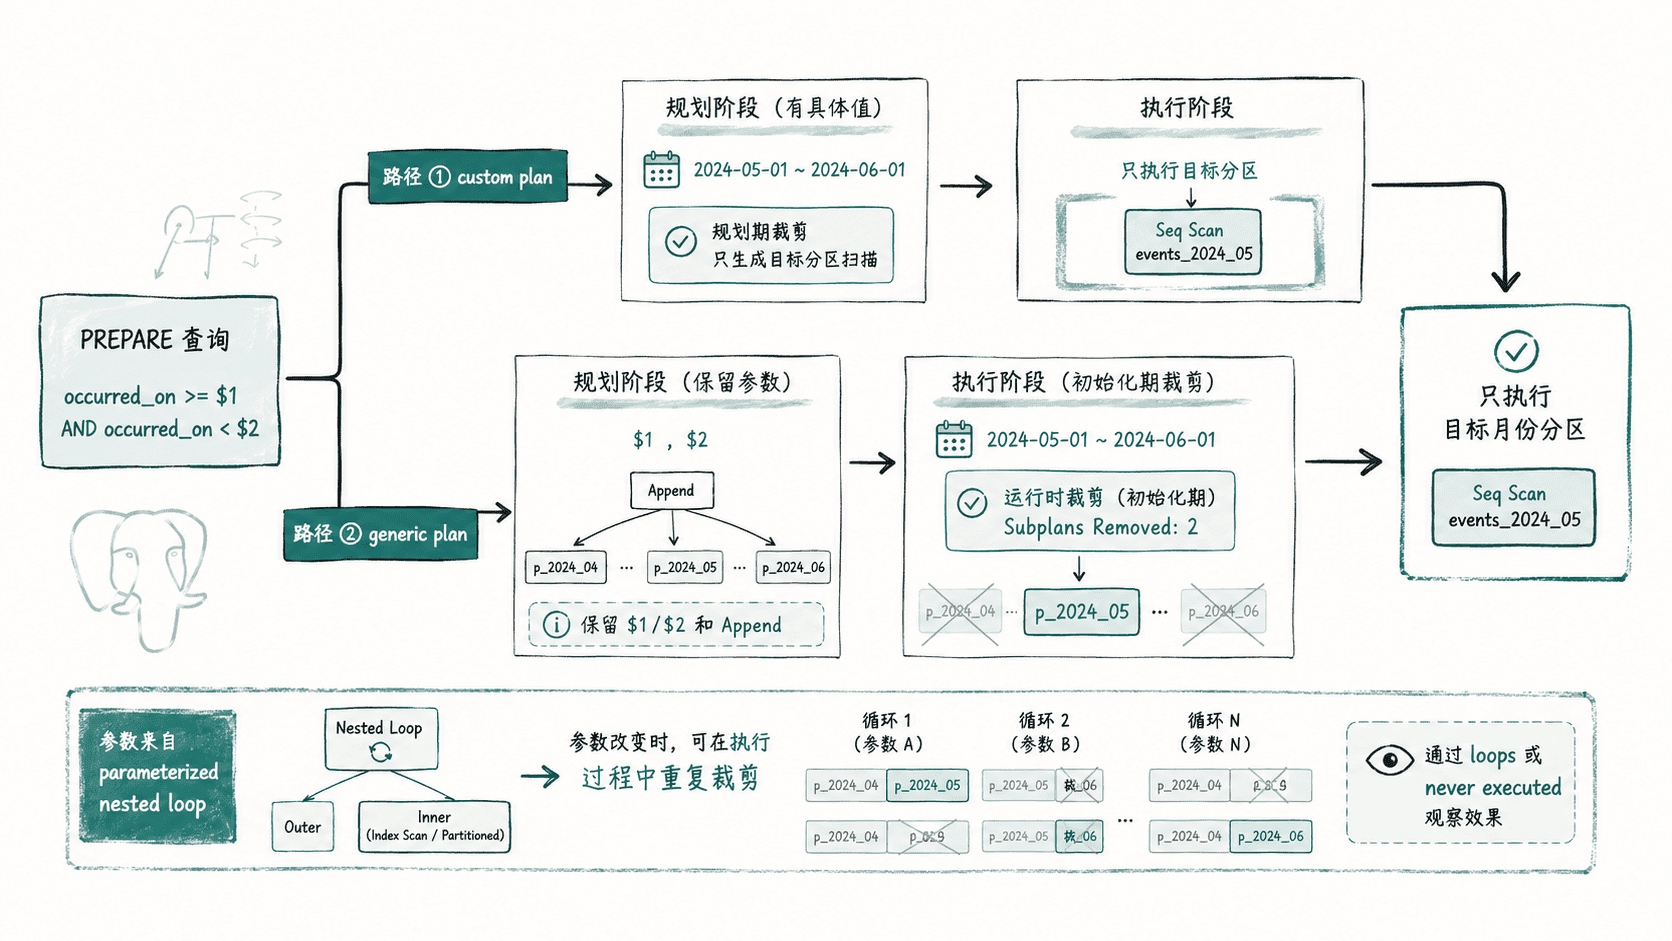
强制两种计划做对照
为了排除 PostgreSQL 自动选择计划类型带来的干扰,下面用 plan_cache_mode 分别强制 generic plan 和 custom plan。示例独立创建三个分区,并用同一组二月参数执行。
DROP TABLE IF EXISTS events CASCADE;

CREATE TABLE events (
    id bigint NOT NULL,
    occurred_on date NOT NULL,
    payload text
) PARTITION BY RANGE (occurred_on);

CREATE TABLE events_2026_01 PARTITION OF events
FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');

CREATE TABLE events_2026_02 PARTITION OF events
FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');

CREATE TABLE events_2026_03 PARTITION OF events
FOR VALUES FROM ('2026-03-01') TO ('2026-04-01');

INSERT INTO events VALUES
    (1, DATE '2026-01-08', 'a'),
    (2, DATE '2026-02-08', 'b'),
    (3, DATE '2026-03-08', 'c');

ANALYZE events;

PREPARE by_window(date, date) AS
SELECT count(*)
FROM events
WHERE occurred_on >= $1
  AND occurred_on < $2;

SET plan_cache_mode = force_generic_plan;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
EXECUTE by_window(DATE '2026-02-01', DATE '2026-03-01');

SET plan_cache_mode = force_custom_plan;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
EXECUTE by_window(DATE '2026-02-01', DATE '2026-03-01');

RESET plan_cache_mode;
DEALLOCATE by_window;
预期输出
-- generic plan:计划保留参数,但执行初始化时移除两个无关分区
Aggregate (actual rows=1 loops=1)
  -> Append (actual rows=1 loops=1)
       Subplans Removed: 2
       -> Seq Scan on events_2026_02 ...
            Filter: ((occurred_on >= $1) AND (occurred_on < $2))

-- custom plan:规划时已知道参数,只留下二月分区
Aggregate (actual rows=1 loops=1)
  -> Seq Scan on events_2026_02 ...
       Filter: ((occurred_on >= '2026-02-01'::date) AND (occurred_on < '2026-03-01'::date))
执行时间、别名和部分节点细节会因版本与环境不同,但 generic plan 中看到 $1、$2,同时看到 Subplans Removed: 2,就是“参数值到执行阶段才参与裁剪”的典型证据。
读运行时裁剪要看实际执行信息
只运行 EXPLAIN 容易误判,因为它主要展示计划结构。要确认执行阶段到底访问了哪些分区,应使用 EXPLAIN ANALYZE,重点查看 Subplans Removed、各子计划的 loops 和是否出现 (never executed)。
预备语句参数在执行开始时就已确定,因此常见的是初始化阶段裁剪:被移除的分区不会真正扫描。另一类情况是参数来自参数化嵌套循环连接,参数值可能随外层行变化,执行器会在参数变化时重新判断可用分区。
这时不同分区的 loops 可能不同;某个分区若每次都被裁掉,可能显示 (never executed)。所以判断“运行时裁剪有效”不能只数计划树里写了几个分区名,而要看哪些节点真正执行过。
generic plan 不等于性能一定差
默认 plan_cache_mode = auto 时,带参数的预备语句通常先经历若干次 custom plan,再比较通用计划与自定义计划的估算成本,决定后续是否值得复用 generic plan。generic plan 节省重复规划成本,但无法在规划阶段针对单次参数分布做最优选择。
对于分区表,generic plan 仍可能依靠运行时裁剪把实际访问范围缩小到少量分区,因此不要因为看到 Append 就立即强制 custom plan。真正的问题应由执行时间、实际扫描分区数、行数估算和稳定负载共同证明。
参数化查询的排查顺序应固定为:先确认分区条件确实约束分区键,再判断当前使用的是 custom 还是 generic plan,最后用 EXPLAIN ANALYZE 核对实际执行分区。这样才能把“计划里看见分区”和“运行时真的扫描分区”分开。