
PostgreSQL / 系统课时
从访问模式选择分区键
从访问模式选择分区键
分区键决定 PostgreSQL 能否在查询早期排除无关分区,也决定数据分布、维护边界和后续索引成本。本课从真实过滤条件出发选择分区键,并用执行计划验证“看起来合理”的键是否真的带来分区裁剪。
学习目标
- 根据高频过滤条件、数据增长方式和维护边界筛选分区键
- 区分适合做分区键的条件与更适合交给普通索引的条件
- 使用
EXPLAIN验证查询是否发生分区裁剪
先从查询条件而不是数据量出发
“表很大,所以按某列分区”不是足够的设计依据。分区真正能降低扫描范围的前提,是常见 SQL 能对分区键形成可推导的约束。对于事件、订单、日志这类持续增长的数据,时间列常同时出现在查询窗口、归档策略和数据保留规则里,因此往往比业务枚举值更适合做第一层分区键。
选择候选键时至少检查四件事:高频查询是否过滤它、取值是否能形成相对均衡的分区、是否对应明确的删除或归档边界、未来分区数量是否可控。像 status 这种值少且分布不断变化的列,即使查询频繁出现,也常更适合普通索引,而不是直接拆成少量长期膨胀的分区。
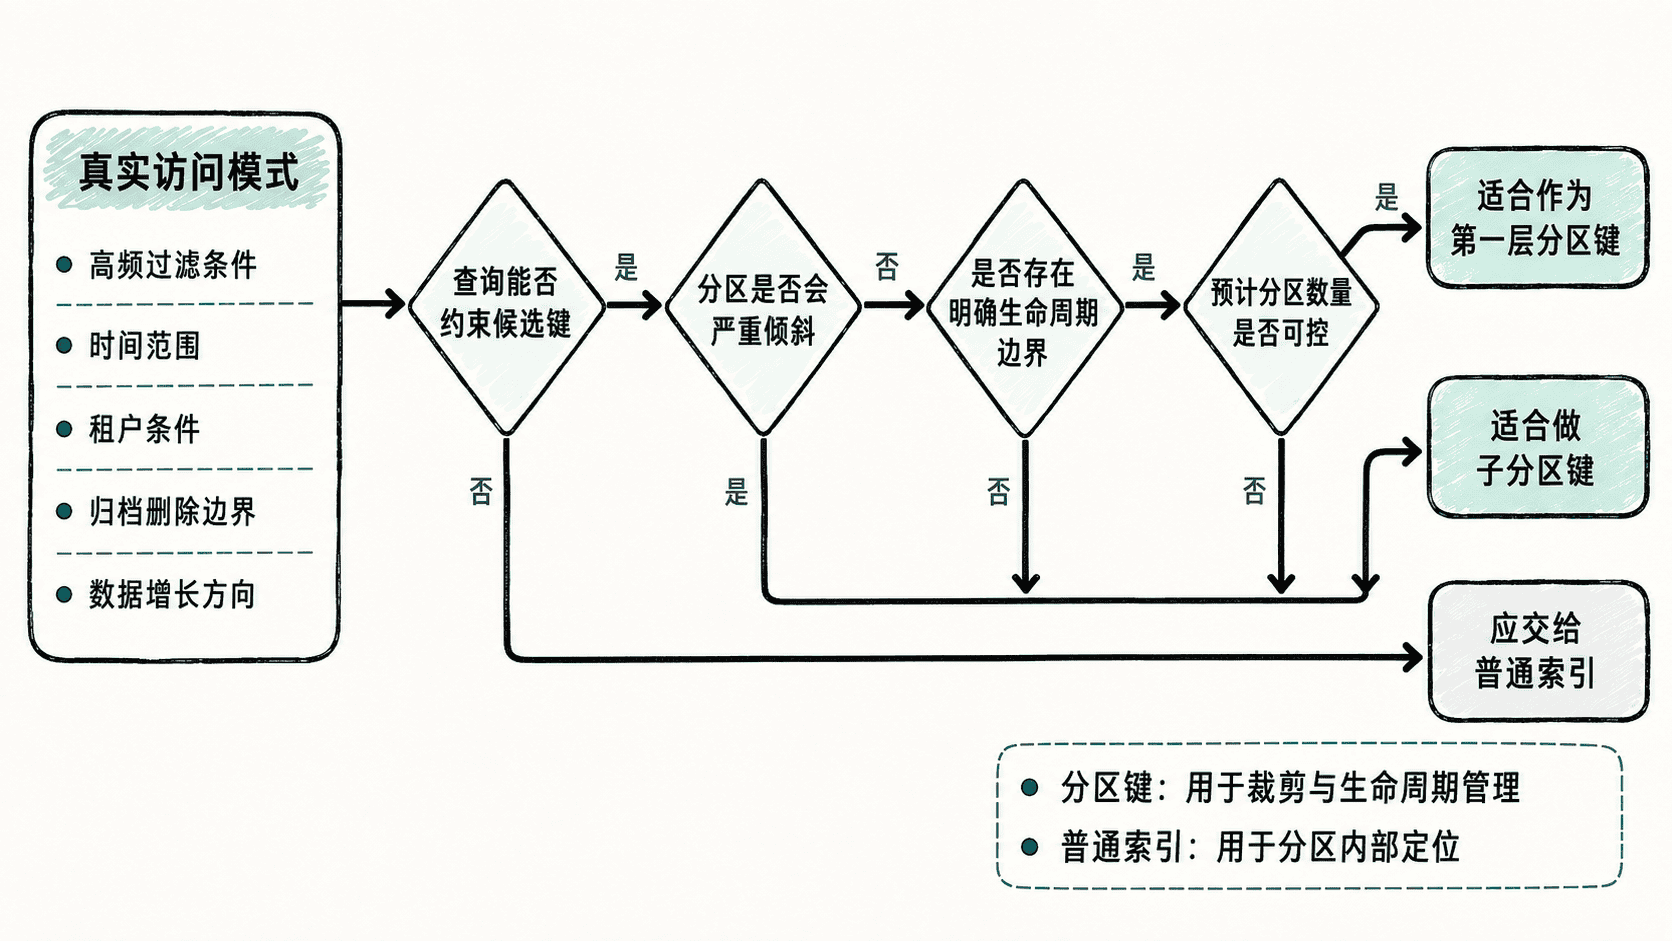
用执行计划验证候选键
下面建立一个按 occurred_at 月度 RANGE 分区的事件表。示例故意不创建普通索引,用来单独观察分区键对扫描范围的影响。
DROP TABLE IF EXISTS event_log CASCADE;

CREATE TABLE event_log (
    event_id bigint GENERATED ALWAYS AS IDENTITY,
    tenant_id bigint NOT NULL,
    occurred_at timestamptz NOT NULL,
    payload jsonb NOT NULL
) PARTITION BY RANGE (occurred_at);

CREATE TABLE event_log_2026_08
PARTITION OF event_log
FOR VALUES FROM ('2026-08-01 00:00:00+00')
             TO ('2026-09-01 00:00:00+00');

CREATE TABLE event_log_2026_09
PARTITION OF event_log
FOR VALUES FROM ('2026-09-01 00:00:00+00')
             TO ('2026-10-01 00:00:00+00');

INSERT INTO event_log (tenant_id, occurred_at, payload) VALUES
(10, '2026-08-20 10:00:00+00', '{"kind":"login"}'),
(20, '2026-09-05 11:00:00+00', '{"kind":"purchase"}');

ANALYZE event_log;

EXPLAIN (COSTS OFF)
SELECT *
FROM event_log
WHERE occurred_at >= '2026-09-01 00:00:00+00'
  AND occurred_at <  '2026-10-01 00:00:00+00';
预期输出的关键结果是计划只包含九月分区;具体过滤条件的显示格式可能因 PostgreSQL 版本略有差异。
Seq Scan on event_log_2026_09
  Filter: (...)
这说明时间条件可以直接约束分区键,规划器无需把八月分区加入执行计划。分区裁剪减少的是“需要访问哪些分区”,并不等于分区内部一定高效;九月分区变大后,仍可能需要为 tenant_id、业务状态或其他条件建立普通索引。
识别不能靠分区解决的过滤条件
同一张表如果只按租户查询,却没有时间条件,按时间分区无法排除任何月份。执行下面的计划检查:
EXPLAIN (COSTS OFF)
SELECT *
FROM event_log
WHERE tenant_id = 10;
预期结果会出现 Append,并列出当前所有相关时间分区。
Append
  ->  Seq Scan on event_log_2026_08
        Filter: (tenant_id = 10)
  ->  Seq Scan on event_log_2026_09
        Filter: (tenant_id = 10)
如果生产请求几乎总是“某租户 + 时间范围”,时间仍可以做第一层分区键,再在各分区上为 tenant_id 建索引;只有当租户隔离、租户级迁移或单租户数据规模本身就是主要维护边界时,才值得进一步评估按租户分区或“租户 + 时间”的多级设计。
控制倾斜、数量和约束成本
分区键不能只看查询命中率。高基数键可能制造成千上万个小分区,低基数热点键则可能让某个分区持续膨胀。实践中应先估算每个分区的预期数据量、活跃分区数量和保留周期,再决定按天、月、租户或复合层级切分。
还要注意约束设计:在 PostgreSQL 的声明式分区表上,要在父表定义能够跨全部分区保证唯一性的 PRIMARY KEY 或 UNIQUE 约束,约束列必须包含全部分区键列。若业务只要求单个分区内部唯一,可以在分区上单独建唯一索引,但那不等价于全表唯一。
最终判断标准不是“这个键看起来最均匀”,而是高频 SQL 能稳定裁剪分区,生命周期操作能沿分区边界完成,并且分区数量与数据倾斜仍处于可维护范围。