
PostgreSQL / 系统课时
分批接管历史数据
分批接管历史数据
把历史数据迁进分区表时,真正要控制的不是一次能搬多少行,而是单个事务失败时要回滚多少、会制造多少 WAL,以及是否影响在线写入。本节用按月批次演示可重试迁移,并给出每批推进前的验收边界。
学习目标
- 按分区边界设计短事务、可重试的历史数据迁移批次
- 用源端与目标端校验避免漏搬、重复和批次越界
- 判断何时应复制数据,何时应直接把既有历史表挂接为分区
把历史区间冻结成批次
先定义一个不会再被正常业务修改的历史截止点,例如只迁移 2024-03-01 之前的数据;如果业务仍允许回补或修改历史记录,就必须先冻结这类写入,或另建变更捕获机制。否则“批量复制完成”并不等于源端数据已经稳定。
批次最好直接对齐分区边界,并使用左闭右开区间,例如 [2024-01-01, 2024-02-01)。这样每一行只属于一个批次,失败时也只需重跑当前区间。迁移期间先保留旧表数据,不要边复制边删除;删除会放大 VACUUM 压力,也会缩短回退窗口。
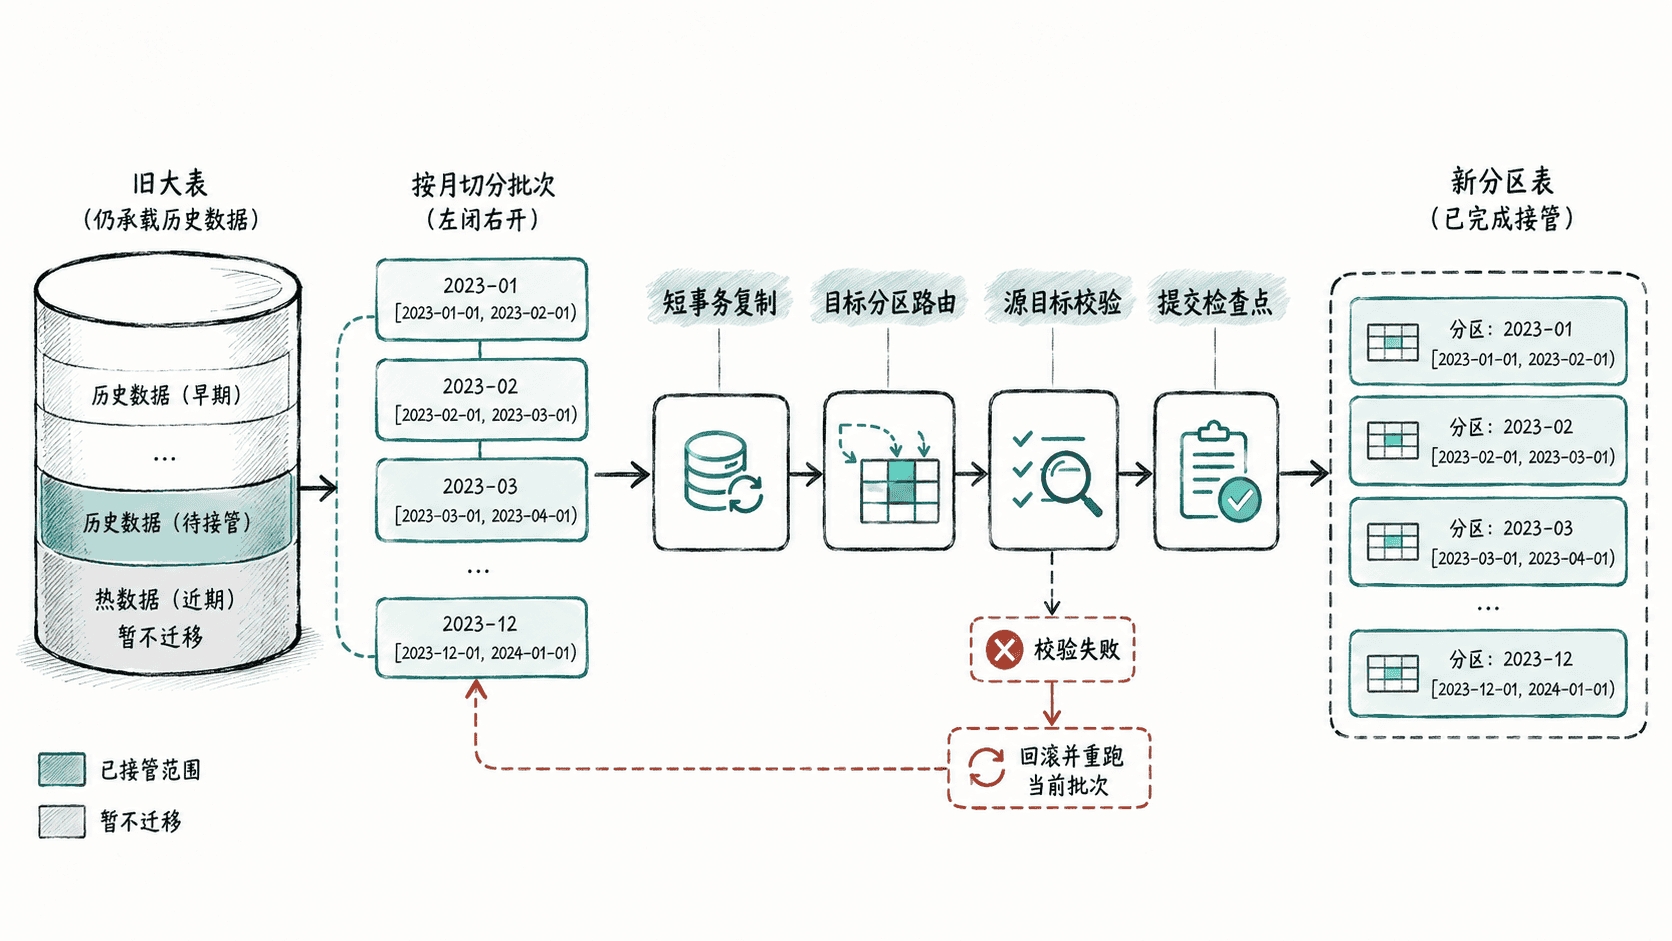
用一个事务完成一个可重试批次
下面的实验在空白测试库中创建旧表和新分区表,只迁移 2024 年 1 月。目标表使用与源表一致的业务列,并以 (id, created_at) 作为可判定重复的键;ON CONFLICT DO NOTHING 让同一批次在提交结果不确定时可以安全重试。
CREATE TABLE demo_orders_legacy (
    id bigint NOT NULL,
    created_at date NOT NULL,
    amount numeric(12,2) NOT NULL,
    PRIMARY KEY (id, created_at)
);

INSERT INTO demo_orders_legacy VALUES
    (1, DATE '2024-01-05', 100.00),
    (2, DATE '2024-01-20', 250.00),
    (3, DATE '2024-02-03', 80.00),
    (4, DATE '2024-02-25', 120.00);

CREATE TABLE demo_orders_part (
    id bigint NOT NULL,
    created_at date NOT NULL,
    amount numeric(12,2) NOT NULL,
    PRIMARY KEY (id, created_at)
) PARTITION BY RANGE (created_at);

CREATE TABLE demo_orders_part_2024_01
PARTITION OF demo_orders_part
FOR VALUES FROM ('2024-01-01') TO ('2024-02-01');

CREATE TABLE demo_orders_part_2024_02
PARTITION OF demo_orders_part
FOR VALUES FROM ('2024-02-01') TO ('2024-03-01');

BEGIN;

INSERT INTO demo_orders_part (id, created_at, amount)
SELECT id, created_at, amount
FROM demo_orders_legacy
WHERE created_at >= DATE '2024-01-01'
  AND created_at < DATE '2024-02-01'
ON CONFLICT (id, created_at) DO NOTHING;

WITH source_batch AS (
    SELECT count(*) AS row_count, sum(amount) AS amount_sum
    FROM demo_orders_legacy
    WHERE created_at >= DATE '2024-01-01'
      AND created_at < DATE '2024-02-01'
),
target_batch AS (
    SELECT count(*) AS row_count, sum(amount) AS amount_sum
    FROM demo_orders_part
    WHERE created_at >= DATE '2024-01-01'
      AND created_at < DATE '2024-02-01'
)
SELECT s.row_count AS source_rows,
       t.row_count AS target_rows,
       s.amount_sum AS source_amount,
       t.amount_sum AS target_amount
FROM source_batch AS s
CROSS JOIN target_batch AS t;

COMMIT;
预期输出:
INSERT 0 2
 source_rows | target_rows | source_amount | target_amount
-------------+-------------+---------------+--------------
           2 |           2 |        350.00 |        350.00
COMMIT
再次执行同一批插入时,冲突行不会重复写入;但这只保证键不重复,不保证非键列一定相同。因此生产验收还应对当前批次做更强的差异检查,例如按主键抽样比对关键列,或在可接受成本内做双向差集。
让每批真正保持短小
批次大小应由事务持续时间、WAL 生成速度、复制延迟和目标索引写入成本共同决定,而不是固定成“每次一百万行”。一个月仍然过大时,可以在同一分区边界内继续按主键范围切小批次,但必须保证范围不重叠且检查点可持久化。
源表如果已有 created_at 或可利用的复合索引,应让批次查询复用它;不要为了迁移盲目给超大旧表新增昂贵索引。每个批次提交后再推进检查点,并持续观察复制槽、归档、磁盘和长事务。批量装载完成后,再对新分区执行统计信息维护,而不是把所有历史数据塞进一个超长事务。
已有独立历史表时不要重复搬运
如果历史数据本来就按月存放在独立普通表中,而且列定义与目标分区父表完全匹配,可以优先考虑 ATTACH PARTITION,避免再次复制整批数据。为减少挂接时的长时间验证扫描,应先给候选表建立与分区边界一致的有效 CHECK 约束;大表可先以 NOT VALID 添加,再用 VALIDATE CONSTRAINT 提前完成扫描。
挂接时父分区表会取得较弱的结构锁,但被挂接表本身仍需要更强锁;如果父表存在 DEFAULT 分区,还要提前证明默认分区不含新边界内的数据,否则 PostgreSQL 可能扫描默认分区。无论采用复制还是挂接,只有当前批次边界闭合、源目标校验通过、检查点已记录,才应推进下一批。