
PostgreSQL / 系统课时
理解声明式分区对象模型
理解声明式分区对象模型
声明式分区把一个逻辑表拆成“虚拟父表、分区键、分区边界和实际存储分区”几类对象。本课用一个可运行的范围分区示例看清数据如何路由到子表,以及查询、索引和维护操作分别落在哪一层。
学习目标
- 说清分区表、分区键、分区边界与叶子分区的职责
- 通过
tableoid验证行实际存储在哪个分区 - 区分父表的逻辑入口与子分区的物理存储
从父表看清对象关系
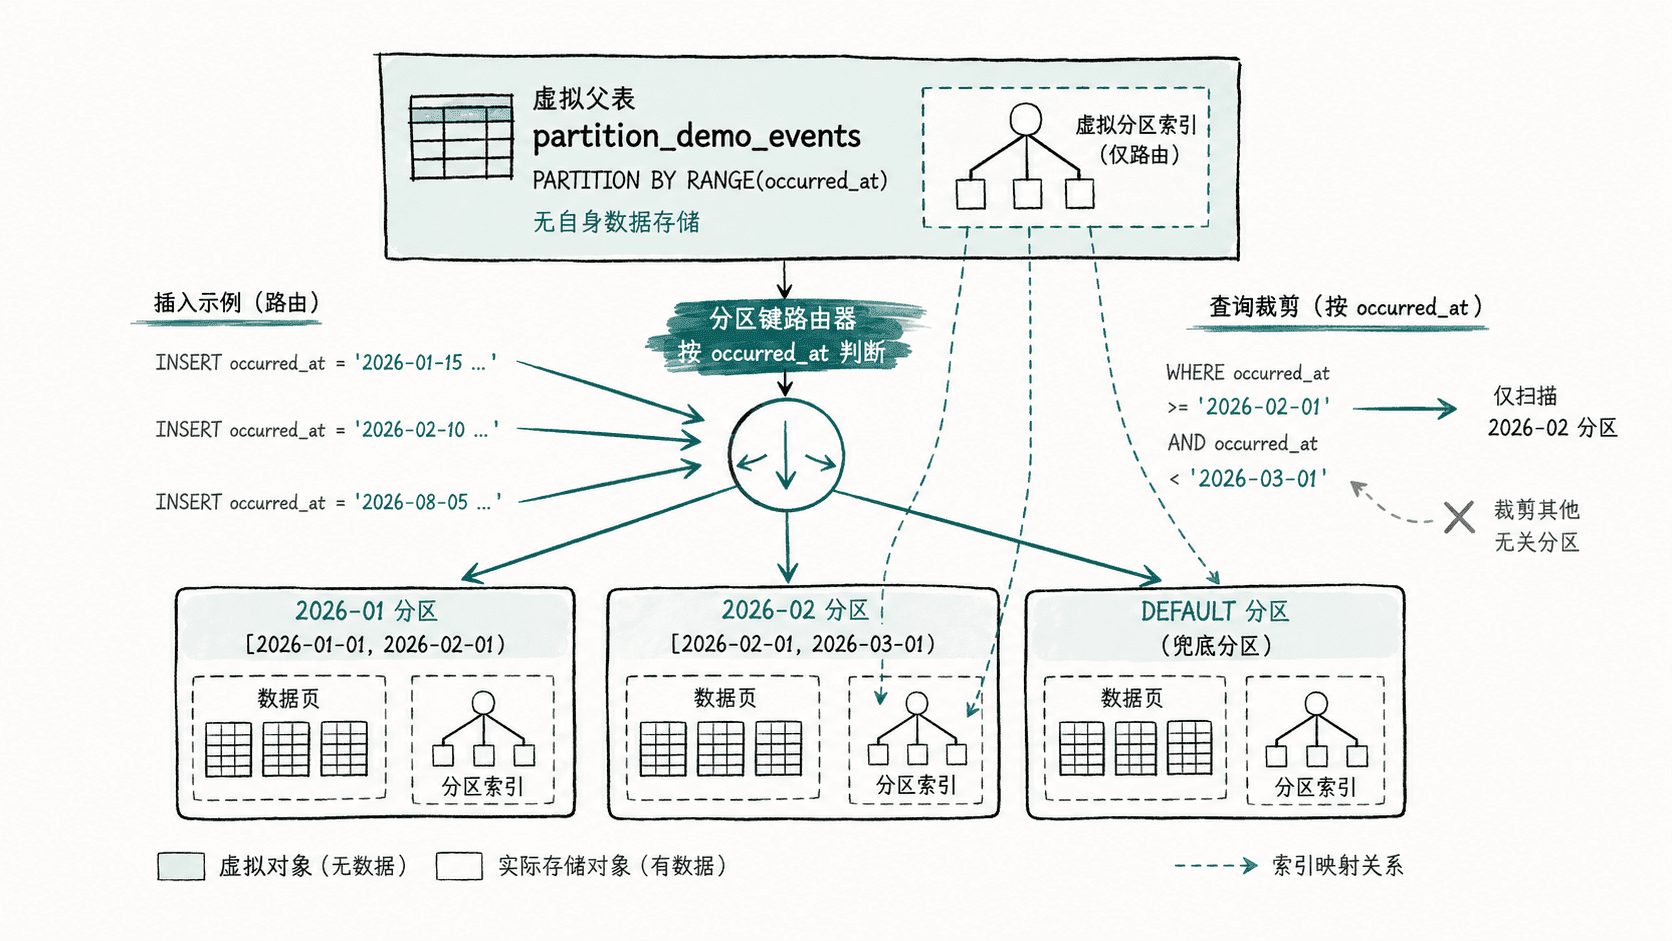
用 PARTITION BY 创建的父表本身不保存数据,它定义统一的列结构和分区策略。真正存储行的是挂在父表下的分区,每个分区通过自己的边界声明负责一段互不重叠的键空间;分区还可以继续成为分区表,形成多级分区。
插入父表时,PostgreSQL 根据分区键计算目标分区。查询父表时,应用看到的仍是一个逻辑表;当查询条件能与分区边界匹配时,规划器可以裁剪无关分区。索引也有层级:在父表上声明的索引是分区索引,实际索引数据位于各个叶子分区的子索引中。
建一个最小声明式分区结构
下面示例使用临时表,不污染当前数据库的持久对象。两个显式月分区覆盖一月和二月,DEFAULT 分区接收未被前两段边界覆盖的行;最后通过系统列 tableoid 直接查看每行的物理目标表。
CREATE TEMP TABLE partition_demo_events (
    id integer NOT NULL,
    occurred_at date NOT NULL,
    payload text,
    PRIMARY KEY (id, occurred_at)
) PARTITION BY RANGE (occurred_at);

CREATE TEMP TABLE partition_demo_events_2026_01
    PARTITION OF partition_demo_events
    FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');

CREATE TEMP TABLE partition_demo_events_2026_02
    PARTITION OF partition_demo_events
    FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');

CREATE TEMP TABLE partition_demo_events_default
    PARTITION OF partition_demo_events DEFAULT;

INSERT INTO partition_demo_events (id, occurred_at, payload) VALUES
    (1, DATE '2026-01-15', 'jan'),
    (2, DATE '2026-02-10', 'feb'),
    (3, DATE '2026-03-05', 'fallback');

SELECT
    id,
    occurred_at,
    tableoid::regclass::text AS physical_table
FROM partition_demo_events
ORDER BY id;
预期输出
CREATE TABLE
CREATE TABLE
CREATE TABLE
CREATE TABLE
INSERT 0 3
 id | occurred_at |          physical_table
----+-------------+---------------------------------
  1 | 2026-01-15  | partition_demo_events_2026_01
  2 | 2026-02-10  | partition_demo_events_2026_02
  3 | 2026-03-05  | partition_demo_events_default
(3 rows)
临时模式名称由会话动态生成,但 regclass 在当前搜索路径可见时通常显示上面的短表名。第一条和第二条记录分别命中各自月份,三月记录则进入默认分区,说明父表只负责统一入口和路由,行最终落在具体分区。
路由、边界和裁剪不要混在一起
分区边界决定“某一行允许存在哪里”。范围分区的 FROM 下界包含、TO 上界不包含,所以一月分区的上界 2026-02-01 实际属于二月分区。若没有匹配分区且也没有 DEFAULT 分区,向父表插入该行会失败。
分区裁剪解决的是“查询时哪些分区可以不访问”,它依赖查询条件与分区边界的可推导关系,不等同于行路由。路由发生在写入或分区键更新时;裁剪发生在查询计划或执行阶段。把两者分开理解,后面分析执行计划时才不会把“数据存对了”误认为“查询一定只扫一个分区”。
记住父子对象的维护边界
父表统一承载列结构和分区层级,子分区则是真正的存储与维护对象。分区可以拥有自己的索引、额外约束和存储参数;在父表创建普通索引时,PostgreSQL 会为现有分区建立或关联匹配的子索引,后续分区也需要保持该索引层级完整。
新增或移除数据范围,本质上是在调整分区对象及其边界,而不是把父表中的行“切块”。因此设计声明式分区时,最重要的心智模型是:父表负责逻辑入口和规则,叶子分区负责物理存储,分区键与边界把两者连接起来。