
PostgreSQL / 系统课时
设计父级索引与分区索引
设计父级索引与分区索引
分区表真正保存数据的是叶子分区,因此索引设计既要决定“所有分区都保持一致”,也要允许热点分区按自身负载增加专用索引。本课用父级分区索引与单分区本地索引各做一次,建立可维护的索引边界。
学习目标
- 理解父级分区索引与叶子索引的关系
- 根据跨分区一致查询和单分区热点查询选择索引层级
- 用系统目录验证索引是否属于同一个分区索引家族
父级索引不是一份跨分区数据结构
在分区表上执行普通 CREATE INDEX 时,PostgreSQL 会创建一个分区索引作为父级元数据,并确保每个现有分区都有等价的子索引。父级索引本身不保存数据,真正参与扫描的是叶子分区上的索引;以后新建或挂载分区时,也会检查并补齐对应索引。
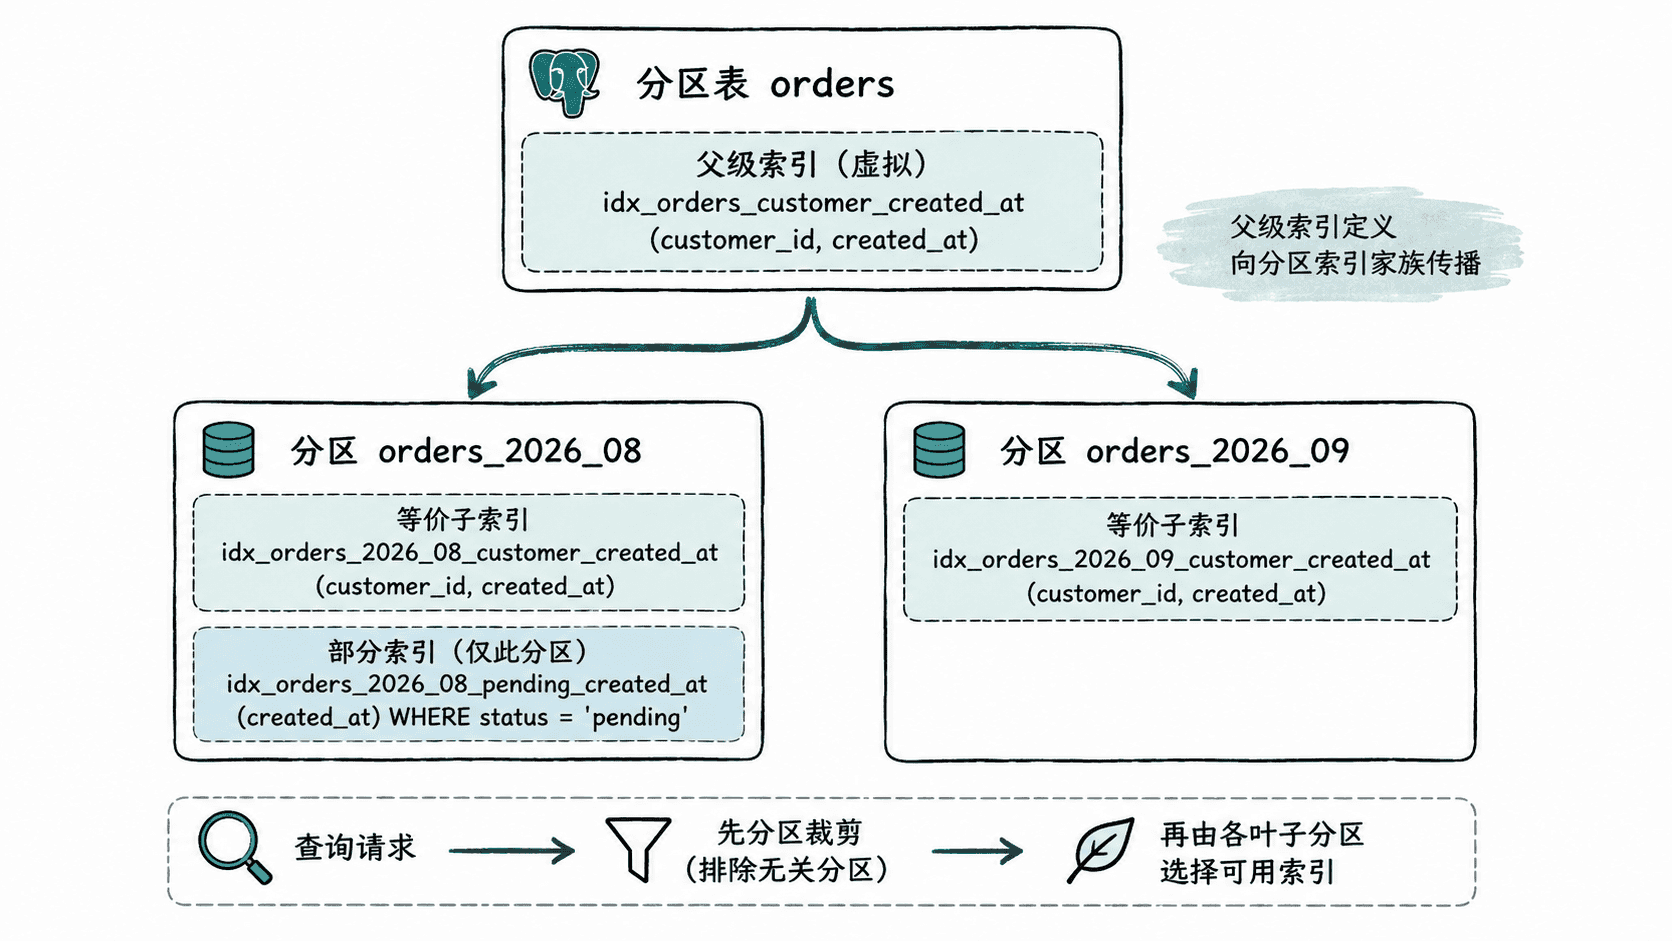
这意味着“在父表上建索引”更像声明一条全分区索引策略。如果查询在所有时间分区上都使用同一组过滤、连接或排序列,把索引定义放在父表最容易保证一致性,也能避免新增分区漏建索引。
按查询模式决定一致还是差异化
假设订单按 created_at 月分区,常见查询是“先按月份裁剪,再按客户查最近订单”。(customer_id, created_at DESC) 适合做父级索引,因为每个月都需要同样的访问路径。
如果只有当前热点分区频繁处理 status = 'pending' 的待处理订单,则可以只在该叶子分区建立部分索引。这个本地索引不会传播到兄弟分区,也不属于父级索引家族,但查询裁剪到该分区后,优化器仍可单独使用它。
这种差异化适合冷热分区负载明显不同的场景。不要为了“结构整齐”把只服务热点数据的索引复制到全部历史分区,否则会增加存储占用、写放大和后续维护成本。
建立两种索引并验证归属
下面创建两个按月分区。第一个索引建在父表上,因此形成两个已挂接的子索引;第二个索引只建在八月分区上,用部分条件服务热点状态。
DROP TABLE IF EXISTS orders CASCADE;

CREATE TABLE orders (
    order_id bigint GENERATED ALWAYS AS IDENTITY,
    customer_id bigint NOT NULL,
    created_at timestamptz NOT NULL,
    status text NOT NULL
) PARTITION BY RANGE (created_at);

CREATE TABLE orders_2026_08 PARTITION OF orders
FOR VALUES FROM ('2026-08-01') TO ('2026-09-01');

CREATE TABLE orders_2026_09 PARTITION OF orders
FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');

CREATE INDEX idx_orders_customer_created_at
ON orders (customer_id, created_at DESC);

CREATE INDEX idx_orders_2026_08_pending_created_at
ON orders_2026_08 (created_at)
WHERE status = 'pending';

SELECT count(*) AS attached_child_indexes
FROM pg_inherits
WHERE inhparent = 'idx_orders_customer_created_at'::regclass;

SELECT count(*) AS august_local_partial_indexes
FROM pg_indexes
WHERE schemaname = current_schema()
  AND tablename = 'orders_2026_08'
AND indexname = 'idx_orders_2026_08_pending_created_at';预期输出中,两条查询都得到稳定的计数;DROP TABLE IF EXISTS 是否额外打印 NOTICE 取决于对象此前是否存在。
 attached_child_indexes
------------------------
                      2

 august_local_partial_indexes
-------------------------------
                             1
第一个计数说明父级索引已经挂接两个子索引;第二个计数只证明八月分区存在额外的本地部分索引,它不会出现在第一个索引家族中。
别把父级一致性和全局唯一性混为一谈
父级索引能统一定义,但不代表 PostgreSQL 建成一棵跨所有分区的物理 B-tree。唯一索引或主键若定义在分区表上,唯一键必须包含分区键的全部列,才能依靠各叶子分区的唯一性共同保证整体约束。
索引层级最终应服从查询模式:稳定、长期一致的访问路径放在父表;只服务个别热点或历史分区的索引留在叶子分区。这样既保留自动继承能力,也不会让每个分区背上完全相同的索引负担。