
音频开发 / 系统课时
识别整数浮点与大小端样本
识别整数浮点与大小端样本
同一串 PCM 字节,如果把整数当浮点、把小端当大端,数值会完全不同,听感通常表现为爆音、噪声或近乎静音。本篇建立样本类型与字节序的判断顺序,并把十六进制原始数据还原成正确样本值。
学习目标
- 区分有符号整数 PCM 与浮点 PCM 的数值范围和字节解释方式。
- 理解小端与大端如何改变多字节样本的数值。
- 使用十六进制字节和 Python
struct验证样本解释是否正确。
先判断样本的数值类型
PCM 只是“按固定节奏排列的样本值”,原始字节本身不会告诉你这些值是什么类型。解析前至少要知道位深、整数或浮点类型、是否有符号、声道数和字节序。
常见表示可以先这样记:
| 表示 | 典型范围 | 关键点 |
|---|---|---|
| signed int16 | -32768~32767 | 0 表示零幅度,负数和正数分别表示波形两侧 |
| signed int24 | -8388608~8388607 | 常按 3 字节存储,需要自己处理符号扩展 |
| float32 PCM | 通常约 -1.0~1.0 | 常用 IEEE 754 单精度,0.0 表示零幅度 |
浮点 PCM 的处理中间值有时允许暂时超过 [-1.0, 1.0],但输出到设备或整数 PCM 前通常仍需要限幅。另一个常见例外是经典 WAV 的 8 bit PCM 通常使用无符号整数,因此不能把“PCM 整数一定有符号”当成绝对规则。
再判断多字节样本的字节序
字节序只影响由两个及以上字节组成的数值。小端序把最低有效字节放在前面,大端序则把最高有效字节放在前面。以两个字节 00 80 为例,把它们解释为 signed int16 时,小端得到 0x8000 = -32768,大端得到 0x0080 = 128。
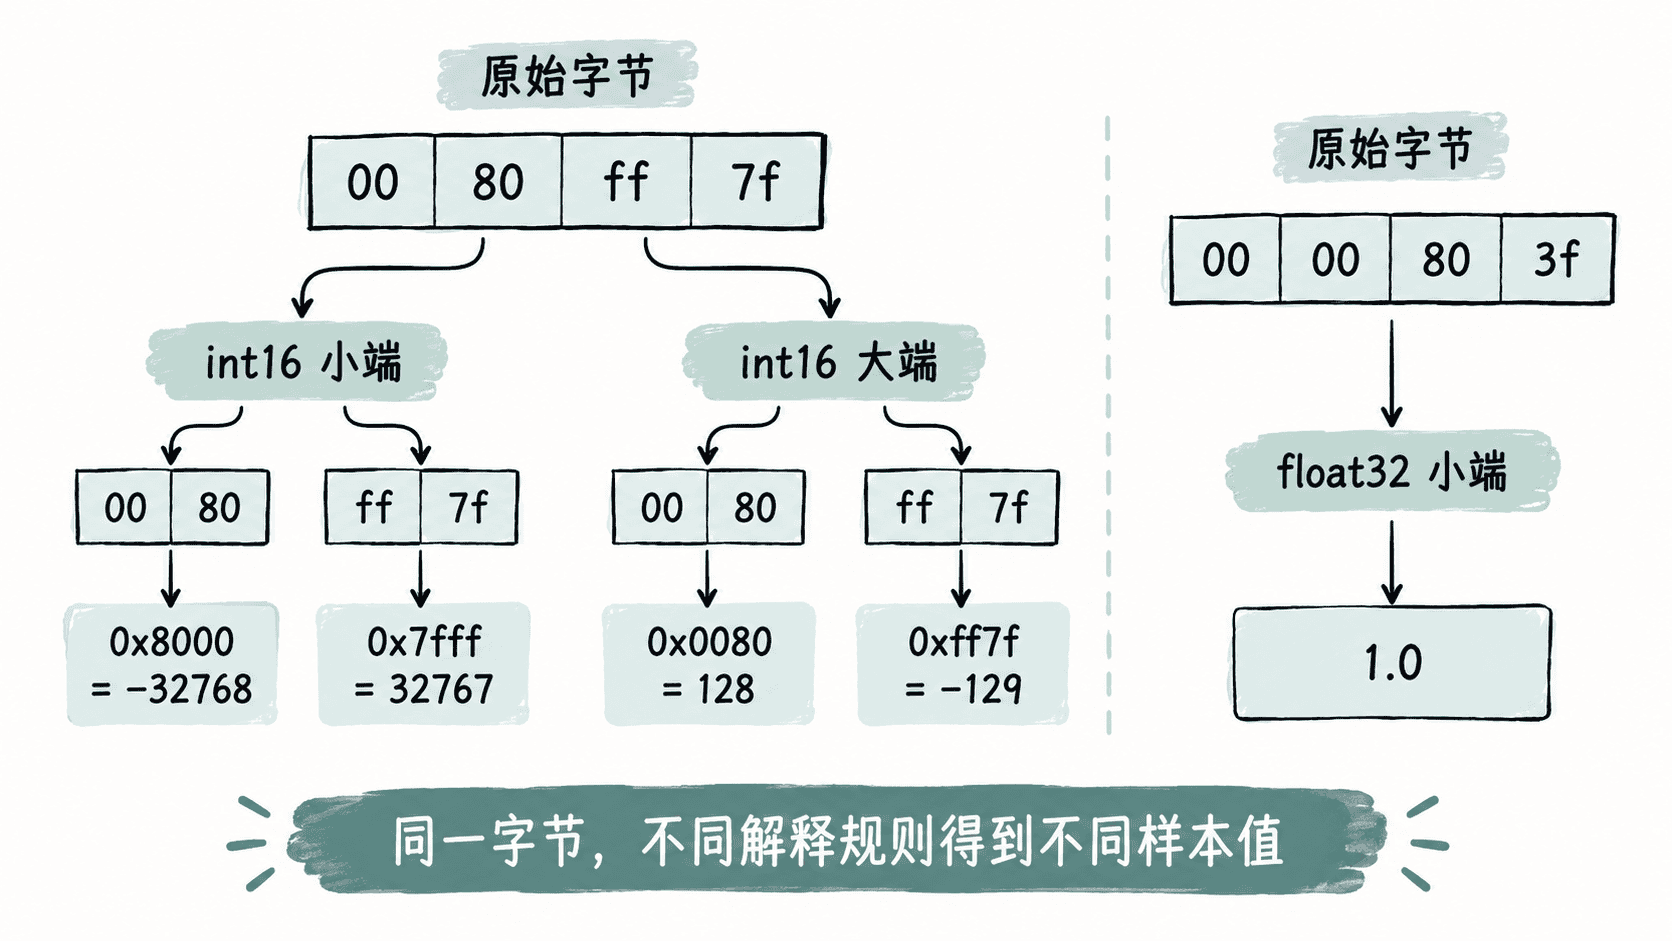
经典 RIFF/WAVE 的多字节 PCM 通常按小端存储,而 AIFF 传统上常见大端。真正可靠的做法仍是读取格式规范或容器元数据,而不是根据文件扩展名或听感猜测。
从十六进制还原样本
Python 的 struct 很适合做最小验证:< 表示小端,> 表示大端,h 表示 signed int16,f 表示 float32。下面让同一组字节分别按不同规则解码。
import struct

raw_int16 = bytes.fromhex("00 80 ff 7f")
little_int16 = struct.unpack("<hh", raw_int16)
big_int16 = struct.unpack(">hh", raw_int16)

raw_float32 = bytes.fromhex("00 00 80 3f")
little_float32 = struct.unpack("<f", raw_float32)[0]
big_float32 = struct.unpack(">f", raw_float32)[0]

print("int16 little:", little_int16)
print("int16 big:", big_int16)
print(f"float32 little: {little_float32:.3f}")
print(f"float32 big: {big_float32:.3e}")
预期输出:
int16 little: (-32768, 32767)
int16 big: (128, -129)
float32 little: 1.000
float32 big: 4.601e-41
结果说明两件事:字节没有变化,变化的是解释规则;而且“解析成功”不代表“解析正确”,因为错误的类型或端序往往仍能得到一个合法数值,只是这个数值没有音频意义。
识别错读时的症状
整数类型读错时,最常见的是整体幅度异常、持续噪声或波形严重失真。把 float32 当 int32 时,IEEE 754 的位模式会被当作巨大整数;把 int16 大小端弄反时,低字节和高字节互换,也会让原本平滑的样本序列突然跳变。
排查时不要先凭耳朵调增益。先固定取前几个样本,打印原始十六进制字节,再分别确认“样本宽度 → 数值类型 → 有无符号 → 字节序”。如果是多声道,还要在此之后确认交错顺序,例如 L,R,L,R 是否与格式声明一致。
判断 PCM 是否解释正确,本质上是在回答“这些字节按什么规则组成一个样本”。只要先确定类型,再确定字节序,并用少量已知字节做数值验证,就能在进入播放或 DSP 之前发现绝大多数格式解释错误。