
音频开发 / 系统课时
排查累积延迟与缓冲堆积
排查累积延迟与缓冲堆积
实时音频“越播越慢”时,先不要直接调大缓冲区。真正要区分的是固定延迟和持续积压:前者通常来自既定缓冲深度,后者说明某一级长期“进得快、出得慢”。本篇用队列水位、处理耗时和时钟趋势定位第一个开始增长的环节。
学习目标
- 区分固定延迟、瞬时抖动与持续累积延迟
- 沿采集、网络、播放链路读取队列水位并找到首个积压点
- 根据线程阻塞、网络抖动和时钟漂移选择对应修复方式
先判断延迟是否真的在累积
固定延迟的特征是“高但稳定”。例如采集缓冲 40 ms、抖动缓冲 60 ms、播放缓冲 40 ms,总端到端延迟可能长期保持在约 140 ms;它影响交互体验,但不会随着运行时间继续恶化。
累积延迟则表现为队列水位或端到端时间差持续上升。短时峰值后又回落,多半只是抖动;连续几十秒只升不降,才说明消费速率长期低于生产速率。
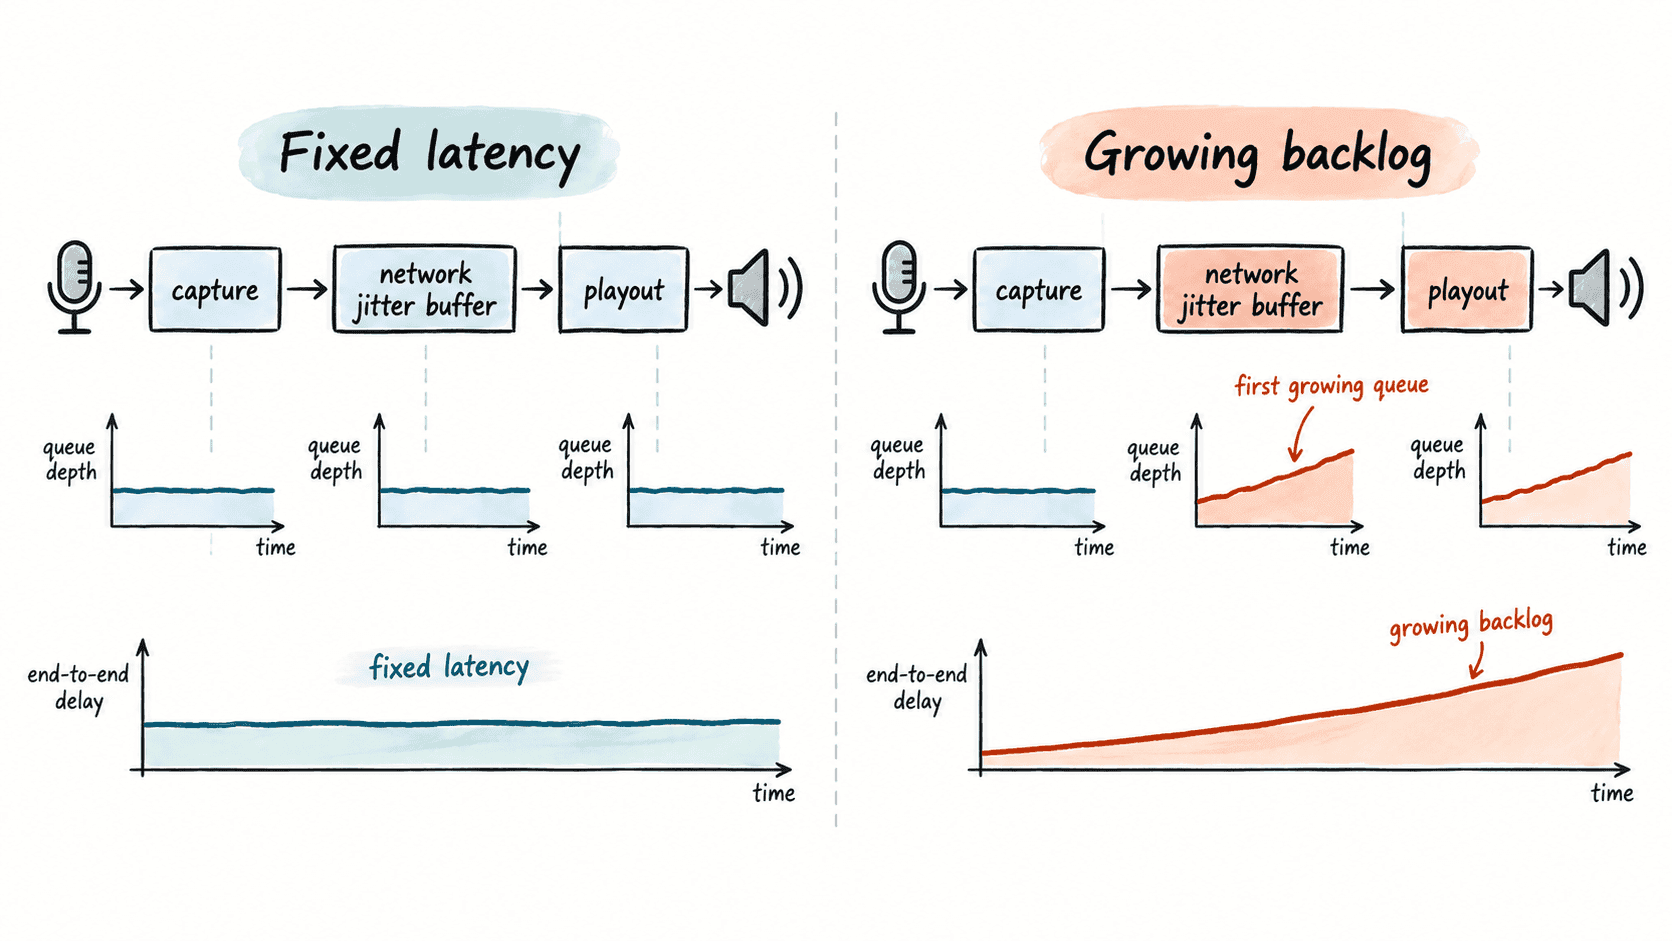
顺着队列水位找第一个增长点
排查时要同时观察采集、网络发送或接收、解码前后、播放缓冲几个位置。关键不是“哪个队列最大”,而是“哪个队列最先出现持续正斜率”。后级队列经常只是被上游积压拖累。
建议让所有指标使用同一时间基准,并记录队列长度、入队速率、出队速率、单次处理耗时和丢包率。若一个线程偶发阻塞,队列会先抬高后回落;若平均处理耗时已经超过音频帧间隔,队列通常会持续增长。
用时间序列确认积压趋势
下面的脚本用五次采样模拟三个队列,并计算首尾平均斜率。真实系统可以把 samples 替换成监控接口或日志采集得到的数据。
samples = {
    "capture": [2, 2, 2, 2, 2],
    "network": [3, 4, 6, 9, 13],
    "playout": [4, 5, 7, 10, 14],
}

threshold = 0.5

for name, values in samples.items():
    slope = (values[-1] - values[0]) / (len(values) - 1)
    state = "growing" if slope > threshold else "stable"
    print(f"{name}: slope={slope:.1f} frames/sample, {state}")

first_growing = next(
    name
    for name, values in samples.items()
    if (values[-1] - values[0]) / (len(values) - 1) > threshold
)
print(f"first growing queue: {first_growing}")
预期输出
capture: slope=0.0 frames/sample, stable
network: slope=2.5 frames/sample, growing
playout: slope=2.5 frames/sample, growing
first growing queue: network
这个结果说明采集端没有堆积,网络队列最先失稳,播放端的增长更可能是后果而不是根因。实际值会随采样周期和队列单位变化,因此重点看趋势而不是照抄阈值。
把趋势对应到具体根因
如果某一级队列持续增长,同时处理耗时出现长尾,优先检查锁竞争、磁盘或日志同步写、GC、音频回调中执行重计算等线程阻塞。实时线程应只做有界工作,把不可预测的任务移出回调。
如果队列呈锯齿状并伴随丢包、重传或到达间隔抖动,重点检查网络抖动与抖动缓冲策略。缓冲区需要吸收短时波动,但必须设上限和丢弃或追赶策略,避免把网络问题变成无限排队。
若所有处理耗时都正常、没有明显丢包,但队列以很小斜率长期增长,应怀疑时钟漂移。采集设备与播放设备即使只差几十 ppm,运行足够久也会积累可见偏差。此时应使用重采样、时钟同步或基于水位的微速率调整,而不是继续扩大队列。
验证链路重新稳定
修复后至少连续观察一个足够覆盖问题复现周期的窗口。通过标准不是“延迟降低了一次”,而是各级队列在波动后能回到目标区间,端到端延迟不再随时间单调上升,且没有用高丢帧率换取表面稳定。
当第一个增长点消失、后级队列也随之恢复时,才能确认修复命中了根因;如果首个增长点仍在,只是总延迟暂时变小,说明积压机制仍未被解除。