
音频开发 / 系统课时
把裸 PCM 封装成 WAV 文件
把裸 PCM 封装成 WAV 文件
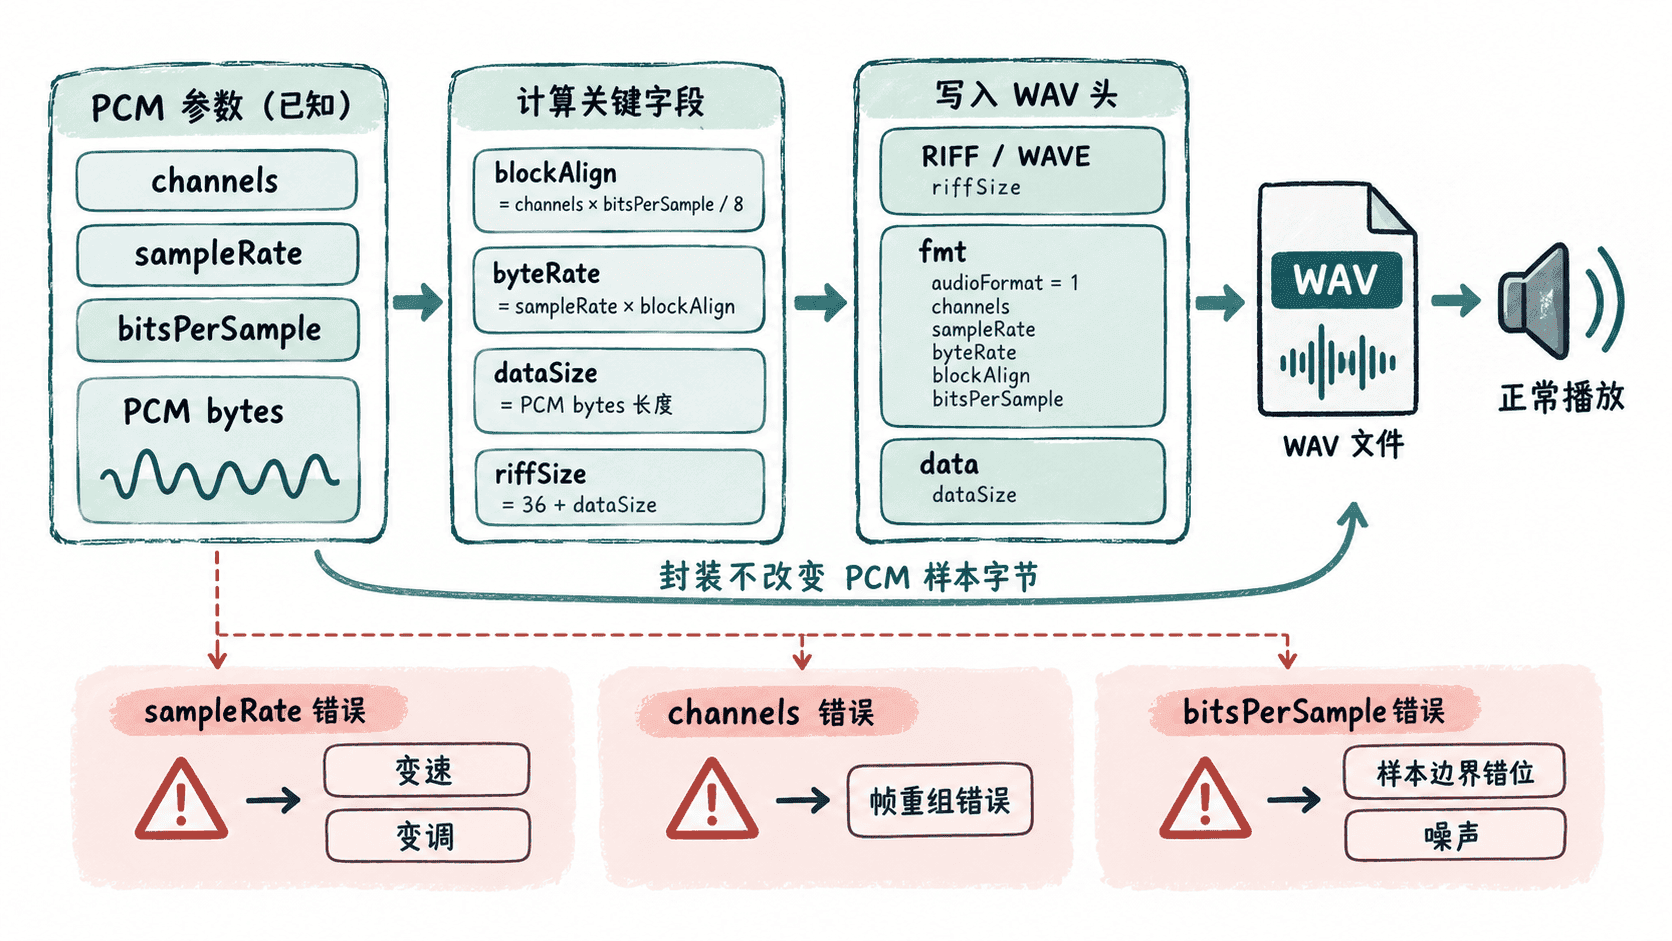
裸 PCM 只有连续样本,没有采样率、位深和声道等自描述信息。把这些参数写进正确的 RIFF/WAVE 头,再追加原始样本,就能得到播放器可识别的 WAV;参数一旦声明错误,播放速度、时长和样本边界都会被错误解释。
学习目标
- 根据已知 PCM 参数计算
blockAlign、byteRate、dataSize和 RIFF 长度。 - 手工构造最小 PCM WAV 头,并把裸样本原样追加到
data块。 - 解释采样率、位深和声道声明错误分别会造成什么播放异常。
WAV 头记录的是解释规则
封装不会重新编码 PCM 样本。它只是把“这些字节该怎样解释”的元数据写在样本前面。对经典未压缩 PCM WAV,关键关系是:每帧字节数由声道数和位深决定,字节率由采样率和每帧字节数决定。
blockAlign = channels × bitsPerSample / 8,byteRate = sampleRate × blockAlign。dataSize 等于原始 PCM 字节数;在没有额外 chunk 的最小 PCM WAV 中,RIFF 的 size 字段为 36 + dataSize。
手工写出一个可播放 WAV
下面的完整示例先生成 1 秒、8 kHz、单声道、16 位的小振幅正弦 PCM,再手工写入 44 字节的最小 PCM WAV 头。最后使用 Python 标准库 wave 重新读取文件,验证头部声明与实际数据一致。
import math
import struct
import wave

sample_rate = 8000
channels = 1
bits_per_sample = 16
duration_seconds = 1
frequency = 440

# 先生成可验证的裸 PCM;封装阶段不会改动这些样本字节。
samples = []
for i in range(sample_rate * duration_seconds):
    value = int(12000 * math.sin(2 * math.pi * frequency * i / sample_rate))
    samples.append(value)

pcm = struct.pack("<%dh" % len(samples), *samples)
with open("demo.pcm", "wb") as f:
    f.write(pcm)

# 头部派生字段必须从真实 PCM 参数和字节数计算。
block_align = channels * bits_per_sample // 8
byte_rate = sample_rate * block_align
data_size = len(pcm)
riff_size = 36 + data_size

# 这是无额外 chunk 时的经典 44 字节 PCM WAV 头。
header = struct.pack(
    "<4sI4s4sIHHIIHH4sI",
    b"RIFF", riff_size, b"WAVE",
    b"fmt ", 16, 1, channels, sample_rate,
    byte_rate, block_align, bits_per_sample,
    b"data", data_size
)

# 先写头,再原样追加 data 负载。
with open("demo.wav", "wb") as f:
    f.write(header)
    f.write(pcm)

# 重新读取验证播放器会采用的解释参数。
with wave.open("demo.wav", "rb") as wav:
    frames = wav.getnframes()
    print(f"pcm_bytes={len(pcm)}")
    print(f"wav_bytes={len(header) + len(pcm)}")
    print(f"channels={wav.getnchannels()}")
    print(f"sample_rate={wav.getframerate()}")
    print(f"sample_width={wav.getsampwidth()}")
    print(f"frames={frames}")
    print(f"duration={frames / wav.getframerate():.3f} s")
预期输出
pcm_bytes=16000
wav_bytes=16044
channels=1
sample_rate=8000
sample_width=2
frames=8000
duration=1.000 s
demo.pcm 与 demo.wav 的样本负载完全相同;WAV 只比裸 PCM 多出本例的 44 字节头。实际项目若还有 LIST、fact 等额外 chunk,文件头自然会更长。
参数写错为什么会听起来不对
采样率写错时,播放器会按错误的“每秒样本数”消费同一批数据。例如实际是 8 kHz,却声明成 16 kHz,播放器会在约一半时间内播完,声音更快且音高更高。
位深写错会改变每个样本占多少字节。实际 16 位却声明成 8 位时,播放器会从错误的字节边界切样本,通常直接表现为强噪声或失真。声道数写错则会改变一帧中样本的分组方式,例如把单声道数据声明成立体声,会把相邻样本误当作左右声道。
dataSize 也必须与真正写入的数据一致。声明过小会让播放器提前结束,声明过大则可能导致解析器尝试读取文件末尾之后的数据;严谨的封装器应以实际 PCM 字节数计算它,而不是依赖人工填写。
封装前先确认 PCM 约定
裸 PCM 本身没有办法告诉程序它是几声道、多少 Hz、几位或采用什么字节序,因此这些参数必须来自采集端、协议或业务约定。经典 RIFF/WAV 的整数 PCM 使用小端字节序;如果源数据不是小端 16 位整数,不能只改 WAV 头就假装格式已经转换。
封装成功的判断标准不是“文件能打开”,而是头部参数与样本真实布局一致、帧数能整除 blockAlign,并且计算出的播放时长符合预期。只要这三点一致,播放器对 PCM 字节的解释才是稳定的。