
音频开发 / 系统课时
理解设备流与音频回调线程
理解设备流与音频回调线程
实时音频最关键的不是“线程跑得快”,而是回调必须在设备给定的时间预算内稳定完成。本篇从设备、流和回调的调用关系出发,建立实时线程的边界,并用一个可运行的预算模拟器解释阻塞、锁竞争和临时分配为何会演变成爆音。
学习目标
- 说清音频设备、输入输出流与回调线程之间的调用关系
- 根据采样率和每次回调帧数计算单次处理的时间预算
- 识别实时回调中容易造成 underrun、overrun 或爆音的高风险操作
设备流不是普通函数循环
应用打开音频设备后,底层音频后端会创建输入流、输出流或双工流。设备按固定节奏消耗或产生一批 PCM 帧,后端因此周期性触发回调;应用不是想什么时候处理就什么时候处理,而是被设备时钟持续“推着走”。
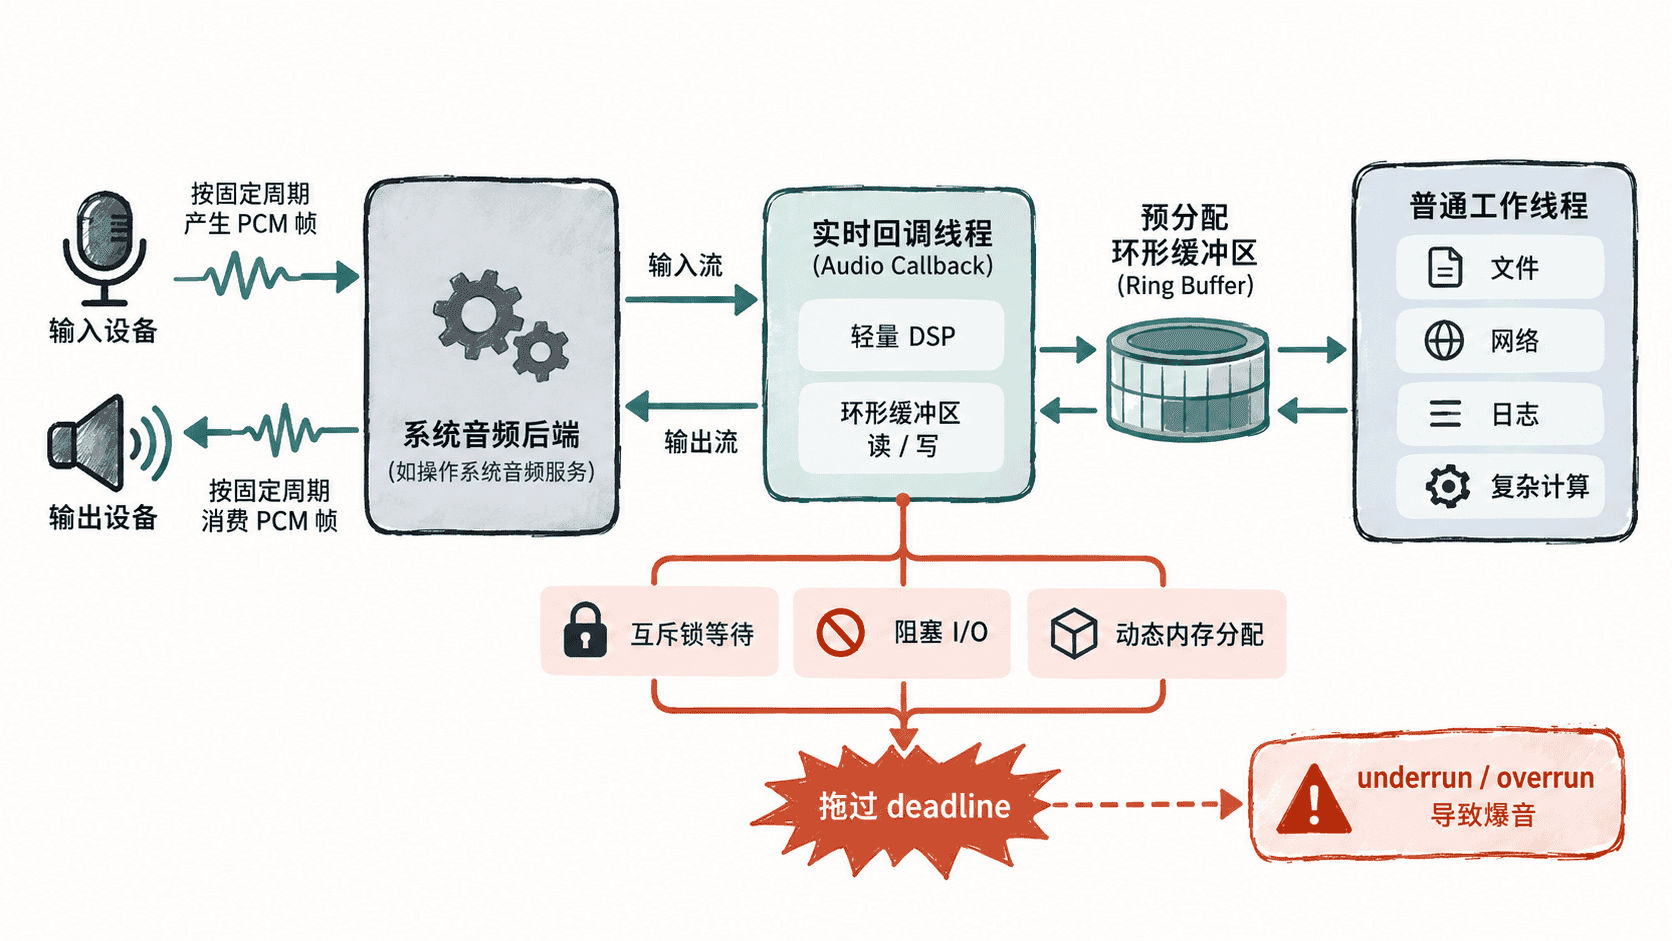
输入回调需要在下一批设备数据到来前取走或处理当前帧,否则输入缓冲可能溢出;输出回调则必须及时补足下一批样本,否则设备会读到空缓冲,产生断裂、静音或咔哒声。双工场景同时受两边时序约束。
用帧数计算回调时间预算
若采样率为 ,每次回调处理 帧,那么理论回调周期为 秒。48 kHz、每次 480 帧时,单次预算只有 10 ms;真正工程里还要给调度抖动和下游处理留余量,所以不能把 10 ms 全部用满。
下面用一个可运行的 Python 程序模拟几种回调工作量是否超过预算。它不访问真实设备,只验证 deadline 判断逻辑。
sample_rate = 48_000
frames_per_callback = 480
budget_ms = frames_per_callback / sample_rate * 1000

workloads_ms = [1.5, 4.0, 11.2]

print(f"budget={budget_ms:.1f} ms")
for index, cost in enumerate(workloads_ms, start=1):
    status = "OK" if cost < budget_ms else "XRUN_RISK"
    print(f"callback {index}: cost={cost:.1f} ms -> {status}")
预期输出
budget=10.0 ms
callback 1: cost=1.5 ms -> OK
callback 2: cost=4.0 ms -> OK
callback 3: cost=11.2 ms -> XRUN_RISK
这里的 XRUN_RISK 只是教学标记:真实系统可能报告 underrun、overrun、xrun,也可能只表现为可听见的爆音。名称不同,本质都是回调没有按设备节奏完成。
实时回调里最危险的操作
实时线程追求的是有上界的执行时间。文件读写、网络请求、等待条件变量都可能阻塞;普通互斥锁看似只保护几个字段,却可能因为其他线程长时间持锁而把回调拖到 deadline 之外。
动态内存分配同样应尽量避免。malloc、容器扩容、垃圾回收或首次创建对象都可能触发不可预测的慢路径。更稳妥的做法是在启动流之前预分配工作缓冲,并让回调复用固定大小的数据块。
日志也不适合直接写在高频回调里。需要观测状态时,可以只更新无锁计数器或写入固定容量的事件缓冲,再由普通线程异步打印。
把非实时工作移出回调
可靠的结构是让回调只完成必须和设备时钟同步的工作,例如复制帧、轻量格式转换和短小 DSP;文件编码、波形分析、网络传输、复杂日志等交给普通工作线程。
两类线程之间通常通过预分配的环形缓冲区或其他无阻塞队列交换数据。这样即使后台任务偶尔变慢,也不会直接让设备回调等待;真正需要关注的就变成缓冲区是否过满或过空,以及系统能否在长期平均速率上保持平衡。
判断一段逻辑能否放进音频回调时,先问两个问题:它最坏会等多久,以及它是否可能触发锁、I/O 或不可预测的分配。只要答案无法给出明确上界,就应优先移到非实时线程。