
音频开发 / 系统课时
按帧长计算缓冲与延迟
按帧长计算缓冲与延迟
音频缓冲的“几帧”只有换算成毫秒才有工程意义。本节从采样率和每帧样本数计算帧时长,再把处理队列、网络抖动缓冲和播放队列的目标占用换算成累计排队延迟,用同一套公式做容量取舍。
学习目标
- 根据采样率与帧样本数计算单帧时长
- 区分缓冲容量上限、目标占用和实际排队延迟
- 估算多级缓冲的累计延迟,并据此调整稳定性余量
把帧长换算成时间
若采样率为 ,每帧包含 个“每声道样本”,单帧时长为:
例如 48 kHz 下,每帧 480 个样本就是 10 ms;每帧 240 个样本就是 5 ms。声道数不会改变这段时间长度,它只会改变一帧中需要搬运的样本总数和字节数。
多级缓冲按目标占用累加
设每一级缓冲的目标占用分别为 帧,那么仅由这些排队数据造成的基础延迟可估算为:
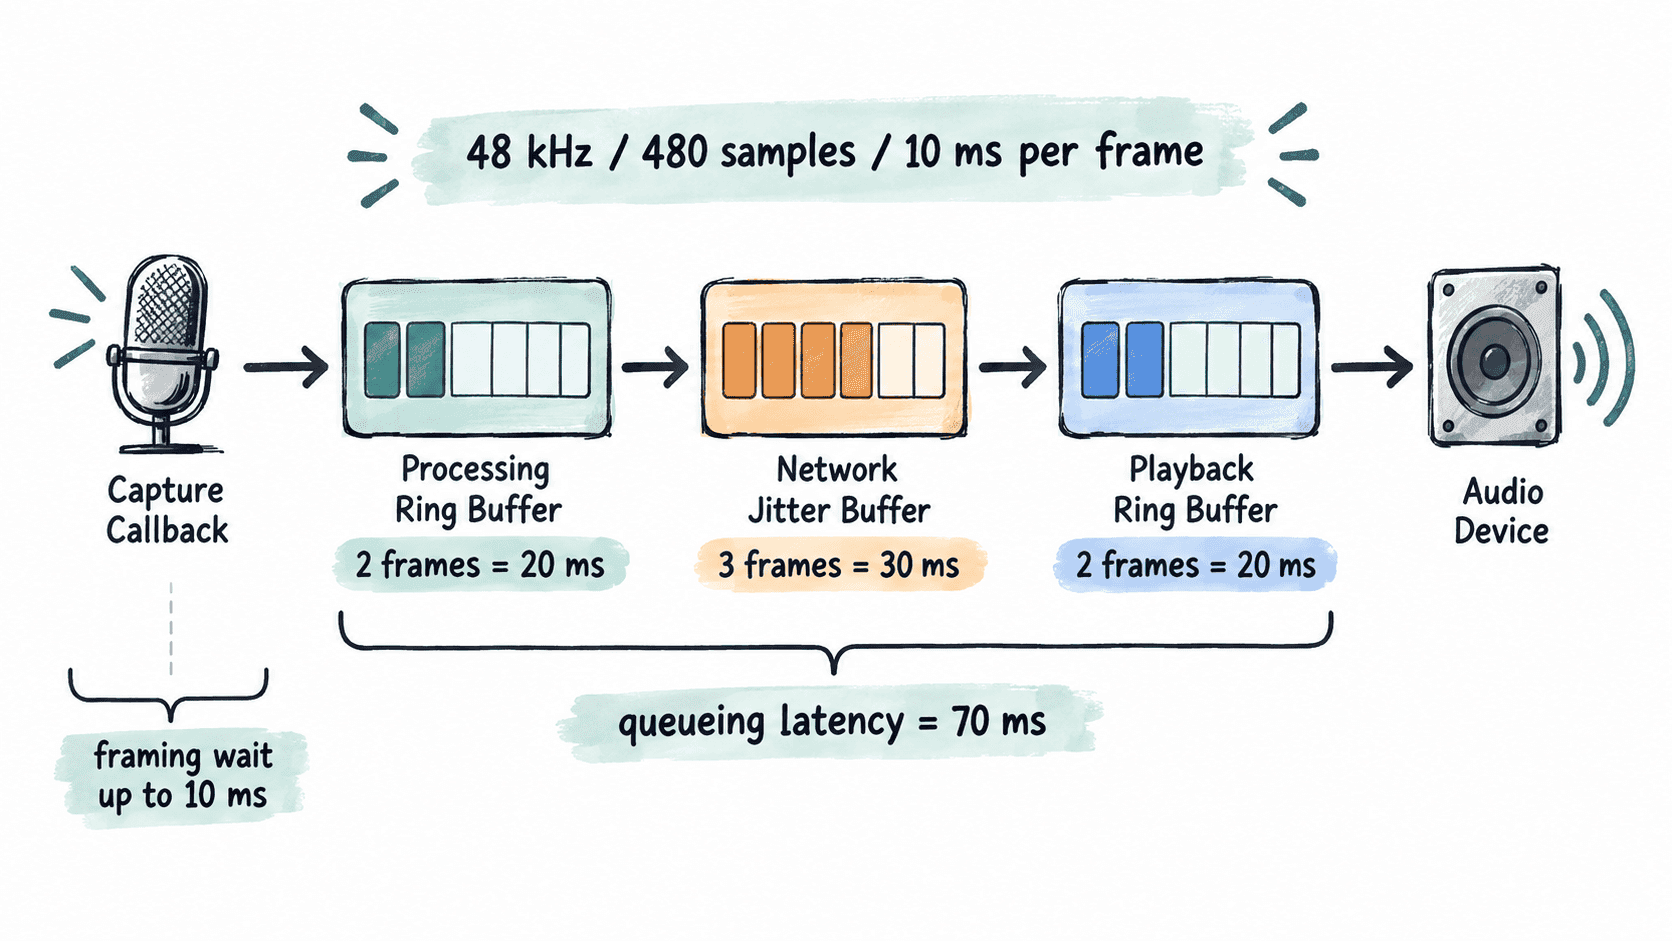
这里必须使用“目标占用”而不是“最大容量”。一个容量 8 帧的环形缓冲如果稳定时只保留 2 帧数据,其名义排队延迟按 2 帧计算;8 帧只是允许队列在抖动期间临时增长到的上限。
用程序核算延迟预算
下面的 Python 示例计算 48 kHz、480 样本一帧时,三个队列目标占用为 2、3、2 帧的排队延迟,并额外给出“再加一个完整帧聚合时间”的保守预算。
sample_rate = 48_000
frame_samples = 480

buffer_frames = {
    "processing": 2,
    "jitter": 3,
    "playback": 2,
}

frame_ms = frame_samples / sample_rate * 1000
queue_frames = sum(buffer_frames.values())
buffer_delay_ms = queue_frames * frame_ms
budget_with_one_frame_ms = buffer_delay_ms + frame_ms

print(f"frame_ms={frame_ms:.3f}")
print(f"queue_frames={queue_frames}")
print(f"buffer_delay_ms={buffer_delay_ms:.3f}")
print(f"budget_with_one_frame_ms={budget_with_one_frame_ms:.3f}")
预期输出
frame_ms=10.000
queue_frames=7
buffer_delay_ms=70.000
budget_with_one_frame_ms=80.000
70 ms 只代表三个缓冲的目标排队时间。80 ms 则把“为了凑齐一帧最多还要等待一个帧周期”也算进去。真实端到端延迟还可能包含设备内部缓冲、重采样、编解码算法、网络传输和系统调度,因此不要把这个结果直接当作最终实测值。
容量上限与实际延迟要分开看
缓冲容量回答的是“最多能存多少”,目标占用回答的是“稳定运行时希望存多少”,实际占用则随调度抖动不断变化。若某一级容量是 6 帧、目标占用是 2 帧,那么 10 ms 帧长下,名义排队延迟约 20 ms,而该级允许的排队上限是 60 ms。
因此排查延迟时应记录实际水位,而不只看配置值。若队列长期贴近上限,说明消费者平均速度不足或调度持续落后;若水位经常跌到 0,则说明容量或目标占用不足以吸收当前抖动。
用抖动反推最低缓冲
若希望缓冲吸收最长约为 毫秒的短时调度抖动,帧时长为 ,最低需要的缓冲帧数可先估算为:
例如帧长 10 ms、观测到约 15 ms 的短时抖动,至少需要 2 帧才能覆盖这段空窗。工程上通常再留少量安全余量,但每增加 1 帧目标占用,就会增加约 10 ms 的排队时间。
选择最终容量时同时看三件事:目标交互延迟、实际抖动分布和 overflow/underrun 次数。先用较小缓冲满足延迟目标,再依据实测故障率逐步增加余量,通常比直接把所有队列都放大更容易得到稳定且可控的实时链路。