
音频开发 / 系统课时
读懂 WAV 文件的 RIFF 结构
读懂 WAV 文件的 RIFF 结构
WAV 的关键不在“背 44 字节文件头”,而在按 RIFF 的块规则向后扫描。掌握块头、长度和偶数字节对齐后,就能从真实文件中读出采样参数,并可靠定位 PCM 数据的起始位置。
学习目标
- 识别
RIFF、WAVE、fmt、data等关键标记及其职责。 - 根据
fmt块解释采样率、位深、声道数、字节率和帧大小。 - 按块长度扫描文件,找到真实的
data负载偏移,而不是假定 PCM 永远从第 44 字节开始。
WAV 不是固定 44 字节的文件头
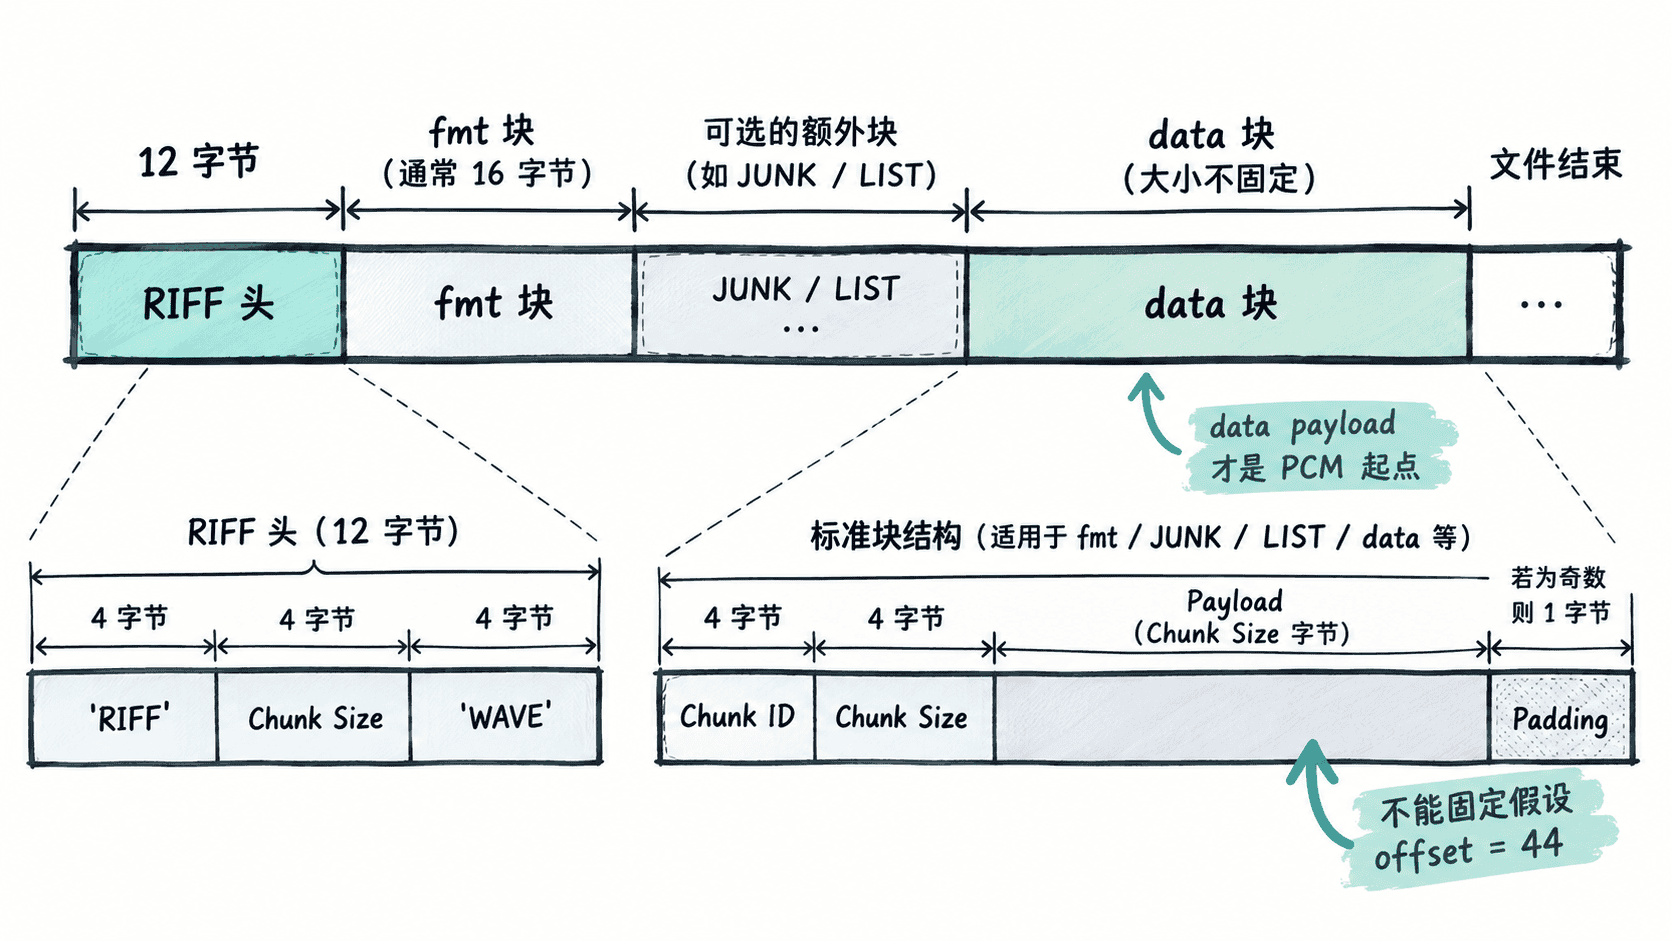
典型 PCM WAV 以 12 字节 RIFF 头开始:前 4 字节是 RIFF,随后 4 字节记录从当前位置之后到文件末尾的长度,接着 4 字节是 WAVE。后面不是固定字段表,而是一串可扩展的 chunk。
每个 chunk 都先写 4 字节标识和 4 字节长度,再写对应负载。最常见的 fmt 保存音频格式,data 保存样本;文件中还可能出现 JUNK、LIST、fact 等额外块,所以 data 的位置必须扫描得到。
fmt 块在未压缩 PCM 中通常至少包含这些值:audioFormat=1 表示 PCM,numChannels 是声道数,sampleRate 是采样率,bitsPerSample 是位深。还有两个可用于自检的派生量:blockAlign = 声道数 × 每样本字节数,byteRate = 采样率 × blockAlign。
按块长度定位 data
扫描从文件偏移 12 开始。读取 8 字节 chunk 头后,用其中的长度跳过负载;如果负载长度是奇数,还要再跳过 1 字节填充,使下一个 chunk 从偶数字节边界开始。遇到 data 时,当前负载起点就是 PCM 数据起点。
用代码验证块偏移
下面的完整 Python 示例故意在 fmt 与 data 之间插入一个 3 字节 JUNK 块,并按 RIFF 规则补 1 字节 padding。程序随后逐块解析并打印负载偏移。
import struct

def make_demo_wav() -> bytes:
    channels = 1
    sample_rate = 8000
    bits = 16
    block_align = channels * bits // 8
    byte_rate = sample_rate * block_align

    # 使用最小 PCM fmt 块,让字段与偏移关系保持清晰。
    fmt_payload = struct.pack(
        "<HHIIHH", 1, channels, sample_rate,
        byte_rate, block_align, bits
    )
    # JUNK 负载故意设为奇数长度,后面必须补 1 字节对齐。
    junk_payload = b"abc"
    samples = [0, 1000, -1000, 0]
    pcm = struct.pack("<4h", *samples)

    chunks = (
        b"fmt " + struct.pack("<I", len(fmt_payload)) + fmt_payload
        + b"JUNK" + struct.pack("<I", len(junk_payload)) + junk_payload + b"\x00"
        + b"data" + struct.pack("<I", len(pcm)) + pcm
    )
    # RIFF size 从 WAVE 标识开始计数,不包含文件最前面的 8 字节。
    return b"RIFF" + struct.pack("<I", 4 + len(chunks)) + b"WAVE" + chunks

wav = make_demo_wav()
riff, riff_size, wave = struct.unpack_from("<4sI4s", wav, 0)
print(f"RIFF size: {riff_size}")
print(f"Format: {wave.decode()}")

# 12 字节 RIFF 头之后逐块扫描,不能预设 data 的固定偏移。
offset = 12
while offset + 8 <= len(wav):
    chunk_id, chunk_size = struct.unpack_from("<4sI", wav, offset)
    payload_offset = offset + 8
    name = chunk_id.decode("ascii")
    print(f"{name}: size={chunk_size}, payload={payload_offset}")

    if chunk_id == b"fmt ":
        fields = struct.unpack_from("<HHIIHH", wav, payload_offset)
        print(
            "  PCM=%d, channels=%d, sample_rate=%d, byte_rate=%d, "
            "block_align=%d, bits=%d" % fields
        )
    if chunk_id == b"data":
        print(f"PCM data starts at byte {payload_offset}")
        break

    # chunk_size 不包含偶数字节对齐用的 padding。
    offset = payload_offset + chunk_size + (chunk_size & 1)
预期输出
RIFF size: 56
Format: WAVE
fmt : size=16, payload=20
  PCM=1, channels=1, sample_rate=8000, byte_rate=16000, block_align=2, bits=16
JUNK: size=3, payload=44
data: size=8, payload=56
PCM data starts at byte 56
这里 data 的负载从偏移 56 开始,直接证明“44 字节 WAV 头”只是最简 PCM 文件的常见结果,而不是通用规则。
解析时要守住的边界
读取真实文件时,先确认前 4 字节是 RIFF、格式标识是 WAVE,再检查每个 chunk 声明的长度没有越过文件末尾。对 fmt 块也不要只认 16 字节:其他 WAV 格式可能带扩展字段,解析器应读取自己需要的字段,再按 chunk_size 跳到下一个块。
如果目标是提取未压缩 PCM,还应确认格式确实是 PCM 或自己支持的编码类型。找到 data 只说明找到了音频负载,并不保证负载一定能按 16 位整数直接解释;真正的样本读取方式必须与 fmt 中声明的格式、声道数和位深一致。