
音频开发 / 系统课时
算清样本帧字节与音频时长
算清样本帧字节与音频时长
拿到一段 PCM 缓冲区后,最先要能回答两个问题:一个音频帧占多少字节,这段数据代表多长时间。本篇从样本、声道、帧和采样率的关系出发,给出可直接代入的换算公式,并用代码验证结果。
学习目标
- 区分单个样本、声道样本和样本帧,避免把“帧”误当成单声道数据。
- 根据采样率、声道数、位深和数据长度计算每秒字节数、数据大小与音频时长。
- 识别 24 位打包、容器对齐和文件头等会让简单公式失效的边界。
把样本、声道和帧对齐
PCM 中,样本表示某一个声道在某一采样时刻的数值;样本帧表示同一采样时刻所有声道样本的集合。双声道音频的一帧包含左、右两个样本,六声道音频的一帧则包含六个样本。
采样率描述“每个声道每秒产生多少个样本”,因此 48 kHz 双声道并不是每秒 48000 个总样本,而是每个声道 48000 个,一共 96000 个声道样本。
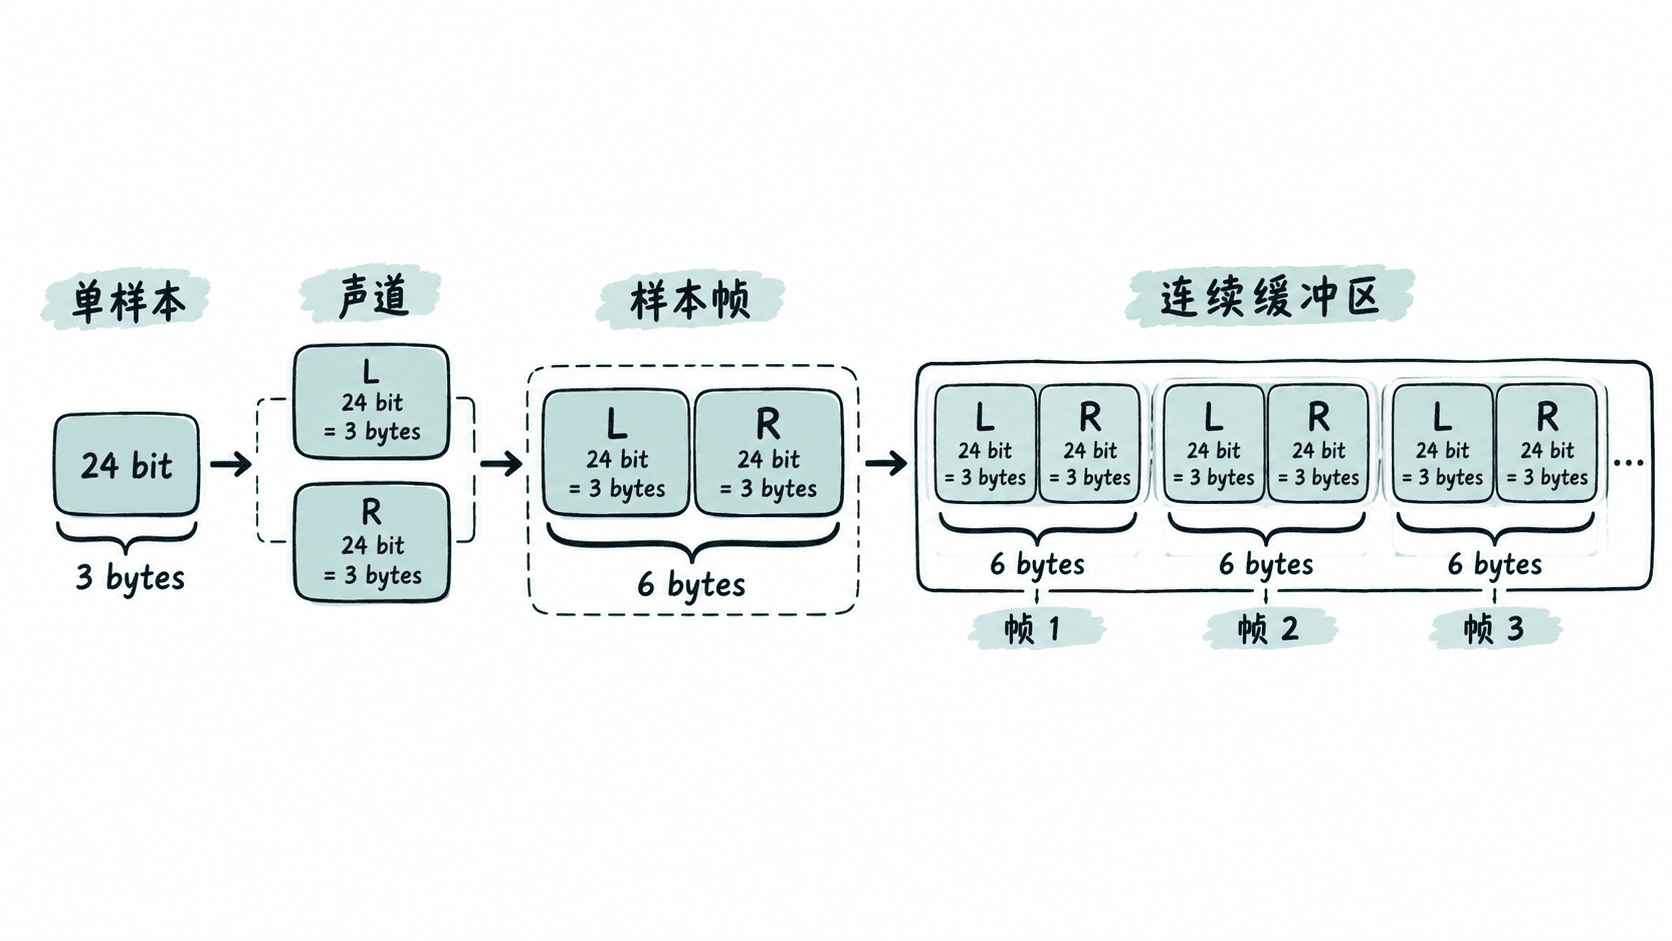
在这篇里“帧”特指 PCM sample frame,不是 AAC、MP3 等编码格式中的压缩帧。两者都叫 frame,但字节结构和时长含义完全不同。
用四个量完成换算
对紧密打包、没有额外填充字节的整数 PCM,可以按下面顺序计算:
- 每样本字节数 = 位深 ÷ 8。
- 每帧字节数 = 声道数 × 每样本字节数。
- 每秒字节数 = 采样率 × 每帧字节数。
- 时长 = PCM 数据字节数 ÷ 每秒字节数。
- 指定时长的数据大小 = 时长 × 每秒字节数。
例如 48 kHz、双声道、16 bit PCM:每样本 2 字节,每帧 4 字节,每秒需要 48000 × 4 = 192000 字节。因此恰好 192000 字节的纯 PCM 数据代表 1 秒音频。
用代码验证一段缓冲区
下面用 44.1 kHz、双声道、24 bit、5 秒 PCM 验证换算关系。这个示例假设 24 bit 样本按 3 字节紧密存储。
sample_rate = 44_100
channels = 2
bits_per_sample = 24
duration_seconds = 5

bytes_per_sample = bits_per_sample // 8
bytes_per_frame = channels * bytes_per_sample
bytes_per_second = sample_rate * bytes_per_frame
data_bytes = duration_seconds * bytes_per_second

recovered_duration = data_bytes / bytes_per_second

print(f"bytes/sample: {bytes_per_sample}")
print(f"bytes/frame: {bytes_per_frame}")
print(f"bytes/second: {bytes_per_second}")
print(f"data bytes: {data_bytes}")
print(f"duration: {recovered_duration:.3f} s")
预期输出:
bytes/sample: 3
bytes/frame: 6
bytes/second: 264600
data bytes: 1323000
duration: 5.000 s
如果实际拿到的缓冲区长度是 1323000 字节,就可以反向除以每秒字节数 264600,得到 5 秒。这个方法也适合估算实时音频回调中一块 buffer 覆盖的时间窗口。
处理真实数据时的边界
最常见的误差来自“位深”和“存储步长”并不总是同一个概念。24 bit PCM 可以紧密占 3 字节,也可能被某些 API 放进 32 bit 容器中,此时一个声道样本实际跨 4 字节。计算缓冲区大小时,应以真实的 sample stride 或格式描述符为准,而不是只看有效位数。
如果输入是 WAV 文件,也不能直接拿整个文件大小除以每秒字节数,因为文件还含有 RIFF/WAVE 头和可能的额外 chunk。应读取 data chunk 的长度,再计算 PCM 时长。
最后检查单位最有效:采样率的单位是“帧/秒”,每帧字节数的单位是“字节/帧”,两者相乘自然得到“字节/秒”。只要这条量纲链成立,样本、声道、帧和时长之间的换算通常就不会错。