
音频开发 / 系统课时
用 FFT 读取声音频谱成分
用 FFT 读取声音频谱成分
FFT 返回的是按频点索引排列的复数结果,而不是直接写着“多少 Hz”的频率列表。本篇把采样率、FFT 点数和频点索引连起来,再用可运行示例定位主频、谐波和噪声底,避免把数组下标误当成实际频率。
学习目标
- 根据采样率和 FFT 点数把频点索引换算成 Hz
- 从单边频谱中识别基频、谐波与宽带噪声特征
- 判断频率分辨率、奈奎斯特频率和幅度缩放带来的边界
先给 FFT 结果建立频率坐标
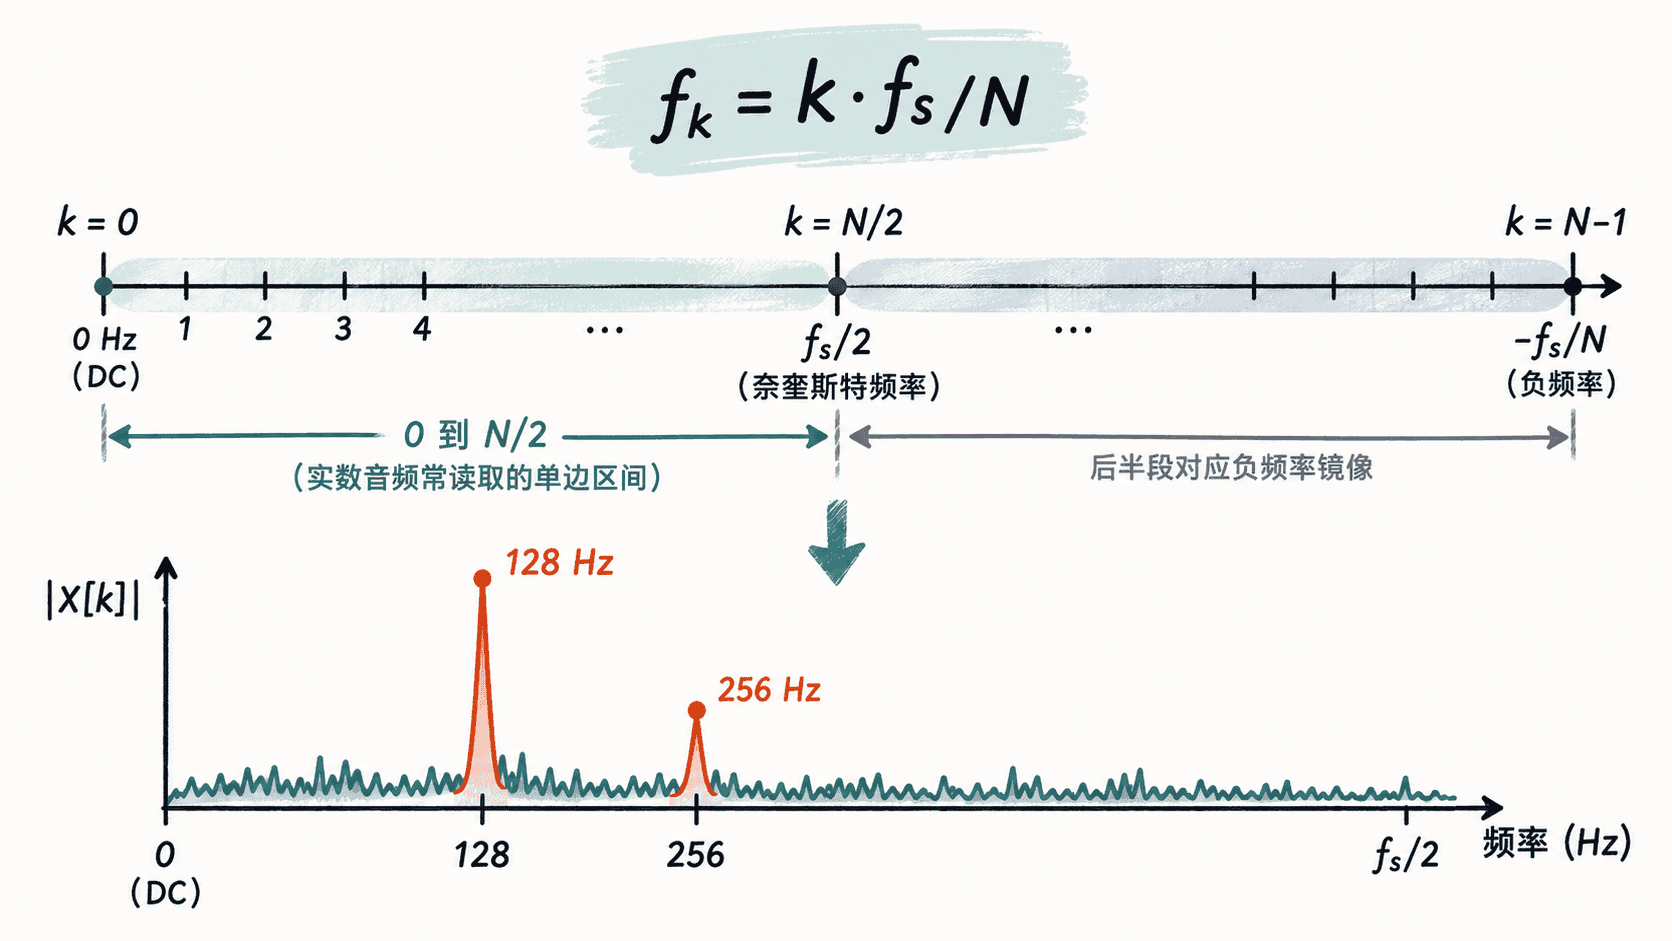
对长度为 、采样率为 的一帧数据做 点 FFT 后,相邻频点的间隔是:
第 个频点对应的实际频率为:
例如采样率为 48000 Hz、FFT 点数为 2048 时,频率间隔是 23.4375 Hz。数组索引 100 对应约 2343.75 Hz,而不是 100 Hz。
实数 PCM 的 FFT 频谱具有共轭对称性,因此观察普通幅度谱时通常只读取 到 。这部分覆盖直流到奈奎斯特频率 ;另一半可以理解为对应的负频率镜像。
用 FFT 找出主频和谐波
下面的示例使用 1024 Hz 采样率和 256 点 FFT,因此频率间隔恰好为 4 Hz。测试信号包含 128 Hz 基频、幅度较小的 256 Hz 二次谐波,并叠加少量确定性的伪随机噪声。
代码实现一个基数为 2 的 FFT,因此不依赖第三方库,可以直接保存为 Python 文件运行。
import math
import statistics

FS = 1024
N = 256

def fft(values):
    n = len(values)
    if n == 0 or n & (n - 1):
        raise ValueError("FFT length must be a power of two")

    data = [complex(value, 0.0) for value in values]

    # 先完成位反转排列,让后续蝶形计算可以原地执行。
    j = 0
    for i in range(1, n):
        bit = n >> 1
        while j & bit:
            j ^= bit
            bit >>= 1
        j ^= bit
        if i < j:
            data[i], data[j] = data[j], data[i]

    length = 2
    while length <= n:
        angle = -2 * math.pi / length
        step = complex(math.cos(angle), math.sin(angle))
        half = length // 2
        for start in range(0, n, length):
            weight = 1.0 + 0.0j
            for i in range(start, start + half):
                even = data[i]
                odd = data[i + half] * weight
                data[i] = even + odd
                data[i + half] = even - odd
                weight *= step
        length <<= 1

    return data

state = 123456789
samples = []
for i in range(N):
    # 固定的线性同余序列让每次运行都得到相同噪声。
    state = (1103515245 * state + 12345) & 0x7FFFFFFF
    noise = (state / 0x7FFFFFFF * 2.0 - 1.0) * 0.02
    t = i / FS
    samples.append(
        math.sin(2 * math.pi * 128 * t)
        + 0.4 * math.sin(2 * math.pi * 256 * t)
        + noise
    )

bins = fft(samples)
amplitudes = [2 * abs(bins[k]) / N for k in range(N // 2 + 1)]
amplitudes[0] /= 2
amplitudes[-1] /= 2

peak_bins = sorted(
    range(1, N // 2),
    key=lambda k: amplitudes[k],
    reverse=True,
)[:2]
peak_frequencies = sorted(round(k * FS / N, 1) for k in peak_bins)

excluded = set()
for peak in peak_bins:
    excluded.update(range(max(1, peak - 1), min(N // 2, peak + 2)))
noise_values = [
    amplitudes[k]
    for k in range(1, N // 2)
    if k not in excluded
]
noise_floor = statistics.median(noise_values)
reference = max(amplitudes[k] for k in peak_bins)
noise_floor_db = 20 * math.log10(noise_floor / reference)

print(f"resolution={FS / N:.1f} Hz")
print(f"peak_frequencies={peak_frequencies}")
print(f"noise_floor_below_-40dB={noise_floor_db < -40}")
预期输出:
resolution=4.0 Hz
peak_frequencies=[128.0, 256.0]
noise_floor_below_-40dB=True
128 Hz 是幅度最大的基频,256 Hz 恰好是它的两倍,因此结合信号来源可以判断为二次谐波。判断谐波不能只看“有峰值”,还要检查峰值是否接近基频的整数倍;固定频率的电源干扰或其他声音同样可能形成窄峰。
区分谐波和噪声分布
窄带音调通常表现为少数明显高于周围频点的峰。谐波则往往出现在 、 等基频整数倍附近,但实际声音中的非线性、窗口和频率偏移会让峰值覆盖多个频点。
宽带噪声更像许多频点共同抬高形成的“底”。分析噪声时,不应只盯着最大频点,而可以排除已知音调及其邻域,再观察剩余频点的中位数、分位数或功率谱密度。若要比较不同 FFT 长度下的噪声强度,功率谱密度通常比未经归一化的 FFT 幅值更合适。
读频谱时检查这些边界
频率分辨率由 决定。增加 FFT 点数会缩小频点间隔,但也意味着一帧覆盖更长时间;如果声音在这段时间内快速变化,更长的帧反而可能把不同时刻的频率状态混在一起。
对未加窗的实数正弦信号,普通正频率频点常使用 构造单边幅度谱,而直流和奈奎斯特频点不能再乘 2。若前面使用了窗口函数,还应补偿窗口的相干增益,否则峰值幅度会被系统性压低。
最后还要确认奈奎斯特边界。输入中高于 且未在采样前被滤除的频率会发生混叠,折返到较低频率区域。此时 FFT 能准确显示采样后的频谱,却无法仅凭结果恢复已经混叠的原始频率。
读 FFT 的可靠顺序是先确认采样率和点数,再把索引换算成 Hz,随后识别主峰及整数倍关系,最后观察峰值之外的噪声底。只要频率坐标这一步没有弄错,后续对声音成分的解释就有了正确基础。