
音频开发 / 系统课时
用环形缓冲解耦音频线程
用环形缓冲解耦音频线程
实时音频回调必须按设备节拍快速完成,而编码、网络和业务线程的耗时往往有抖动。本节用单生产者、单消费者环形缓冲把两端解耦,并用读写位置、容量和可用数据量判断满、空与延迟风险。
学习目标
- 解释环形缓冲如何隔离音频回调与后台线程的执行节拍
- 正确计算已用容量、剩余容量以及读写位置的推进方式
- 实现一个可运行的 SPSC 环形缓冲,并选择欠载与溢出策略
环形缓冲解决的是节拍不一致
设备回调通常由音频系统按固定周期唤醒。回调里如果等待编码器、网络发送或业务锁,阻塞时间就会直接挤占音频截止时间,最终形成爆音、断续或 underrun。环形缓冲把回调变成“只搬数据”的生产者,把耗时工作交给消费者异步处理。
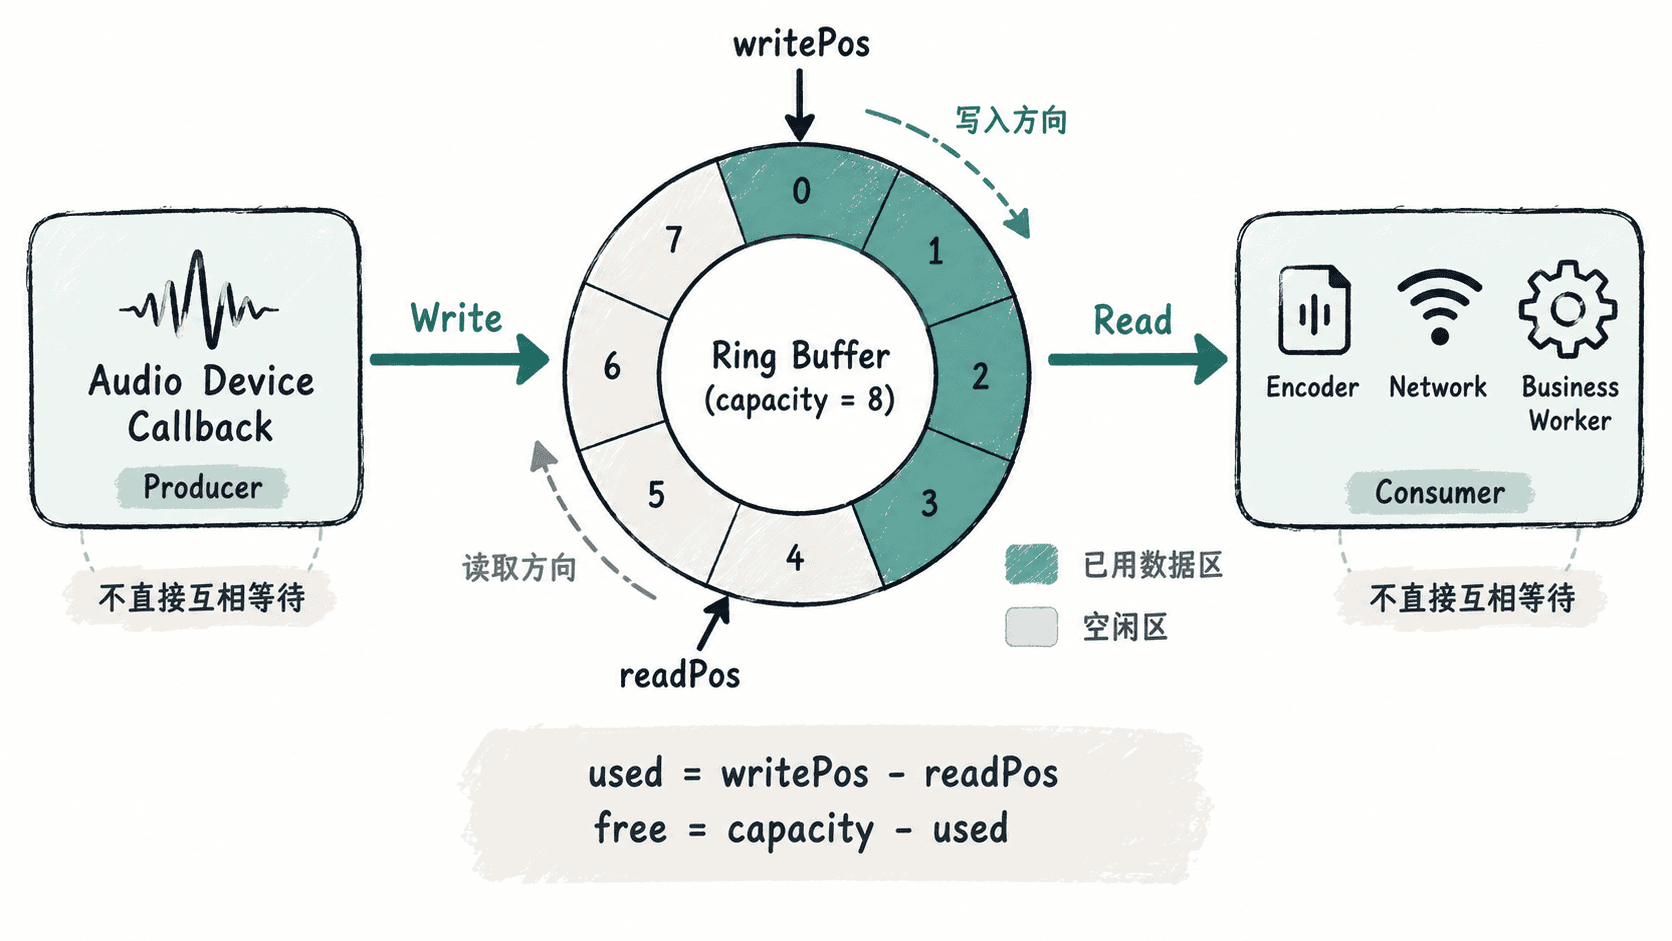
环形缓冲不会让系统“处理得更快”。它只是把短时抖动吸收到队列里:消费者长期平均速度仍必须不低于生产者,否则缓冲最终一定写满。
用逻辑位置计算可用数据
设容量为 C,写位置为 writePos,读位置为 readPos。这里让两个位置持续递增,真正访问数组时再对容量取模,因此不需要在指针绕回数组开头时额外判断前后关系。
已缓存的数据量为 writePos - readPos,剩余可写容量为 C - (writePos - readPos)。当两者相等时为空;当已用量等于 C 时为满。SPSC 场景中只有生产者推进 writePos,只有消费者推进 readPos,这是无锁实现能够保持简单的关键前提。
实现一个 SPSC 环形缓冲
下面的 C++17 示例使用固定容量数组和两个原子逻辑位置。生产者发布新 writePos 前先写完样本,消费者读取新位置后再访问数据;读侧采用同样的 acquire/release 配对保证可见性。
#include <algorithm>
#include <array>
#include <atomic>
#include <cstdint>
#include <iostream>

template <std::size_t Capacity>
class SpscRingBuffer {
public:
    std::size_t write(const int16_t* src, std::size_t count) {
        const std::size_t w = writePos_.load(std::memory_order_relaxed);
        const std::size_t r = readPos_.load(std::memory_order_acquire);
        const std::size_t free = Capacity - (w - r);
        const std::size_t n = std::min(count, free);

        for (std::size_t i = 0; i < n; ++i) {
            data_[(w + i) % Capacity] = src[i];
        }

        // 数据写完后再发布新的写位置。
        writePos_.store(w + n, std::memory_order_release);
        return n;
    }

    std::size_t read(int16_t* dst, std::size_t count) {
        const std::size_t r = readPos_.load(std::memory_order_relaxed);
        const std::size_t w = writePos_.load(std::memory_order_acquire);
        const std::size_t used = w - r;
        const std::size_t n = std::min(count, used);

        for (std::size_t i = 0; i < n; ++i) {
            dst[i] = data_[(r + i) % Capacity];
        }

        // 样本读完后再释放这些槽位给生产者。
        readPos_.store(r + n, std::memory_order_release);
        return n;
    }

    std::size_t availableRead() const {
        const std::size_t r = readPos_.load(std::memory_order_relaxed);
        const std::size_t w = writePos_.load(std::memory_order_acquire);
        return w - r;
    }

    std::size_t availableWrite() const {
        const std::size_t w = writePos_.load(std::memory_order_relaxed);
        const std::size_t r = readPos_.load(std::memory_order_acquire);
        return Capacity - (w - r);
    }

private:
    std::array<int16_t, Capacity> data_{};
    std::atomic<std::size_t> readPos_{0};
    std::atomic<std::size_t> writePos_{0};
};

int main() {
    SpscRingBuffer<8> buffer;

    const int16_t first[] = {100, 200, 300, 400, 500};
    std::cout << "written=" << buffer.write(first, 5)
              << " used=" << buffer.availableRead()
              << " free=" << buffer.availableWrite() << '\n';

    int16_t out[8]{};
    const std::size_t n1 = buffer.read(out, 3);
    std::cout << "read:";
    for (std::size_t i = 0; i < n1; ++i) {
        std::cout << ' ' << out[i];
    }
    std::cout << "\nused=" << buffer.availableRead()
              << " free=" << buffer.availableWrite() << '\n';

    const int16_t second[] = {600, 700, 800, 900};
    buffer.write(second, 4);

    const std::size_t n2 = buffer.read(out, 8);
    std::cout << "read:";
    for (std::size_t i = 0; i < n2; ++i) {
        std::cout << ' ' << out[i];
    }
    std::cout << '\n';
}
预期输出
written=5 used=5 free=3
read: 100 200 300
used=2 free=6
read: 400 500 600 700 800 900这个例子第二次写入时会跨过数组末尾并从开头继续,但调用方看不到“绕回”这一细节。逻辑位置负责计算数据量,取模只负责把逻辑位置映射到实际槽位。实际并发链路中,availableRead 应由消费者侧观察,availableWrite 应由生产者侧观察,避免把两次独立原子读取误当成跨线程的一致快照。
满与空时不要阻塞音频回调
写满时最差的处理方式通常是在设备回调里等待消费者腾位置,因为这会把后台线程的抖动重新传回实时线程。实时采集常见做法是记录 overflow 并丢弃一部分数据,或者在业务明确允许时覆盖最旧数据;具体策略必须由“旧数据重要还是新数据重要”决定。
读空时也不要让播放回调等待生产者。播放链路通常输出静音、保持上一状态,或交给更上层的丢包隐藏策略处理,同时累计 underrun 指标。这样故障会表现为可观测的数据缺口,而不是不可控的线程阻塞。
容量越大,越能吸收短时抖动,但排队数据也可能越多。工程上应让容量覆盖可接受的最坏调度抖动并留少量安全余量,再通过 overflow、underrun 和实际占用水位验证,而不是把“大缓冲”当成稳定性的默认答案。