
音频开发 / 系统课时
用网络指标判断通话质量
用网络指标判断通话质量
通话出现卡顿、断续或延迟时,不能只盯着一个“丢包率”。更可靠的方法是把丢包、往返时延、到达抖动和缓冲水位放到同一时间轴上,再结合 RTCP 类统计判断网络是否正在恶化,并把网络问题与本地采集、编解码或播放故障区分开。
学习目标
- 能解释丢包率、RTT、到达抖动和缓冲水位分别反映什么风险
- 能用多个指标的联动变化判断通话质量是否由网络侧恶化导致
- 能理解 RTCP 类统计在网络诊断中的作用与边界
先把四个指标放到同一时间轴
单个指标只描述链路的一部分。丢包率说明有多少包没有按期到达;RTT 反映往返交互延迟;到达抖动描述相邻数据包到达间隔的不稳定程度;抖动缓冲水位则表示接收端还积压了多少可播放音频。
| 指标 | 主要回答的问题 | 危险变化 |
|---|---|---|
| 丢包率 | 数据是否持续缺失 | 连续升高或出现突发丢包 |
| RTT | 双向路径是否变慢 | 持续升高、周期性尖峰 |
| 到达抖动 | 包到达是否稳定 | 波动扩大、尖峰频繁 |
| 缓冲水位 | 接收端是否还有可播放余量 | 反复逼近下限并发生欠载 |
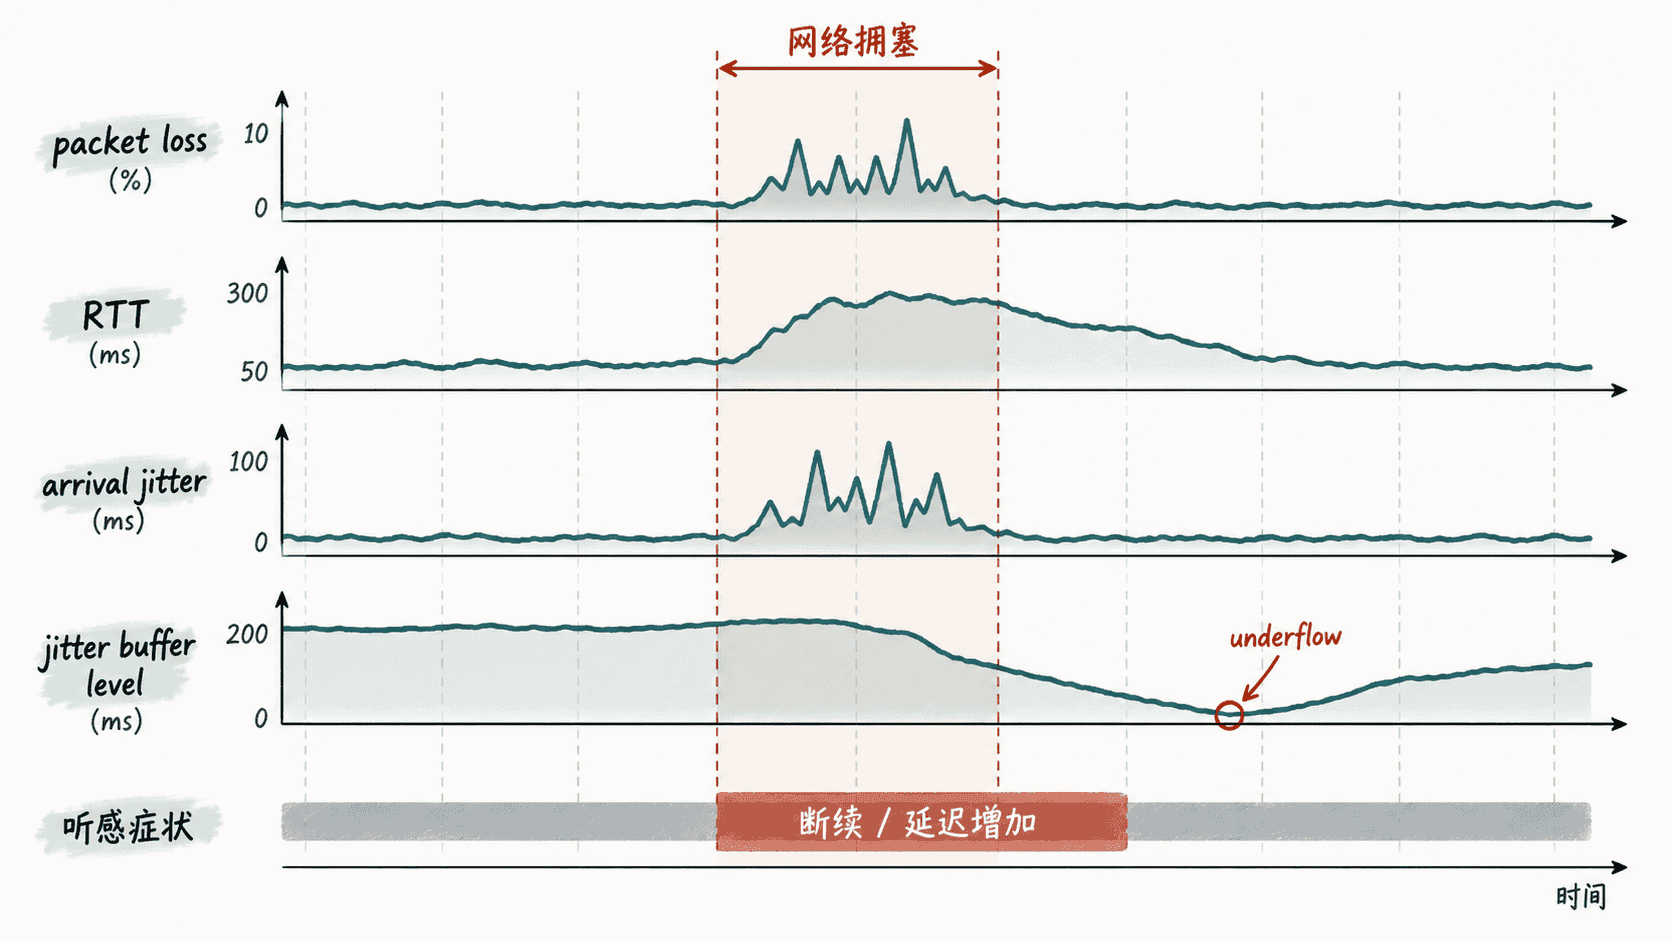
判断时最重要的是趋势和相关性。例如缓冲水位下降本身不一定说明网络差;如果它与抖动升高、丢包增加同时发生,网络侧证据就明显增强。
用组合信号判断网络侧风险
下面的脚本演示如何把已经归一化为百分比和毫秒的统计值做成一个简单告警。阈值只是教学示例,不是统一标准;真实产品应根据编解码器、缓冲策略、网络类型和业务体验目标标定。
from dataclasses import dataclass

@dataclass
class CallStats:
    loss_pct: float
    rtt_ms: float
    jitter_ms: float
    buffer_ms: float

def classify(stats: CallStats) -> str:
    risks = []
    if stats.loss_pct >= 5:
        risks.append("丢包高")
    if stats.rtt_ms >= 300:
        risks.append("往返时延高")
    if stats.jitter_ms >= 30:
        risks.append("到达抖动高")
    if stats.buffer_ms < 20:
        risks.append("缓冲偏低")

    if not risks:
        return "网络侧暂未见明显风险"
    return "网络侧风险:" + "、".join(risks)

sample = CallStats(
    loss_pct=7.0,
    rtt_ms=180.0,
    jitter_ms=42.0,
    buffer_ms=12.0,
)
print(classify(sample))
预期输出:
网络侧风险:丢包高、到达抖动高、缓冲偏低工程上不要让一次采样直接决定结论。更稳妥的做法是按 1~5 秒窗口聚合,并记录“连续几个窗口越界”,这样可以过滤短暂尖峰,又能保留持续恶化的证据。
读懂 RTCP 类统计
RTP 系统通常会通过 RTCP 或等价的接收统计反馈丢包、序列号、到达抖动以及时序信息。发送端结合报告中的时间字段,还可以估算 RTT。不同 SDK 暴露的字段名可能不同,但诊断思路相同:把反馈统计与本地发送、接收时间线对齐。
RTCP 类统计适合回答“网络传输阶段发生了什么”,但它不能单独证明最终听感。接收包正常并不代表解码一定成功,解码有数据也不代表播放设备真的输出了声音。
把网络问题和本地问题分开
可以用“网络证据是否异常”与“音频链路检查点是否有数据”做交叉判断。丢包、抖动和 RTT 同时恶化,且抖动缓冲频繁欠载,通常优先检查网络路径与缓冲策略;若网络统计稳定,但编码器没有输出包,则应回到采集或编码阶段。
若接收包连续、解码 PCM 电平正常,而用户仍听不到声音,网络侧通常不是第一嫌疑,应继续检查播放路由、设备状态和系统音量。这样做的核心不是给通话打一个孤立分数,而是用相互独立的证据确定问题首先出现在哪一层。