
音频开发 / 系统课时
按声道权重完成基础混音
按声道权重完成基础混音
混音不是简单把几路 PCM 相加:每一路需要独立权重,相加后的峰值还可能超过满量程。本节实现一个基础加权混音器,通过实际样本观察峰值增长,再用归一化和增益余量控制输出,并说明单声道与立体声之间怎样进行基础声道映射。
学习目标
- 按独立权重把多路 PCM 样本混合成一路输出
- 根据混音后的真实峰值判断削波风险并完成归一化
- 理解 headroom 与单声道、立体声基础映射之间的关系
混音的本质是逐帧加权求和
对于同一采样率、同一时间位置的多路信号,输出样本就是各输入样本乘权重后的和。例如两路输入可写成 mix = voice * 0.9 + music * 0.8。权重决定相对音量,也可以用于简单的声道分配。
需要注意,权重之和大于 1.0 并不代表每个样本一定削波,因为不同信号可能互相抵消;但它意味着最坏情况下峰值可以超过满量程。实际处理仍应检查混音后的峰值,并为不可预测的瞬时叠加留出余量。
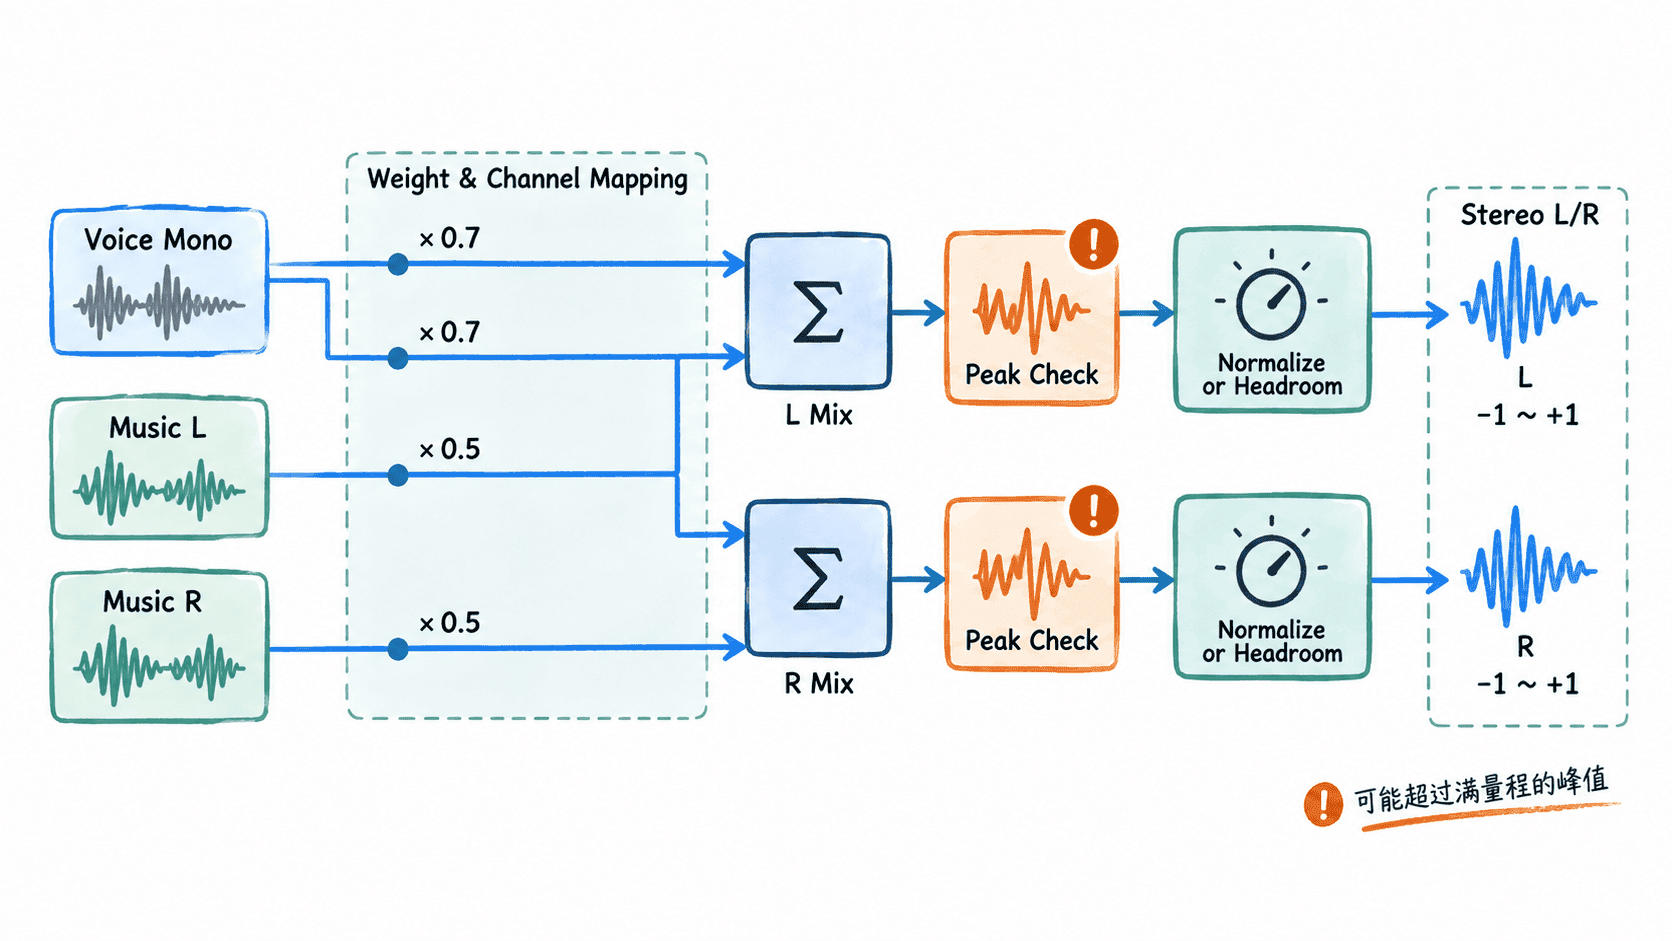
实现加权混音与峰值归一化
下面使用两路等长浮点 PCM。直接加权后峰值达到 1.29,已经超过归一化浮点 PCM 的常用满量程。示例随后把整段结果按同一个比例缩放,使最大绝对峰值降到 0.95,从而保留一点 headroom。
def weighted_mix(inputs, weights):
    if len(inputs) != len(weights):
        raise ValueError('inputs and weights must have the same length')
    if not inputs:
        return []

    frame_count = len(inputs[0])
    if any(len(track) != frame_count for track in inputs):
        raise ValueError('all tracks must have the same frame count')

    # 同一帧的各路样本分别乘权重后求和。
    return [
        sum(track[i] * weight for track, weight in zip(inputs, weights))
        for i in range(frame_count)
    ]


def normalize_peak(samples, ceiling=0.95):
    peak = max((abs(sample) for sample in samples), default=0.0)
    # 只有真实峰值越过目标上限时才衰减整段信号。
    scale = ceiling / peak if peak > ceiling else 1.0
    return [sample * scale for sample in samples], peak, scale


voice = [0.8, -0.7, 0.9, -0.9]
music = [0.7, 0.8, 0.6, -0.6]

mixed = weighted_mix([voice, music], [0.9, 0.8])
normalized, peak, scale = normalize_peak(mixed)

print('mixed=', [round(sample, 4) for sample in mixed])
print(f'peak={peak:.2f}')
print(f'scale={scale:.4f}')
print('normalized=', [round(sample, 4) for sample in normalized])
预期输出
mixed= [1.28, 0.01, 1.29, -1.29]
peak=1.29
scale=0.7364
normalized= [0.9426, 0.0074, 0.95, -0.95]
这里没有直接把 1.28 和 1.29 截成 1.0。归一化会对所有样本应用相同倍率,因此能保持这段信号内部的相对振幅关系;代价是整段音量都会随最高峰一起降低。
为实时混音预留增益余量
离线处理可以先扫描整段音频,再按照真实峰值归一化。实时流不同:未来峰值尚未到达,无法在不缓存的情况下提前知道整段最大值,因此通常要在设计权重时主动留下 headroom,并在输出端增加 limiter 处理偶发峰值。
如果已知每路归一化输入的绝对值都不会超过 1.0,那么两路权重为 0.9 和 0.8 时,理论最坏峰值可以达到 1.7。把两路都推到很高电平虽然听起来更响,却几乎不给同时出现的瞬时峰值留下空间。
处理不同声道数量
声道映射可以看成“每个输出声道分别做一次加权混音”。单声道人声加入立体声背景时,可以把同一人声样本同时送到左、右声道,再分别与背景的 L、R 相加。这样人声默认位于声像中央,而背景仍保留立体声差异。
立体声转单声道时,常见起点是 mono = 0.5 * left + 0.5 * right,而不是直接使用 left + right。后者在左右声道同相且接近满量程时可能把峰值放大到两倍。实际内容还可能因为左右声道存在相位差而产生抵消,因此转换后仍需检查峰值和听感。
更复杂的环绕声或多总线系统本质上也是同一模型:每个输入声道通过自己的权重路由到一个或多个输出声道。只要先明确映射关系,再在求和后检查峰值,就能把基础的两路混音自然扩展到更多声道,而不把声道数量与电平安全混为一谈。