
MySQL / 系统课时
建立事务锁治理手册
建立事务锁治理手册
锁竞争事故最怕临场凭经验处置:证据没留全、误杀连接、问题暂时恢复却反复出现。本节把发现、采证、判断、止损、改造和复盘固化为一套可重复执行的团队手册。
学习目标
- 建立事务锁事故从告警到恢复的统一处置链路
- 使用 MySQL 8.0 的锁等待视图采集关键证据并识别阻塞者
- 为止损动作、根因改造和复盘指标定义明确的执行边界
固化统一的处置链路
治理手册首先要规定“先做什么、什么条件下才能进入下一步”。建议把一次锁事故固定为六段:发现异常、保存证据、确认阻塞关系、执行止损、完成根因改造、复盘指标。这样值班人员更换后,处置质量不会依赖个人记忆。
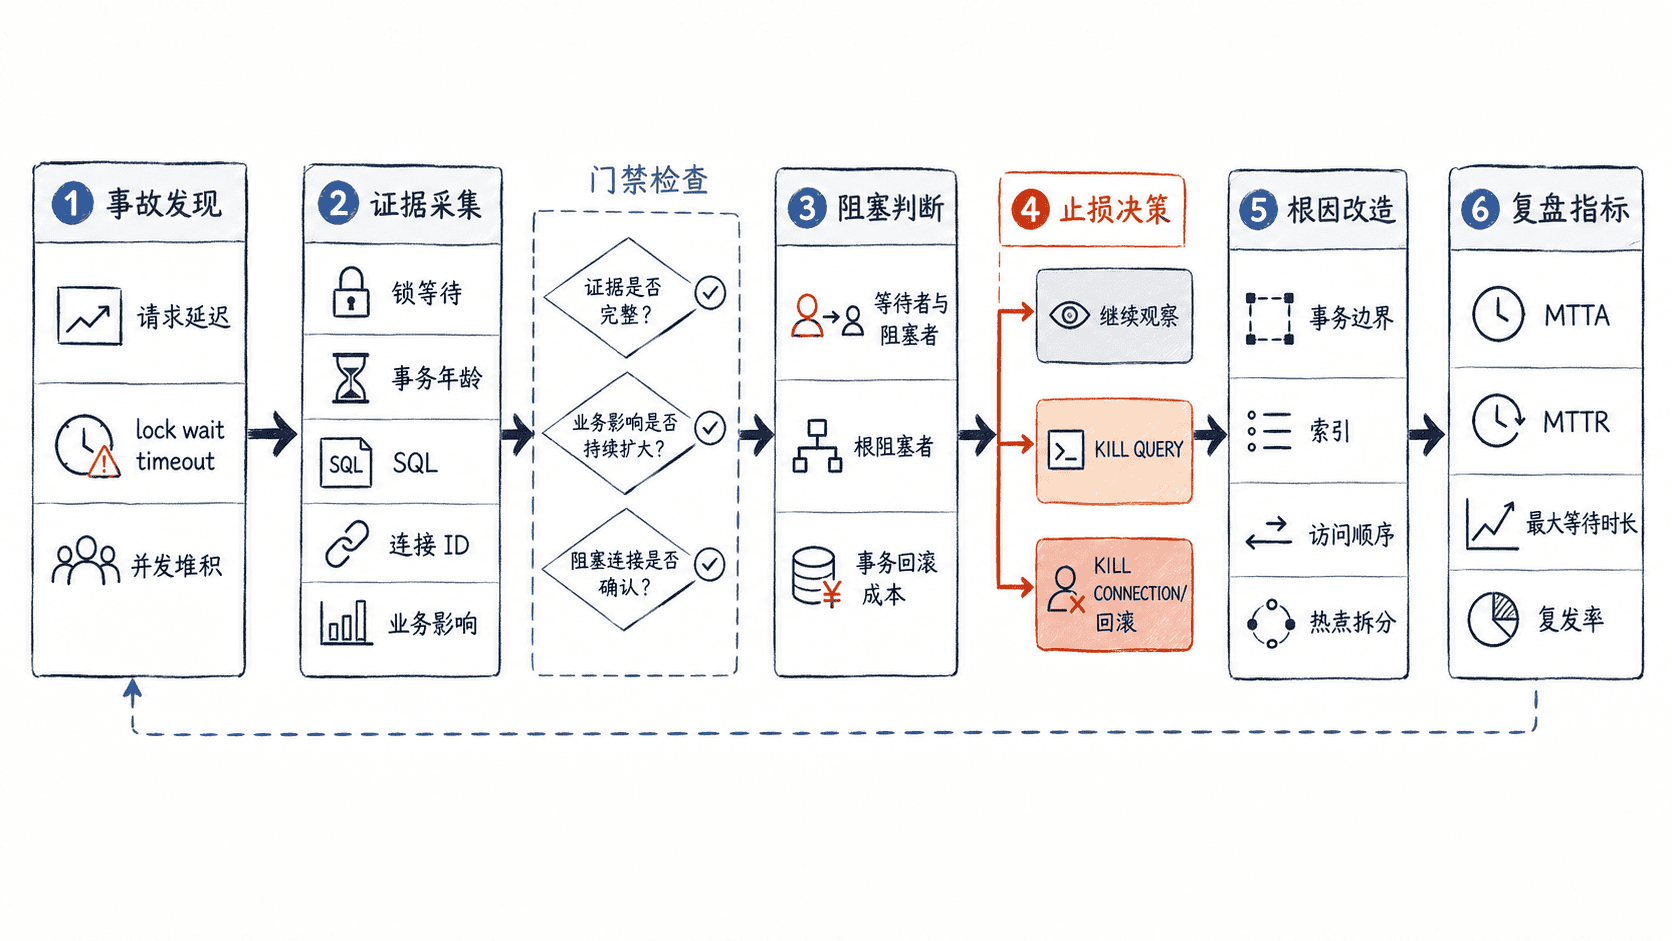
手册中还要写清角色:当班人员负责采证和初步判断,业务负责人确认受影响链路,数据库负责人批准高风险连接终止。若事故已造成核心请求持续堆积,可以缩短审批链,但仍应先保存最小证据集,避免恢复后无法解释根因。
建立最小证据集
对 InnoDB 行锁等待,MySQL 8.0 的 sys.innodb_lock_waits 已整理等待者、阻塞者、锁对象和可执行的终止语句,适合作为事故入口。发现阻塞后立即保存查询结果,并同时记录告警时间、受影响接口、错误码或超时比例。
SELECT
    NOW() AS captured_at,
    wait_age_secs,
    locked_table,
    locked_index,
    waiting_pid,
    LEFT(waiting_query, 160) AS waiting_query,
    blocking_pid,
    LEFT(blocking_query, 160) AS blocking_query,
    sql_kill_blocking_query,
    sql_kill_blocking_connection
FROM sys.innodb_lock_waits
ORDER BY wait_age_secs DESC;
预期结果:存在 InnoDB 锁等待时,每一行代表一组等待与阻塞关系;实际时间、连接 ID、表名和 SQL 会不同。
captured_at | wait_age_secs | locked_table | locked_index | waiting_pid | waiting_query | blocking_pid | blocking_query | sql_kill_blocking_query | sql_kill_blocking_connection
<TIME>      | <VALUE>       | <VALUE>      | <VALUE>      | <ID>        | <VALUE>       | <ID>         | <VALUE>        | KILL QUERY <ID>         | KILL <ID>
若该视图为空但 DDL 仍在等待,不要直接认定“没有锁”;这时应转向元数据锁、长事务或外部资源等待继续排查。手册应明确不同等待类型的入口,避免把所有阻塞都按 InnoDB 行锁处理。
判断谁才是应该处置的阻塞者
不要把“等待时间最长的会话”直接当成该杀的连接。真正需要找的是等待链上造成扩散的根阻塞者,并确认它当前事务是否仍有业务价值、已经修改多少数据、回滚预计会持续多久。
判断时至少核对三件事:阻塞连接是否属于关键批处理或在线交易;事务是否因为忘记提交、连接池复用或超长业务逻辑而异常存活;终止它是否会触发大事务回滚并进一步占用 I/O。对于访问同一批记录但加锁顺序不一致的场景,还要区分一次性阻塞与可重复死锁模式。
把止损动作写成有边界的操作
止损的目标是恢复服务,而不是“看到阻塞就杀连接”。KILL QUERY 只终止当前语句,连接和事务可能继续存在;如果锁来自事务中更早执行的语句,锁也可能继续保留。KILL CONNECTION 会终止会话,并使活动事务进入回滚,锁通常要等回滚推进后才逐步释放。
下面命令是择一执行的处置模板,先把 <ID> 替换为已确认的阻塞连接 ID;终止其他账号的会话需要相应管理权限,例如 CONNECTION_ADMIN 或等价管理员权限。
KILL QUERY <ID>;
KILL CONNECTION <ID>;
预期结果:被授权且目标连接存在时,MySQL 客户端会确认命令已接受;实际耗时可能不同。
Query OK, 0 rows affected (<TIME> sec)执行后必须重新查询锁等待,并同时观察业务延迟和错误率。若使用 KILL CONNECTION,还要确认回滚是否仍在进行;“连接消失”不等于“资源已经恢复”。当大事务回滚成本高于继续等待的成本时,手册应允许选择限流、摘流量或等待事务自然完成。
把根因改造成工程动作
恢复只是事故处置的一半。复盘时必须把根因转换为可验证的改造项,而不是停留在“事务太长”或“并发太高”。常见映射可以直接写进治理手册:
- 事务边界过大:缩短事务,只把必须原子提交的操作留在同一事务内,禁止在事务中调用慢外部服务
- 索引不合适:用执行计划确认扫描范围,补齐能缩小锁定记录范围的索引,并重新验证写入路径
- 加锁顺序不一致:统一多表、多行更新的访问顺序,减少循环等待
- 热点记录竞争:拆分热点计数、分片更新或改为异步聚合,避免大量事务争用同一行
- 连接空闲但事务未结束:检查自动提交、异常分支和连接池归还逻辑,确保提交或回滚后再归还连接
每个改造项都应带一个回归条件,例如“相同并发压测下最大锁等待低于团队阈值”或“故障注入后不再形成等待链”。没有验证条件的改造,很难判断是否真正消除了复发路径。
用复盘指标让手册持续变好
每次事故至少记录发现时间、首次拿到有效证据的时间、完成止损的时间、最大等待时长、受阻连接峰值、是否终止连接、回滚持续时间和根因分类。团队可以据此计算 MTTA、MTTR,并观察同类锁事故在 7 天或 30 天窗口内是否复发。
手册本身也要被评估:若多次事故都卡在“找不到连接归属”,就补充连接标识与业务标签;若止损经常因为大事务回滚放大故障,就把事务规模和回滚成本纳入门禁。最终目标不是让值班人员更快执行 KILL,而是让每次事故都有证据、有边界、有改造、有复验。