
MySQL / 系统课时
用索引缩小锁定范围
用索引缩小锁定范围
高并发更新变慢时,问题常不在单条 SQL 本身,而在它为了找到目标行扫描了多少记录、顺带锁住了多大范围。本节用 InnoDB 实验对比无索引与复合索引两种路径,直接观察扫描方式和记录锁数量的变化。
学习目标
- 解释“扫描范围扩大”为什么会演变成“锁竞争扩大”
- 为更新条件设计能缩小锁定范围的复合索引
- 用
EXPLAIN与performance_schema.data_locks验证优化是否生效
扫描范围为什么会影响锁范围
InnoDB 执行 UPDATE 时不仅要修改最终命中的行,还要先按访问路径查找候选记录。在 REPEATABLE READ 下,如果没有可用索引而退化为大范围扫描,扫描过程中可能持有大量记录锁或 next-key 锁,其他事务即使修改不同业务行,也更容易被阻塞。
有合适索引时,存储引擎能从索引键直接进入很小的候选集合。尤其是唯一索引等值查找,锁通常可以收敛到目标索引记录及对应聚簇记录。索引因此不仅减少读取,也缩短“事务会碰到哪些锁”的边界。
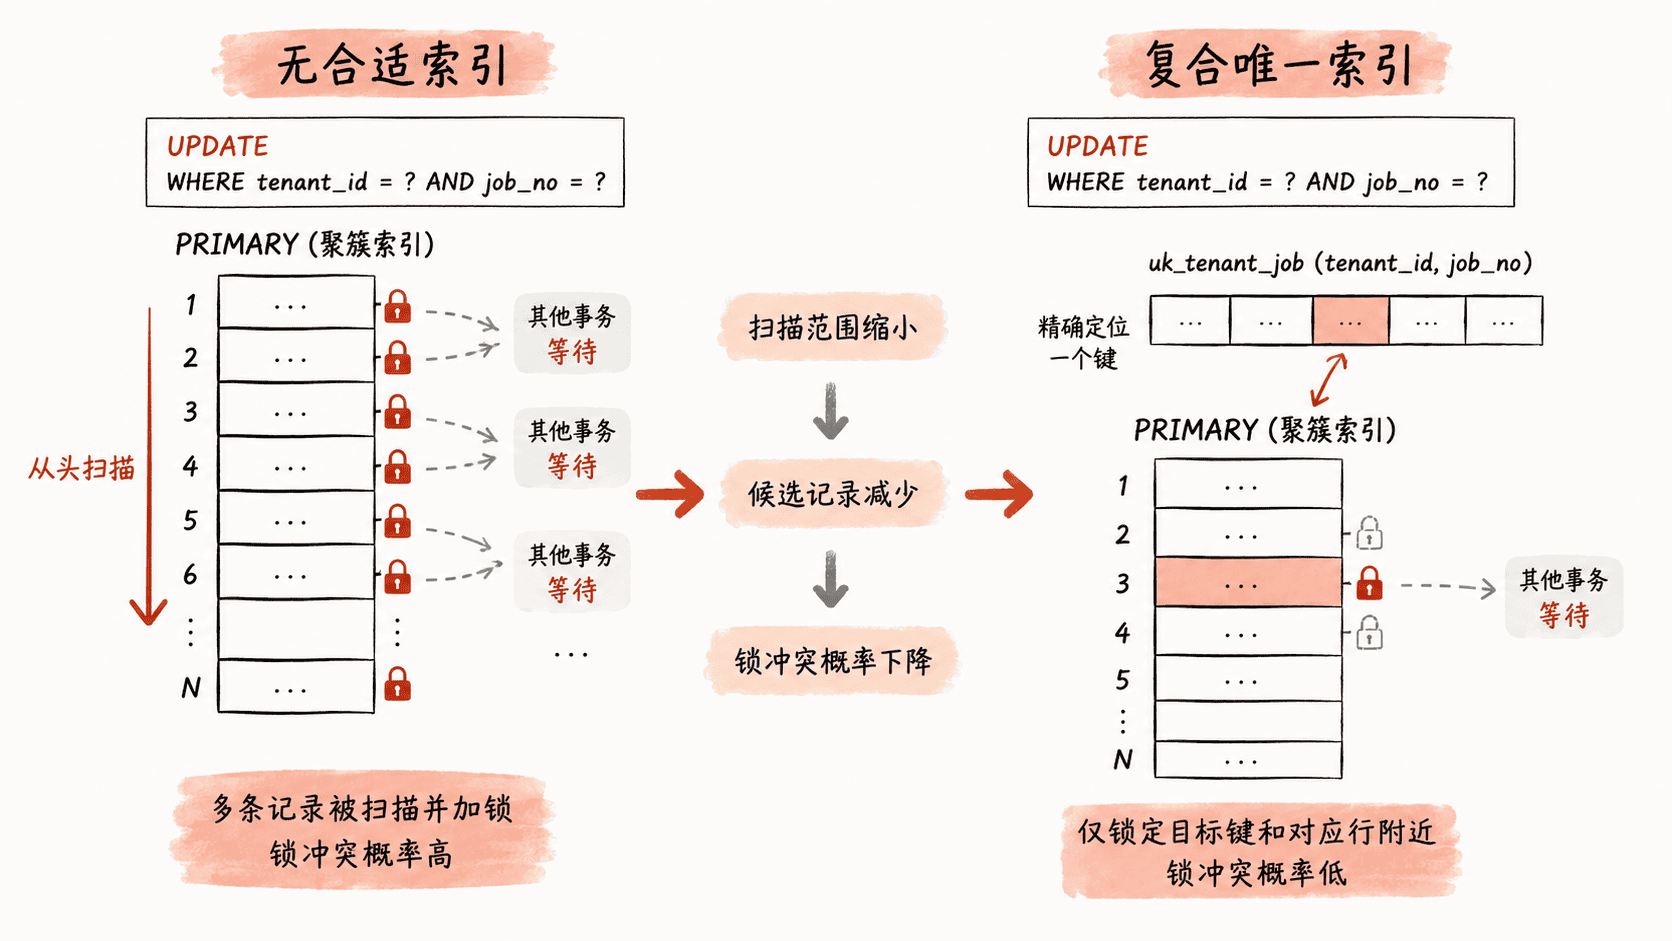
用同一条更新语句做对比
下面实验基于 MySQL 8.0。第一次更新时表上只有主键,第二次增加 (tenant_id, job_no) 唯一索引。事务保持未提交时,从 performance_schema.data_locks 统计当前会话可见的记录锁。
CREATE DATABASE IF NOT EXISTS anystack_lock_lab;
USE anystack_lock_lab;

-- 先建立只有主键的表,故意不创建业务定位索引。
DROP TABLE IF EXISTS order_jobs;
CREATE TABLE order_jobs (
    id BIGINT PRIMARY KEY,
    tenant_id BIGINT NOT NULL,
    job_no VARCHAR(20) NOT NULL,
    status VARCHAR(20) NOT NULL,
    payload VARCHAR(100) NOT NULL
) ENGINE=InnoDB;

INSERT INTO order_jobs VALUES
(1, 42, 'J-001', 'pending', 'a'),
(2, 7,  'J-002', 'pending', 'b'),
(3, 7,  'J-003', 'pending', 'c'),
(4, 42, 'J-004', 'pending', 'd'),
(5, 9,  'J-005', 'pending', 'e'),
(6, 9,  'J-006', 'pending', 'f');

-- 基线:观察没有复合索引时的 UPDATE 访问路径。
EXPLAIN UPDATE order_jobs
SET payload = 'processing'
WHERE tenant_id = 42 AND job_no = 'J-004';

SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
START TRANSACTION;
UPDATE order_jobs
SET payload = 'processing'
WHERE tenant_id = 42 AND job_no = 'J-004';

SELECT INDEX_NAME, LOCK_MODE, COUNT(*) AS lock_count
FROM performance_schema.data_locks
WHERE OBJECT_SCHEMA = DATABASE()
  AND OBJECT_NAME = 'order_jobs'
  AND LOCK_TYPE = 'RECORD'
GROUP BY INDEX_NAME, LOCK_MODE;
ROLLBACK;

-- 增加能完整覆盖定位条件的唯一索引,再执行同一组检查。
ALTER TABLE order_jobs
ADD UNIQUE KEY uk_tenant_job (tenant_id, job_no);

EXPLAIN UPDATE order_jobs
SET payload = 'processing'
WHERE tenant_id = 42 AND job_no = 'J-004';

START TRANSACTION;
UPDATE order_jobs
SET payload = 'processing'
WHERE tenant_id = 42 AND job_no = 'J-004';

-- 用完全相同的统计口径比较加索引后的锁范围。
SELECT INDEX_NAME, LOCK_MODE, COUNT(*) AS lock_count
FROM performance_schema.data_locks
WHERE OBJECT_SCHEMA = DATABASE()
  AND OBJECT_NAME = 'order_jobs'
  AND LOCK_TYPE = 'RECORD'
GROUP BY INDEX_NAME, LOCK_MODE;
ROLLBACK;
预期结果
第一次 EXPLAIN:没有 uk_tenant_job 可用,需要扩大到聚簇索引扫描。
第一次锁统计:PRIMARY 上可见多条 RECORD 锁,数量明显大于最终命中的 1 行。

第二次 EXPLAIN:访问路径使用 uk_tenant_job,估算扫描行数接近 1。
第二次锁统计:锁主要集中在 uk_tenant_job 的目标键及对应 PRIMARY 记录,RECORD 锁数量显著下降。

具体 rows 估算、LOCK_MODE 文本和锁条数可能随 MySQL 8.0 小版本而不同。
设计索引时看更新条件而不只看查询条件
索引列应覆盖用于定位待更新行的稳定条件。例如多租户业务常先按 tenant_id 隔离,再按业务键 job_no 找唯一对象,因此 (tenant_id, job_no) 比只给 status 建索引更能收敛单行更新的访问范围。
列顺序仍要服从最左前缀。若更新条件经常只有 job_no,而索引是 (tenant_id, job_no),它无法直接支持缺少 tenant_id 的等值定位。反过来,为每一种 SQL 都堆索引会增加写放大和维护成本,应围绕真实高并发写路径设计。
什么时候索引仍然救不了竞争
如果大量事务本来就在修改同一个热点键,再精确的索引也只能让它们更快到达同一把锁,不能消除串行等待。范围更新如 WHERE created_at < ... 也可能天然覆盖大量记录,此时需要进一步拆批、缩短事务、降低单批持锁时间,或者重新设计热点数据的更新方式。
判断索引优化是否成功,应同时看三件事:访问路径是否从大范围扫描变成精确定位、记录锁数量是否下降、并发事务的等待时间是否减少。只有三者一致,才说明索引真正缩小了锁竞争面。