
MySQL / 系统课时
理解记录锁与间隙锁
理解记录锁与间隙锁
本篇解释 InnoDB 为什么不仅锁“已经存在的行”,还会锁“还不存在的索引区间”。你将用一个可复现的并发实验区分 Record Lock 与 Gap Lock,并理解范围查询在 REPEATABLE READ 下如何阻止其他事务向受保护区间插入新记录。
学习目标
- 说清 Record Lock 与 Gap Lock 分别锁定什么对象
- 理解间隙锁为什么主要用于抑制插入,而不是保护某条现有记录
- 通过两个会话复现范围锁导致的插入等待
锁住记录和锁住间隙是两件事
Record Lock 锁定的是索引记录。即使表没有显式二级索引,InnoDB 的行锁也仍然依附于某个索引结构,而不是直接锁“物理行”。
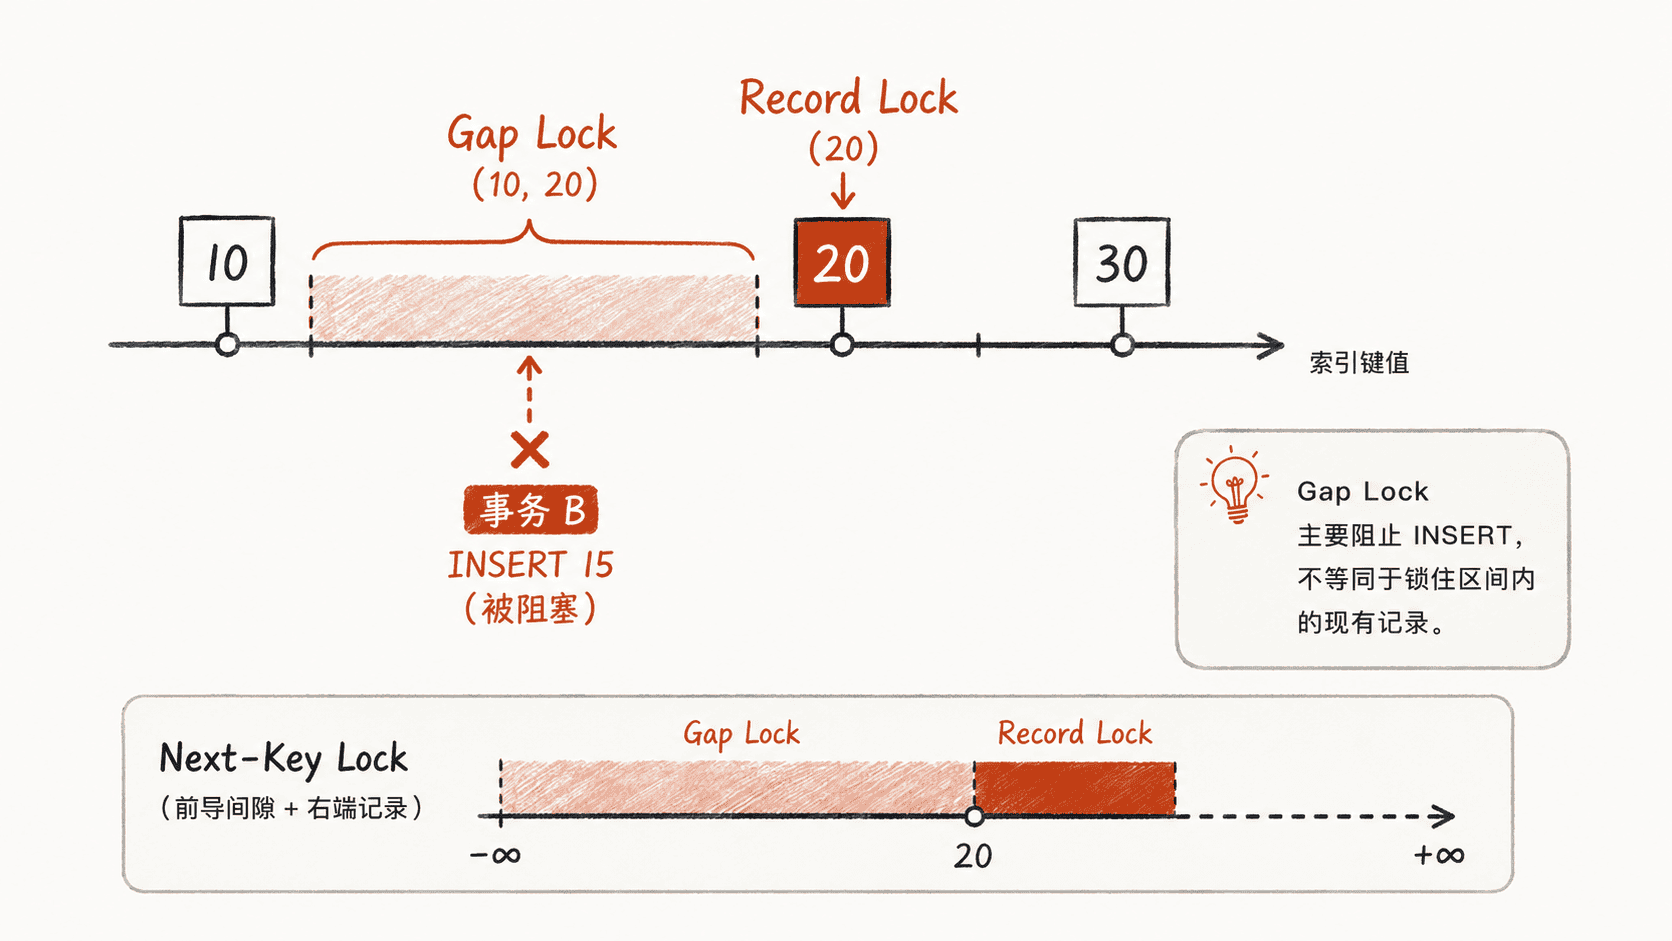
Gap Lock 锁定的是两个索引记录之间、首记录之前或末记录之后的索引间隙。它不锁定区间端点上的现有记录,主要作用是阻止其他事务在这个间隙中新插入索引值。
例如索引中已有键值 10 和 20,那么 (10, 20) 就是一个间隙。对这个间隙加锁后,事务仍然可能读取既有记录,但另一个事务插入 15 会被阻塞,因为新记录必须落入被锁住的间隙。
为什么范围查询需要间隙锁
在 REPEATABLE READ 下,锁定读需要保护的不只是当前命中的记录,还要避免其他事务在查询范围内插入新记录,从而改变后续锁定读看到的范围集合。InnoDB 常用 next-key lock 完成这件事,它可以理解为“某条索引记录上的 Record Lock + 该记录之前的 Gap Lock”。
因此,WHERE id = 20 这类通过唯一索引精确命中的锁定读,通常只需要记录锁;而 WHERE id BETWEEN 10 AND 20、非唯一索引范围条件或未命中唯一键的搜索,更可能涉及间隙或 next-key 锁。
用两个会话复现插入被阻塞
先在会话 A 建表并执行范围锁定读。事务保持不提交,让范围锁持续存在。
DROP DATABASE IF EXISTS gap_lab;
CREATE DATABASE gap_lab;
USE gap_lab;

CREATE TABLE numbers (
    id INT PRIMARY KEY,
    note VARCHAR(20) NOT NULL
) ENGINE=InnoDB;

INSERT INTO numbers VALUES (10, 'ten'), (20, 'twenty');

SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
START TRANSACTION;

SELECT *
FROM numbers
WHERE id BETWEEN 10 AND 20
FOR UPDATE;
预期结果
id  note
10  ten
20  twenty
会话 A 此时不要提交。然后打开会话 B,设置较短的锁等待超时,并尝试把 15 插入 (10, 20) 间隙。
USE gap_lab;
SET SESSION innodb_lock_wait_timeout = 2;

INSERT INTO numbers(id, note)
VALUES (15, 'fifteen');
预期结果
ERROR 1205 (HY000): Lock wait timeout exceeded; try restarting transaction实际等待秒数可能略有差异。回到会话 A 执行 ROLLBACK 或 COMMIT 释放锁后,再次执行插入即可成功;这说明阻塞目标不是键值 10 或 20 本身,而是新记录 15 需要进入的索引间隙。
读懂边界而不是死记范围
排查锁竞争时,先确认 SQL 实际走哪个索引,再判断搜索条件是唯一点查还是范围扫描。相同的业务条件如果使用不同索引,锁定的索引记录和间隙也可能不同,因此“where 条件看起来一样”并不能保证加锁范围一样。
READ COMMITTED 会显著减少普通搜索和索引扫描使用的 gap locking,但外键检查、重复键检查等场景仍可能使用间隙相关锁。切换隔离级别可以改变锁行为,却不应替代索引设计和事务边界治理。
当你能把锁等待映射回“哪条索引记录被锁、哪个索引间隙禁止插入”,就能把看似抽象的 Record Lock 与 Gap Lock 转化为可验证的索引范围问题。