
MySQL / 系统课时
治理热点行更新竞争
治理热点行更新竞争
热点行把大量并发请求压到同一条记录锁上,事务即使很短,也会被迫排队。本课从单行串行化的吞吐上限出发,先用条件更新缩短临界区,再判断何时应拆分热点或改成异步聚合。
学习目标
- 判断热点行锁竞争为何会形成串行瓶颈
- 使用条件更新减少“先查再改”的锁持有时间
- 根据一致性要求选择拆分热点或异步聚合
先识别真正的串行瓶颈
假设库存、余额、计数器都集中在同一行。InnoDB 对这行执行 UPDATE 时必须取得排他锁;前一个事务提交前,后续事务只能等待。此时增加应用线程不会让这条记录并行更新,只会增加排队、超时和死锁概率。
如果一次持锁平均耗时为 秒,那么单个热点行的理论处理能力大致受 限制。实际吞吐通常更低,因为还要叠加日志刷盘、网络、上下文切换和回滚成本。
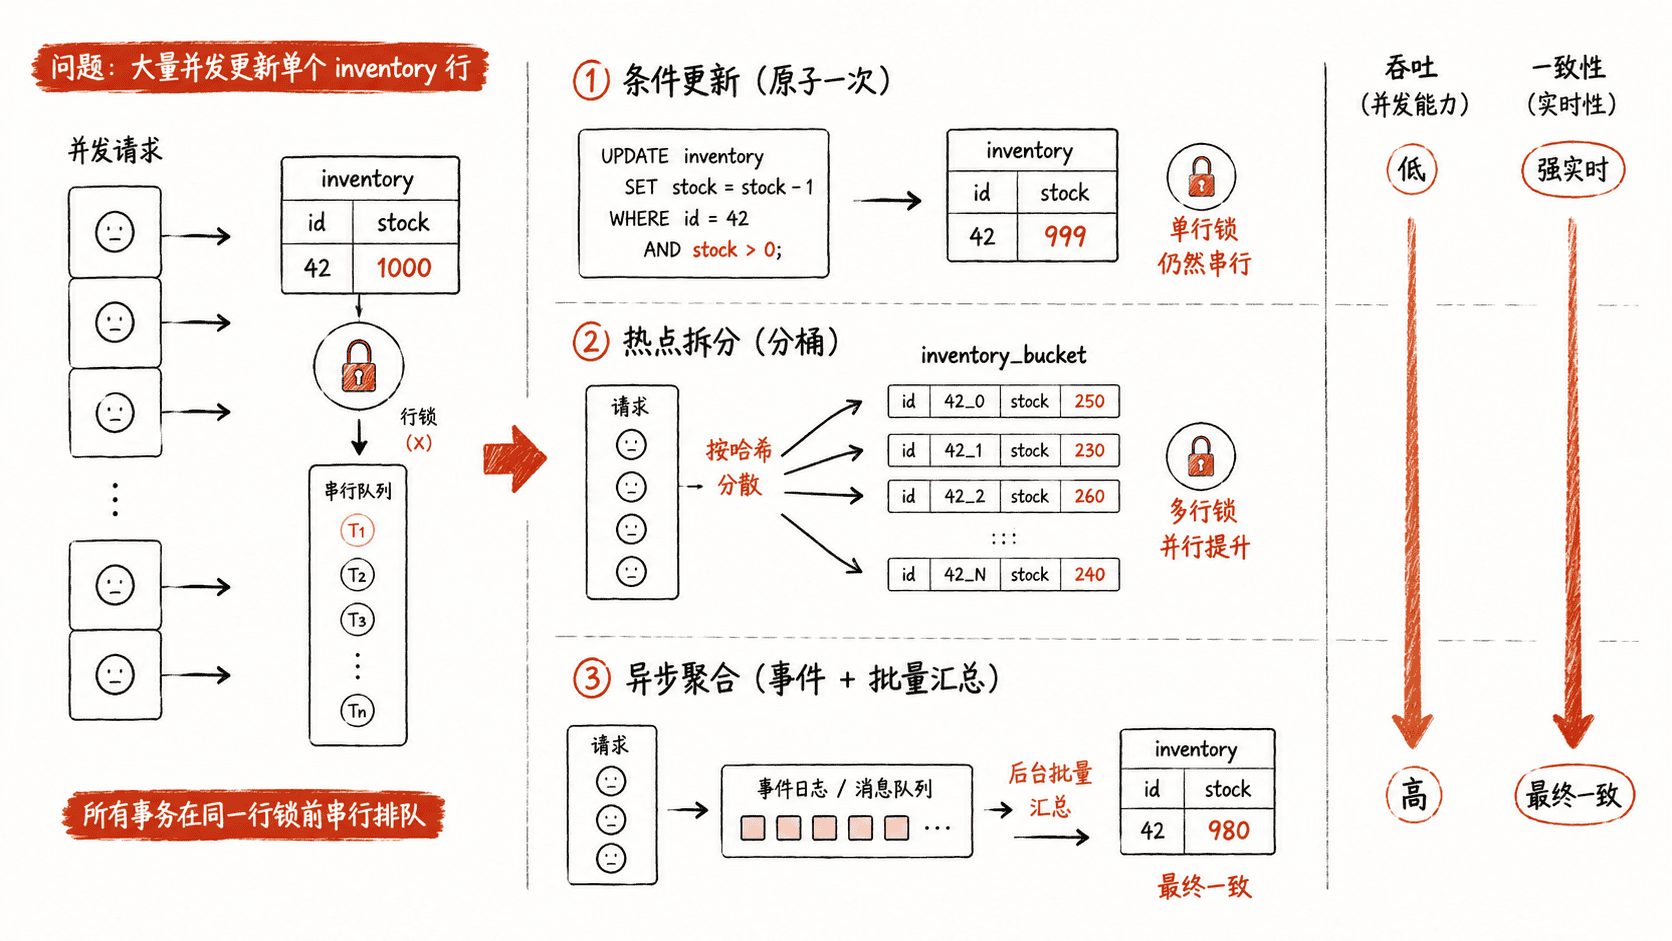
判断是否属于热点行,不要只看 QPS。更有价值的信号是同一主键被频繁更新、事务在 UPDATE 处等待、锁等待时间上升,而 CPU 和磁盘仍有余量。若瓶颈确实集中到少量记录,再选择治理手段。
先把读改写成条件更新
最常见的低成本优化,是把“先 SELECT 判断,再 UPDATE”改成带条件的单条更新。判断条件在取得记录锁后完成,避免应用在两个语句之间持有更长事务,也消除检查与修改之间的竞态窗口。
下面用库存扣减演示。示例可直接在测试库执行。
DROP TABLE IF EXISTS hot_inventory_demo;
CREATE TABLE hot_inventory_demo (
    sku_id BIGINT PRIMARY KEY,
    stock INT NOT NULL
) ENGINE=InnoDB;

INSERT INTO hot_inventory_demo (sku_id, stock)
VALUES (1001, 2);

START TRANSACTION;

UPDATE hot_inventory_demo
SET stock = stock - 1
WHERE sku_id = 1001
  AND stock > 0;

SELECT ROW_COUNT() AS affected_rows;

COMMIT;

SELECT sku_id, stock
FROM hot_inventory_demo
WHERE sku_id = 1001;
预期结果
affected_rows
1

sku_id  stock
1001    1
affected_rows = 1 表示本次成功扣减;为 0 时说明库存已经不足。这个模式保证检查和修改原子完成,但它不会突破单个热点行的串行上限,因此适合“冲突可控但事务过长”的场景,不适合无限放大的抢购热点。
热点拆分换取并行度
当业务允许把一个逻辑值拆成多个物理分片时,可以把单行拆成多个 bucket。请求按用户、订单或随机策略落到不同 bucket,不同记录锁即可并行获取;读取总量时再汇总多个 bucket。
这种方法仍可保持数据库内的强一致更新,但代价是读取和校验更复杂。库存类数据还要保证各 bucket 不出现局部耗尽导致“总库存有余量但本次失败”的假阴性,通常需要重试其他 bucket 或设计补偿流程。
异步聚合把写路径移出热点
如果业务只要求最终一致,例如点赞数、浏览量、非关键统计,可以把每次更新先写入事件表、日志或消息队列,再由后台任务批量合并到汇总行。前台请求不再竞争最终计数器,吞吐上限从“同一行锁”转向事件写入和消费者能力。
代价也很明确:读到的聚合值会短暂滞后,并且必须处理消息重复、消费失败和补偿。对于余额、限量库存这类必须在请求返回前确定结果的数据,不应仅靠异步聚合维持核心约束。
按正确性要求选择手段
| 手段 | 正确性特征 | 对热点吞吐的改善 | 适用场景 |
|---|---|---|---|
| 条件更新 | 单行强一致 | 主要缩短临界区 | 库存扣减、状态流转 |
| 热点拆分 | 可保持强一致,但读取更复杂 | 把锁竞争分散到多行 | 配额、计数器、可分片库存 |
| 异步聚合 | 通常最终一致 | 最大程度移出同步热点 | 点赞、浏览量、统计指标 |
治理顺序通常是先缩短事务并改成条件更新,再确认单行串行化是否仍是瓶颈;只有吞吐目标确实超过单行极限时,才值得引入 bucket 或异步链路。这样能把复杂度留给真正需要它的热点,而不是把所有更新都提前做成分布式问题。