
MySQL / 系统课时
发现并治理长事务
发现并治理长事务
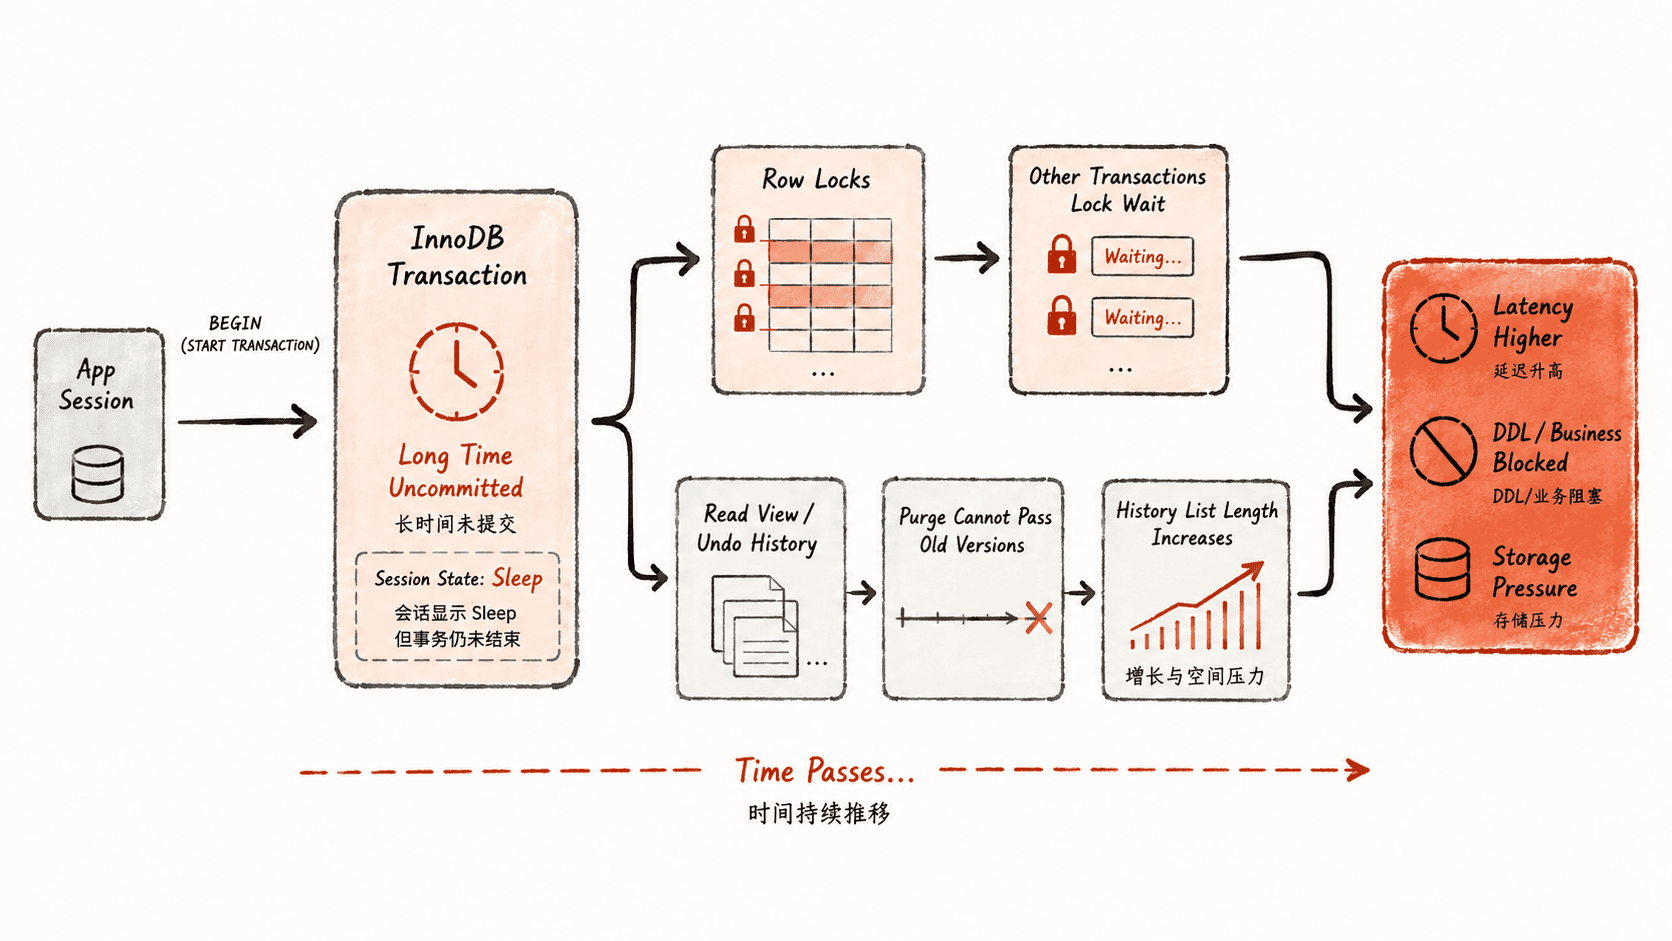
长事务不只是“执行很久的 SQL”:会话可能早已空闲,却仍保持未提交事务、行锁和旧版本可见性。本课用 MySQL 8.x 的事务与锁视图识别风险会话,并给出告警、终止和应用侧治理的可执行顺序。
学习目标
- 从事务持续时间、最后 SQL、锁等待和历史版本压力识别危险长事务
- 区分“慢 SQL”与“事务长期未提交”,避免只盯语句耗时
- 建立从告警、止血到应用改造的治理闭环
先找真正仍然存活的事务
InnoDB 事务的关键视图是 information_schema.innodb_trx。trx_started 表示事务开始时间,即使连接当前处于 Sleep,只要没有提交或回滚,该事务仍可能继续持有锁并阻止 Purge 清理旧版本。
先按事务年龄排序,并把会话当前状态一起拉出来:
SELECT
    t.trx_mysql_thread_id AS processlist_id,
    TIMESTAMPDIFF(SECOND, t.trx_started, NOW()) AS trx_age_seconds,
    t.trx_state,
    t.trx_rows_locked,
    t.trx_rows_modified,
    p.COMMAND,
    p.TIME AS session_state_seconds,
    p.STATE,
    p.INFO AS current_sql
FROM information_schema.innodb_trx AS t
LEFT JOIN information_schema.processlist AS p
    ON p.ID = t.trx_mysql_thread_id
ORDER BY trx_age_seconds DESC;
预期结果
+----------------+-----------------+-----------+-----------------+-------------------+---------+-----------------------+-------+----------------------+
| processlist_id | trx_age_seconds | trx_state | trx_rows_locked | trx_rows_modified | COMMAND | session_state_seconds | STATE | current_sql          |
+----------------+-----------------+-----------+-----------------+-------------------+---------+-----------------------+-------+----------------------+
| <ID>           | 420             | RUNNING   | 1               | 1                 | Sleep   | 415                   | NULL  | NULL                 |
+----------------+-----------------+-----------+-----------------+-------------------+---------+-----------------------+-------+----------------------+
其中 <ID> 等实际值会随实例和会话状态变化。这里最危险的信号不是 current_sql 为空,而是“事务已持续 420 秒且会话已经 Sleep 415 秒”。这通常说明应用开启事务后没有及时提交或回滚。
把“最后执行 SQL”补回来
PROCESSLIST.INFO 只显示当前正在执行的语句,空闲长事务常常看不到刚才执行过什么。若已启用 Performance Schema,可以从线程映射和 statement history 追溯近期 SQL。
SELECT
    t.PROCESSLIST_ID,
    es.EVENT_ID,
    es.SQL_TEXT,
    ROUND(es.TIMER_WAIT / 1000000000000, 6) AS elapsed_seconds
FROM performance_schema.threads AS t
JOIN performance_schema.events_statements_history AS es
    ON es.THREAD_ID = t.THREAD_ID
WHERE t.PROCESSLIST_ID = <ID>
  AND es.SQL_TEXT IS NOT NULL
ORDER BY es.EVENT_ID DESC
LIMIT 5;
预期结果
+----------------+----------+------------------------------------------+-----------------+
| PROCESSLIST_ID | EVENT_ID | SQL_TEXT                                 | elapsed_seconds |
+----------------+----------+------------------------------------------+-----------------+
| <ID>           | <ID>     | UPDATE orders SET status='PAID' ...     | <VALUE>         |
| <ID>           | <ID>     | BEGIN                                    | <VALUE>         |
+----------------+----------+------------------------------------------+-----------------+
实际能保留多少历史语句取决于 Performance Schema consumer 和 history 大小;如果结果为空,先确认 events_statements_history 是否启用,而不是据此判断“这个事务没有执行过 SQL”。
判断它是否已经伤害其他会话
长事务本身不一定需要立刻终止。优先级应由业务影响决定:是否阻塞别的事务、是否修改大量数据、是否长期保留旧版本。锁等待可以直接从 performance_schema.data_lock_waits 与线程信息关联。
SELECT
    rtrx.trx_mysql_thread_id AS waiting_processlist_id,
    btrx.trx_mysql_thread_id AS blocking_processlist_id,
    TIMESTAMPDIFF(SECOND, btrx.trx_started, NOW()) AS blocking_trx_age_seconds,
    r.OBJECT_SCHEMA,
    r.OBJECT_NAME,
    r.INDEX_NAME,
    r.LOCK_TYPE,
    r.LOCK_MODE
FROM performance_schema.data_lock_waits AS w
JOIN performance_schema.data_locks AS r
    ON r.ENGINE_LOCK_ID = w.REQUESTING_ENGINE_LOCK_ID
JOIN performance_schema.data_locks AS b
    ON b.ENGINE_LOCK_ID = w.BLOCKING_ENGINE_LOCK_ID
JOIN information_schema.innodb_trx AS rtrx
    ON rtrx.trx_id = r.ENGINE_TRANSACTION_ID
JOIN information_schema.innodb_trx AS btrx
    ON btrx.trx_id = b.ENGINE_TRANSACTION_ID;
预期结果
+------------------------+-------------------------+--------------------------+---------------+-------------+------------+-----------+-----------+
| waiting_processlist_id | blocking_processlist_id | blocking_trx_age_seconds | OBJECT_SCHEMA | OBJECT_NAME | INDEX_NAME | LOCK_TYPE | LOCK_MODE |
+------------------------+-------------------------+--------------------------+---------------+-------------+------------+-----------+-----------+
| <ID>                   | <ID>                    | 430                      | app           | orders      | PRIMARY    | RECORD    | X         |
+------------------------+-------------------------+--------------------------+---------------+-------------+------------+-----------+-----------+如果一个长事务已经成为阻塞者,应先确认其业务操作能否回滚,再决定止血。KILL QUERY 只终止当前语句;对空闲但事务仍打开的连接,通常需要 KILL CONNECTION <ID> 才能让服务器断开连接并回滚未提交事务。
KILL CONNECTION <ID>;预期结果
Query OK, 0 rows affected同时观察历史版本压力
长事务持有较旧 Read View 时,Purge 不能清理仍可能被该事务访问的旧版本。可以用 InnoDB 状态中的 History list length 观察趋势,但不要把某个绝对值直接当成统一故障阈值。
SHOW ENGINE INNODB STATUS;预期结果
------------
TRANSACTIONS
------------
Trx id counter <ID>
Purge done for trx's n:o <ID> undo n:o <ID> state: running
History list length <VALUE>
关键是看趋势:事务年龄持续增加,同时 History list length 长时间上升且不能回落,比某一瞬间的数值更值得告警。若系统还有批量更新、备份读取或只读分析任务,要把这些合法长事务单独分组,避免与异常事务混在一个阈值里。
建立可执行的治理规则
监控至少应同时记录事务年龄、会话状态、锁定行数、修改行数、阻塞数量和数据库账号。告警阈值应根据业务事务正常耗时分层,例如“超过应用 P99 若干倍先告警,成为阻塞者则升高优先级”,而不是全库只用一个固定秒数。
应用侧治理通常比数据库侧反复杀会话更重要。缩小事务边界,把网络调用、人工等待、消息发送和大批量计算移到事务外;为连接池设置合理的事务超时或借助框架超时控制;所有异常路径必须显式回滚,并禁止把开启事务的连接长时间放回池中。
上线后的验收标准也应可观测:异常长事务数量回落、锁等待链缩短、History list length 能在峰值后恢复,且业务没有因为过度终止连接而出现重复提交或部分失败。做到这些,长事务治理才从一次性止血变成稳定的运行机制。