
MySQL / 系统课时
建立事务锁监控指标
建立事务锁监控指标
本篇把事务锁风险转换成可持续监控的信号:既看当前有多少锁等待,也看等待多久、最老事务多老、死锁是否突然增多,以及连接资源是否接近耗尽。最终目标不是堆一组图表,而是用关联指标尽早识别“正在形成的锁风暴”。
学习目标
- 建立锁等待、事务年龄、死锁、等待时长和连接压力的核心指标集。
- 使用 MySQL 系统视图采集一份可直接接入监控系统的风险快照。
- 用持续时间、变化率和多指标组合设计分级告警,降低误报。
指标要覆盖原因、压力和结果
只监控“当前锁等待数”不够。一次短暂等待可能完全正常,而一个持续几十秒的老事务即使暂时只阻塞一条请求,也可能马上形成扇出。更可靠的指标集应分三层:原因层看长事务和死锁,压力层看锁等待数量与最长等待,结果层看连接利用率和正在运行的线程数。
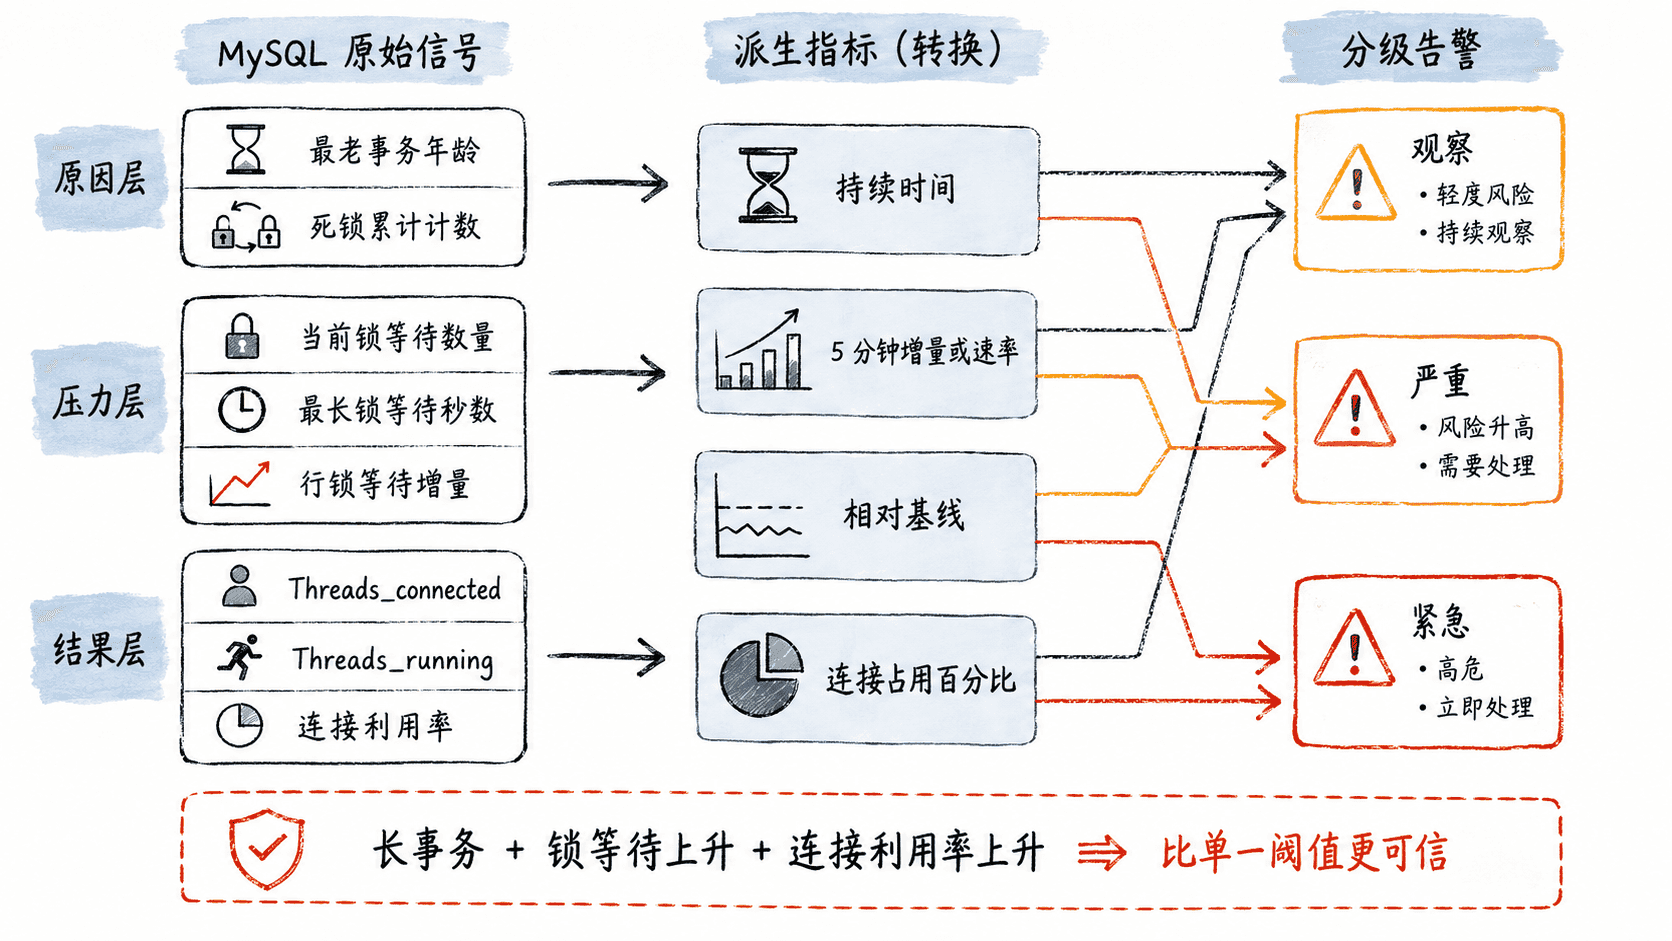
建议至少采集这些信号:当前锁等待数、最长锁等待秒数、最老 InnoDB 事务年龄、Innodb_deadlocks 累计值、Innodb_row_lock_waits 累计值、Threads_connected、Threads_running,以及 Threads_connected / max_connections 得到的连接利用率。累计计数必须在监控端计算时间窗口增量,不能直接对总值设阈值。
采集一份关联快照
下面的 SQL 把常用信号合并为一行,适合被采集器定时执行。查询本身只读取 MySQL 元数据,不会修改业务数据。
SELECT
    (SELECT COUNT(*)
       FROM performance_schema.data_lock_waits) AS current_lock_waits,
    (SELECT COALESCE(MAX(wait_age_secs), 0)
       FROM sys.innodb_lock_waits) AS max_lock_wait_s,
    (SELECT COALESCE(MAX(TIMESTAMPDIFF(SECOND, trx_started, NOW())), 0)
       FROM information_schema.innodb_trx) AS oldest_trx_s,
    CAST((SELECT VARIABLE_VALUE
            FROM performance_schema.global_status
           WHERE VARIABLE_NAME = 'Innodb_deadlocks') AS UNSIGNED) AS deadlocks_total,
    CAST((SELECT VARIABLE_VALUE
            FROM performance_schema.global_status
           WHERE VARIABLE_NAME = 'Innodb_row_lock_waits') AS UNSIGNED) AS row_lock_waits_total,
    CAST((SELECT VARIABLE_VALUE
            FROM performance_schema.global_status
           WHERE VARIABLE_NAME = 'Threads_connected') AS UNSIGNED) AS threads_connected,
    CAST((SELECT VARIABLE_VALUE
            FROM performance_schema.global_status
           WHERE VARIABLE_NAME = 'Threads_running') AS UNSIGNED) AS threads_running,
    ROUND(
        100 * CAST((SELECT VARIABLE_VALUE
                      FROM performance_schema.global_status
                     WHERE VARIABLE_NAME = 'Threads_connected') AS DECIMAL(20,2))
        / @@max_connections,
        1
    ) AS connection_util_pct;
预期结果
+--------------------+-----------------+--------------+-----------------+----------------------+-------------------+-----------------+---------------------+
| current_lock_waits | max_lock_wait_s | oldest_trx_s | deadlocks_total | row_lock_waits_total | threads_connected | threads_running | connection_util_pct |
+--------------------+-----------------+--------------+-----------------+----------------------+-------------------+-----------------+---------------------+
| <VALUE>            | <VALUE>         | <VALUE>      | <VALUE>         | <VALUE>              | <VALUE>           | <VALUE>         | <VALUE>             |
+--------------------+-----------------+--------------+-----------------+----------------------+-------------------+-----------------+---------------------+
<VALUE> 表示采集时刻的动态值,实际结果会不同。data_lock_waits 反映当前阻塞关系,innodb_trx 反映当前事务年龄,而状态变量中的死锁和行锁等待属于累计计数,三者时间语义不同,监控系统必须分别处理。
把累计量转换成变化率
Innodb_deadlocks=100 本身不能说明现在有故障:它可能是实例运行数月积累的结果。应记录相邻采样点的差值,例如计算“最近 5 分钟新增死锁数”和“最近 5 分钟新增行锁等待数”。实例重启或计数器重置时,差值可能变成负数,此时应丢弃该窗口而不是产生异常告警。
同样,Threads_connected 代表已建立连接,Threads_running 更接近正在执行而非睡眠的线程压力。连接数高但运行线程低,可能只是连接池规模较大;锁等待上升、运行线程升高且连接利用率继续逼近上限,才更像正在形成的资源挤兑。
设计分级告警而不是单阈值
阈值必须结合应用超时、正常事务时长和业务峰值校准。可以先用下表作为初始模板,再依据一到两周基线调整。
| 风险级别 | 建议条件 | 主要动作 |
|---|---|---|
| 观察 | 最长锁等待连续 2 分钟超过 2 秒,或最老事务超过正常 P99 的 2 倍 | 记录阻塞 SQL、事务年龄和业务入口 |
| 严重 | 当前锁等待持续增加,且最长等待超过 5 秒或连接利用率超过 70% | 限制重试,定位扇出阻塞者,检查连接池等待 |
| 紧急 | 连接利用率超过 85%,同时锁等待持续存在并伴随应用超时 | 立即止损,保护核心流量,评估安全终止根阻塞事务 |
| 死锁异常 | 5 分钟新增死锁明显高于历史基线,例如达到 3 次以上 | 收集死锁明细,检查事务访问顺序和索引范围 |
让每个告警都能直接行动
一个可用的锁告警至少要附带实例、采样时间、当前等待数、最长等待、最老事务、连接利用率,以及用于追查的 waiting_pid 和 blocking_pid。告警触发后,值班人员应能从“资源是否快耗尽”迅速下钻到“哪个事务在阻塞谁”,而不是再临时拼 SQL。
上线前可在测试环境制造一次可控锁等待,确认指标能在一个采样周期内出现、告警按预期升级,并在事务提交后自动恢复。只有当“发现风险、定位根因、确认恢复”形成闭环,这组监控指标才真正具备线上治理价值。