
MySQL / 系统课时
演练死锁与事务改造
演练死锁与事务改造
本课通过两个并发事务以相反顺序更新同一组记录,稳定制造 InnoDB 死锁。你将从死锁日志还原锁获取顺序,再分别用统一访问顺序、缩小事务边界和索引优化降低死锁概率,并重新验证改造效果。
学习目标
- 构造可重复的两事务死锁,并识别 MySQL 的自动回滚行为。
- 使用 InnoDB 死锁信息还原“事务—资源”循环等待关系。
- 通过访问顺序、事务边界与索引设计实施有针对性的改造。
构造一个稳定死锁
先建立一张账户表:
DROP TABLE IF EXISTS account_balance;
CREATE TABLE account_balance (
  account_id BIGINT PRIMARY KEY,
  balance DECIMAL(12,2) NOT NULL
) ENGINE=InnoDB;

INSERT INTO account_balance VALUES
  (1, 1000.00),
  (2, 1000.00);
预期结果:
Query OK, 0 rows affected
Query OK, 0 rows affected
Query OK, 2 rows affected
打开两个 MySQL 会话。会话 A 先锁账户 1:
START TRANSACTION;
UPDATE account_balance
SET balance = balance - 10
WHERE account_id = 1;
预期结果:
Query OK, 0 rows affected
Query OK, 1 row affected
会话 B 先锁账户 2:
START TRANSACTION;
UPDATE account_balance
SET balance = balance - 20
WHERE account_id = 2;
预期结果:
Query OK, 0 rows affected
Query OK, 1 row affected
接着让会话 A 更新账户 2,此时它会等待会话 B:
UPDATE account_balance
SET balance = balance + 10
WHERE account_id = 2;
预期结果:
语句进入锁等待。保持会话 A 的语句处于等待状态,再让会话 B 更新账户 1:
UPDATE account_balance
SET balance = balance + 20
WHERE account_id = 1;
预期结果:
两个事务中的一个会收到:
ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction
实际被选为死锁牺牲者的事务可能不同。InnoDB 检测到等待环后会回滚其中一个完整事务,另一个事务的等待语句随后可以继续执行。收到 1213 的会话执行清理,仍存活的事务则提交:
ROLLBACK;预期结果:
Query OK, 0 rows affected在未被回滚且阻塞语句已经返回的另一个会话执行:
COMMIT;预期结果:
Query OK, 0 rows affected应用因此必须把死锁视为可重试的事务级错误,而不是只重新执行最后一条 SQL。
从日志还原等待环
死锁发生后立即查看最近一次死锁信息:
SHOW ENGINE INNODB STATUS;预期结果:
Status 字段中包含类似以下关键段落:
LATEST DETECTED DEADLOCK
*** (1) TRANSACTION:
...
*** (1) WAITING FOR THIS LOCK TO BE GRANTED:
...
*** (2) TRANSACTION:
...
*** (2) HOLDS THE LOCK(S):
...
*** WE ROLL BACK TRANSACTION (<ID>)
重点不是逐字阅读整段日志,而是提取四件事:事务 1 已持有什么锁、正在等待什么锁,事务 2 已持有什么锁、正在等待什么锁。把它们连起来,如果形成“事务 A 等 B 持有的资源,事务 B 又等 A 持有的资源”,就是死锁环。
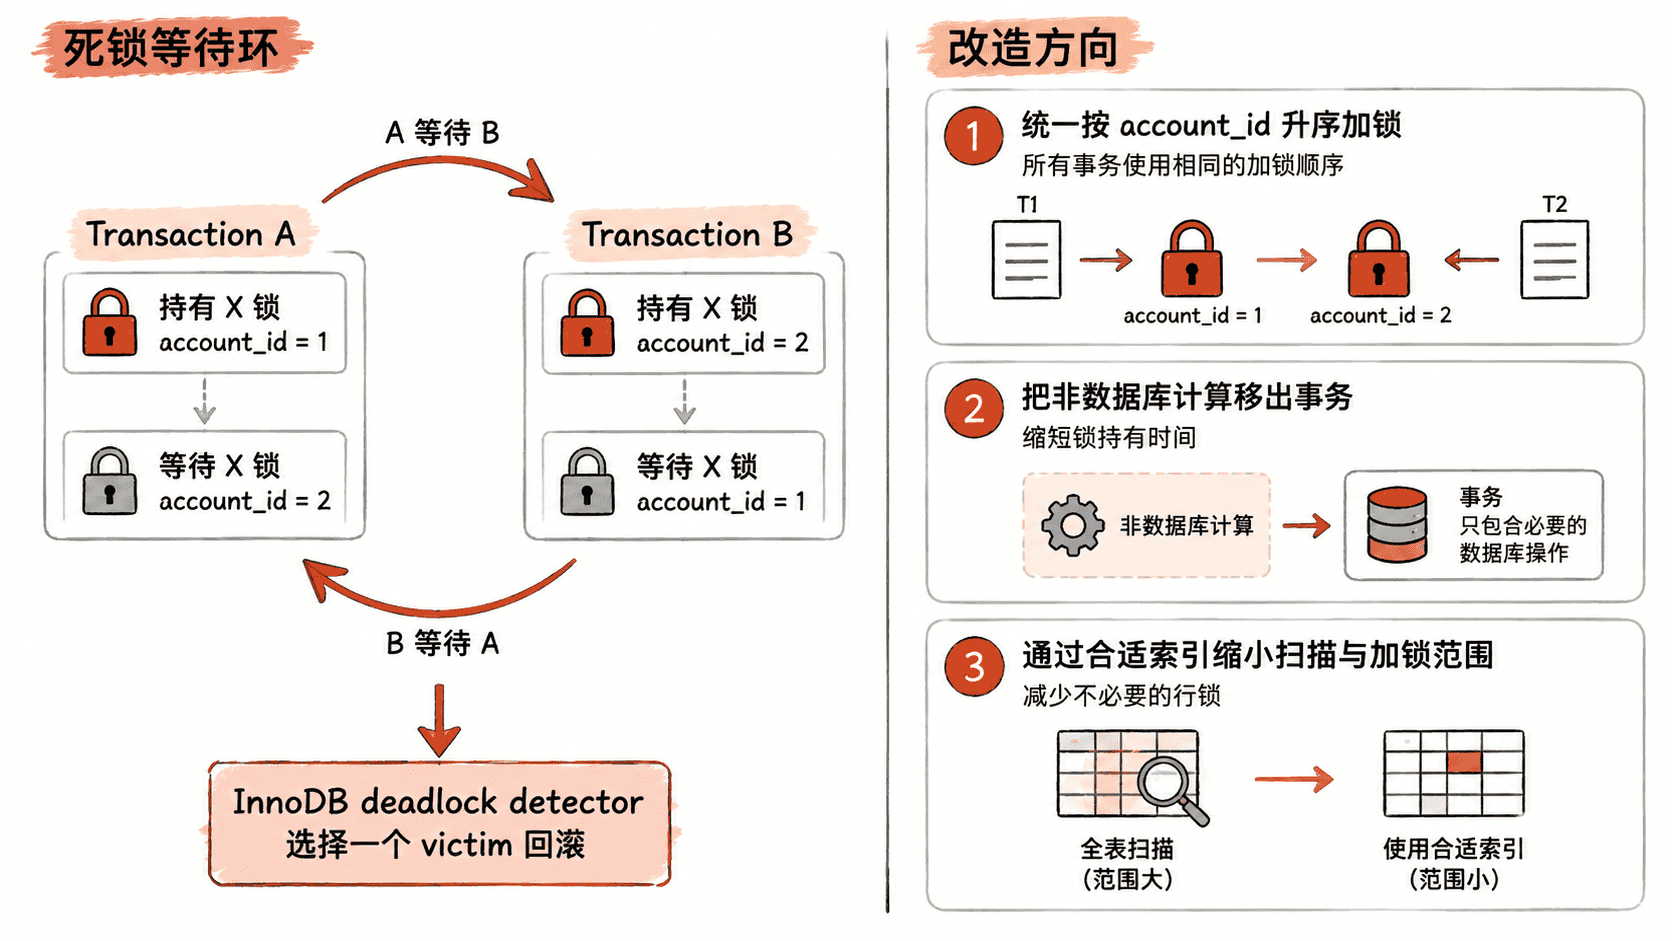
如果需要持续收集而不是只查看最近一次死锁,可以启用 innodb_print_all_deadlocks 将每次死锁写入 MySQL 错误日志,但生产环境应结合日志量和采集策略使用。
用统一访问顺序消除等待环
这个示例最直接的根因是两个事务访问资源的顺序相反。改造原则是:凡是一次事务要修改多个同类资源,都先确定资源集合,再按稳定顺序获取锁。
下面显式按照 account_id 从小到大锁定两个账户。所有涉及同一类账户资源的事务都必须遵循相同顺序:
START TRANSACTION;

SELECT account_id, balance
FROM account_balance
WHERE account_id = 1
FOR UPDATE;

SELECT account_id, balance
FROM account_balance
WHERE account_id = 2
FOR UPDATE;

UPDATE account_balance
SET balance = balance - 10
WHERE account_id = 1;

UPDATE account_balance
SET balance = balance + 10
WHERE account_id = 2;

COMMIT;
预期结果:
Query OK, 0 rows affected
1 row in set
1 row in set
Query OK, 1 row affected
Query OK, 1 row affected
Query OK, 0 rows affected
当并发事务都以相同顺序获取账户 1、账户 2 的锁时,后来的事务仍可能等待,但不会由这两个资源形成“你等我、我等你”的反向闭环。锁等待不等于死锁:等待可以被前序事务提交自然解除,死锁则必须打破循环依赖。
缩短事务并修正索引边界
统一访问顺序解决的是资源顺序问题,真实系统还常有两类放大因素。第一类是事务中夹杂远程调用、复杂计算或用户交互,让已获取的锁被无谓持有;第二类是过滤条件缺少合适索引,扫描更多记录并扩大潜在锁冲突集合。
例如按账户主键更新时,可以先检查执行计划是否使用预期索引:
EXPLAIN
UPDATE account_balance
SET balance = balance + 1
WHERE account_id = 2;
预期结果:
执行计划应显示通过 PRIMARY 索引定位目标记录,预计检查行数接近 1;具体列值会随 MySQL 版本和统计信息变化。真实业务若通过非唯一条件更新,应检查 WHERE 条件的索引设计,并把网络请求、序列化、报表计算等与数据库写入无关的工作移到事务之外。这样即使无法完全消灭冲突,也能同时缩小锁范围和锁持有时间。
重新压测并验证改造
改造后不要只验证“手工复现不出来了”。应重新使用相同并发模型,记录死锁次数、事务重试次数、P95/P99 延迟和吞吐量,并确认最终数据仍满足业务约束。
先检查当前事务是否仍出现持续锁等待或异常长事务:
SELECT
  trx_mysql_thread_id AS thread_id,
  trx_state,
  trx_started,
  trx_rows_locked,
  trx_query
FROM information_schema.innodb_trx
ORDER BY trx_started;
预期结果:
无活动事务时结果为空;压测期间可以出现 RUNNING 事务,但不应持续出现同一事务长时间处于 LOCK WAIT。最后把应用重试限制在完整事务边界:收到 1213 后回滚整个事务,经过有上限的随机退避再重新执行,不能只重放最后一条 SQL。若压测仍有大量死锁,应继续根据死锁日志核对资源访问顺序、事务持续时间和索引命中情况,而不是单纯提高重试次数。