
MySQL / 系统课时
演练锁等待突增故障
演练锁等待突增故障
本课用一个可控的长事务制造锁等待堆积,并从应用超时、连接状态、锁等待关系一路定位到阻塞事务。完成后,你将能判断“谁在等谁”、评估是否可以终止阻塞会话,并用最小风险恢复业务。
学习目标
- 构造可重复的行锁等待突增场景,并识别应用侧典型症状。
- 使用 MySQL 8.0 的事务与 Performance Schema 视图还原等待链。
- 按“先止损、再验证、后复盘”的顺序安全解除阻塞。
注入一个可控的长事务
使用 InnoDB 测试表,两个终端分别建立会话。先准备数据:
DROP TABLE IF EXISTS lock_lab;
CREATE TABLE lock_lab (
  id BIGINT PRIMARY KEY,
  status VARCHAR(20) NOT NULL,
  updated_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP
             ON UPDATE CURRENT_TIMESTAMP
) ENGINE=InnoDB;

INSERT INTO lock_lab (id, status) VALUES
  (1, 'READY'),
  (2, 'READY');
预期结果:
Query OK, 0 rows affected
Query OK, 0 rows affected
Query OK, 2 rows affected
在会话 A 中开启事务并锁住 id=1,不要提交:
SET SESSION innodb_lock_wait_timeout = 60;
START TRANSACTION;
UPDATE lock_lab
SET status = 'PROCESSING'
WHERE id = 1;
预期结果:
Query OK, 0 rows affected
Query OK, 0 rows affected
Query OK, 1 row affected
此时在会话 B 执行相同记录的更新,语句会进入等待;如果应用连接池里同时出现多条类似请求,等待线程会快速累积:
SET SESSION innodb_lock_wait_timeout = 60;
UPDATE lock_lab
SET status = 'DONE'
WHERE id = 1;
预期结果:
语句暂不返回,直到会话 A 提交、回滚,或等待超时。从现象定位到阻塞事务
应用层通常先表现为接口延迟、数据库超时和连接池占满。数据库侧先看当前长事务,再看锁等待边。
SELECT
  trx_mysql_thread_id AS thread_id,
  trx_state,
  trx_started,
  trx_rows_locked,
  trx_query
FROM information_schema.innodb_trx
ORDER BY trx_started;
预期结果:
thread_id  trx_state     trx_started  trx_rows_locked  trx_query
<ID>       RUNNING       <TIME>       1                NULL
<ID>       LOCK WAIT     <TIME>       1                UPDATE lock_lab ...
继续关联 performance_schema.data_lock_waits 与 performance_schema.data_locks,直接得到等待者和阻塞者的线程 ID:
SELECT
  wt.PROCESSLIST_ID AS waiting_thread,
  bt.PROCESSLIST_ID AS blocking_thread,
  rl.OBJECT_SCHEMA,
  rl.OBJECT_NAME,
  rl.INDEX_NAME,
  rl.LOCK_TYPE,
  rl.LOCK_MODE
FROM performance_schema.data_lock_waits w
JOIN performance_schema.data_locks rl
  ON rl.ENGINE_LOCK_ID = w.REQUESTING_ENGINE_LOCK_ID
JOIN performance_schema.data_locks bl
  ON bl.ENGINE_LOCK_ID = w.BLOCKING_ENGINE_LOCK_ID
JOIN performance_schema.threads wt
  ON wt.THREAD_ID = rl.THREAD_ID
JOIN performance_schema.threads bt
  ON bt.THREAD_ID = bl.THREAD_ID;
预期结果:
waiting_thread  blocking_thread  OBJECT_SCHEMA  OBJECT_NAME  INDEX_NAME  LOCK_TYPE  LOCK_MODE
<ID>            <ID>             <VALUE>        lock_lab     PRIMARY     RECORD     X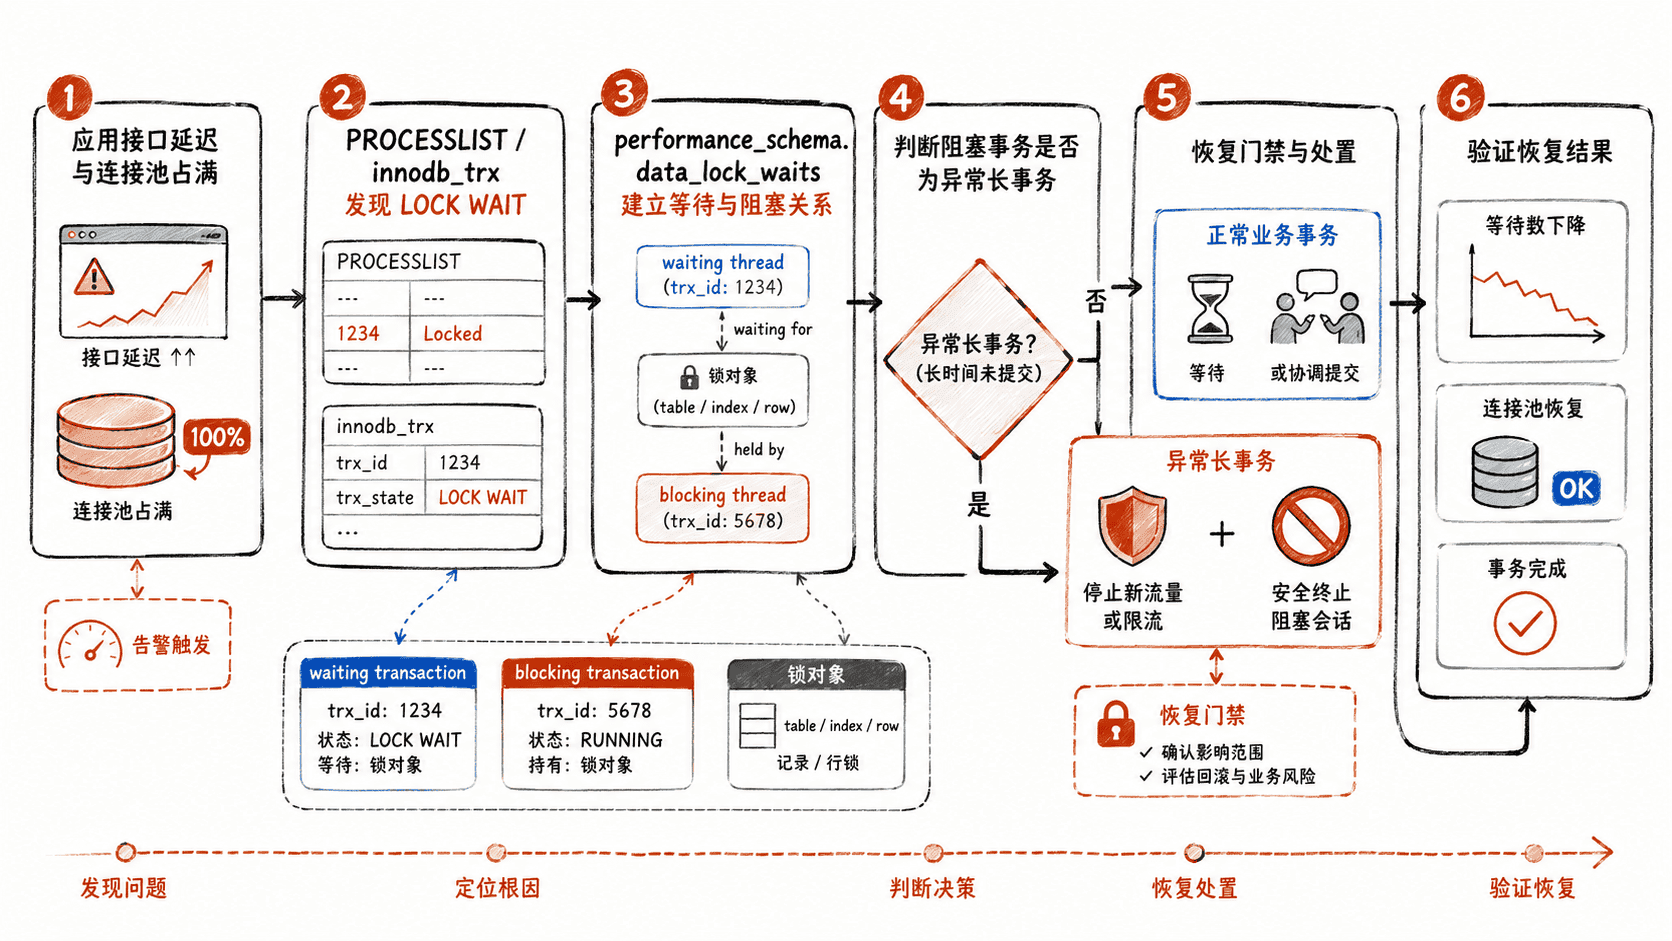
只看到很多 LOCK WAIT 还不够,必须确认阻塞事务的业务含义、开始时间、当前语句以及是否持有大量锁。若阻塞者是正常的大批量写入,优先协调其尽快提交;若确认是遗留会话、脚本异常或已失去业务价值的长事务,才进入终止步骤。
安全解除阻塞并验证恢复
终止事务前先记录阻塞线程 ID、事务开始时间和关联业务,必要时暂停制造新等待的入口。确认阻塞会话可以中断后执行:
KILL <ID>;预期结果:
Query OK, 0 rows affected<ID> 为前面识别出的 blocking_thread,实际值每次不同。KILL 会断开该连接,未提交事务由 InnoDB 回滚;大事务回滚本身可能持续较久,因此不能把“命令已返回”当成故障已经结束。
随后重新检查等待关系:
SELECT COUNT(*) AS lock_wait_edges
FROM performance_schema.data_lock_waits;
预期结果:
lock_wait_edges
0
最后在会话 B 重新执行更新并提交,确认业务写入恢复:
START TRANSACTION;
UPDATE lock_lab SET status = 'DONE' WHERE id = 1;
COMMIT;
SELECT id, status FROM lock_lab WHERE id = 1;
预期结果:
Query OK, 0 rows affected
Query OK, 1 row affected
Query OK, 0 rows affected
id  status
1   DONE
复盘锁等待为什么会放大
锁等待突增通常不是“有一把锁”这么简单,而是阻塞事务持续时间、受影响行数和并发请求数量叠加后的结果。长事务延迟提交会延长锁持有时间;缺少合适索引可能扩大扫描与加锁范围;应用重试如果没有退避,还会把同一热点继续放大。
演练结束后,应把改造项落到可验证指标:缩短事务边界、让更新条件命中合适索引、给热点写入做并发限制,并持续观察等待线程数、事务年龄和接口延迟。真正的恢复完成标准不是“杀掉一个连接”,而是等待链消失且业务吞吐、连接池和错误率都回到正常水平。