
MySQL / 系统课时
推导等值查询的锁范围
推导等值查询的锁范围
等值条件看起来最简单,但“唯一索引命中、普通索引命中、目标记录不存在”三种情况的锁范围并不相同。本节用同一张表逐个实验,建立一套从访问路径推导 InnoDB 锁范围的方法。
学习目标
- 区分唯一索引命中与普通二级索引命中时的锁范围
- 解释等值条件查不到记录时为什么仍可能产生 Gap Lock
- 先根据访问路径推导,再用并发插入验证结论
先把等值条件翻译成索引访问
判断一条等值锁定读,第一步不是看 =,而是看它实际走什么索引。唯一索引能把一个键值定位到至多一条记录;普通二级索引允许重复值,执行器必须扫描完整的等值键区间;记录不存在时,执行器最终会停在该键应该插入的位置。
三种典型情况可以先记成下面的推导结果:
| 条件 | 访问路径 | 主要锁范围 |
|---|---|---|
| 唯一索引等值且命中 | 唯一索引精确定位 | 已命中的索引记录,通常不需要相邻 Gap Lock |
| 普通二级索引等值且命中 | 扫描全部重复键 | 匹配记录及保证等值范围不出现新记录所需的间隙 |
| 等值条件未命中 | 定位到插入位置 | 对应插入位置的 Gap Lock |
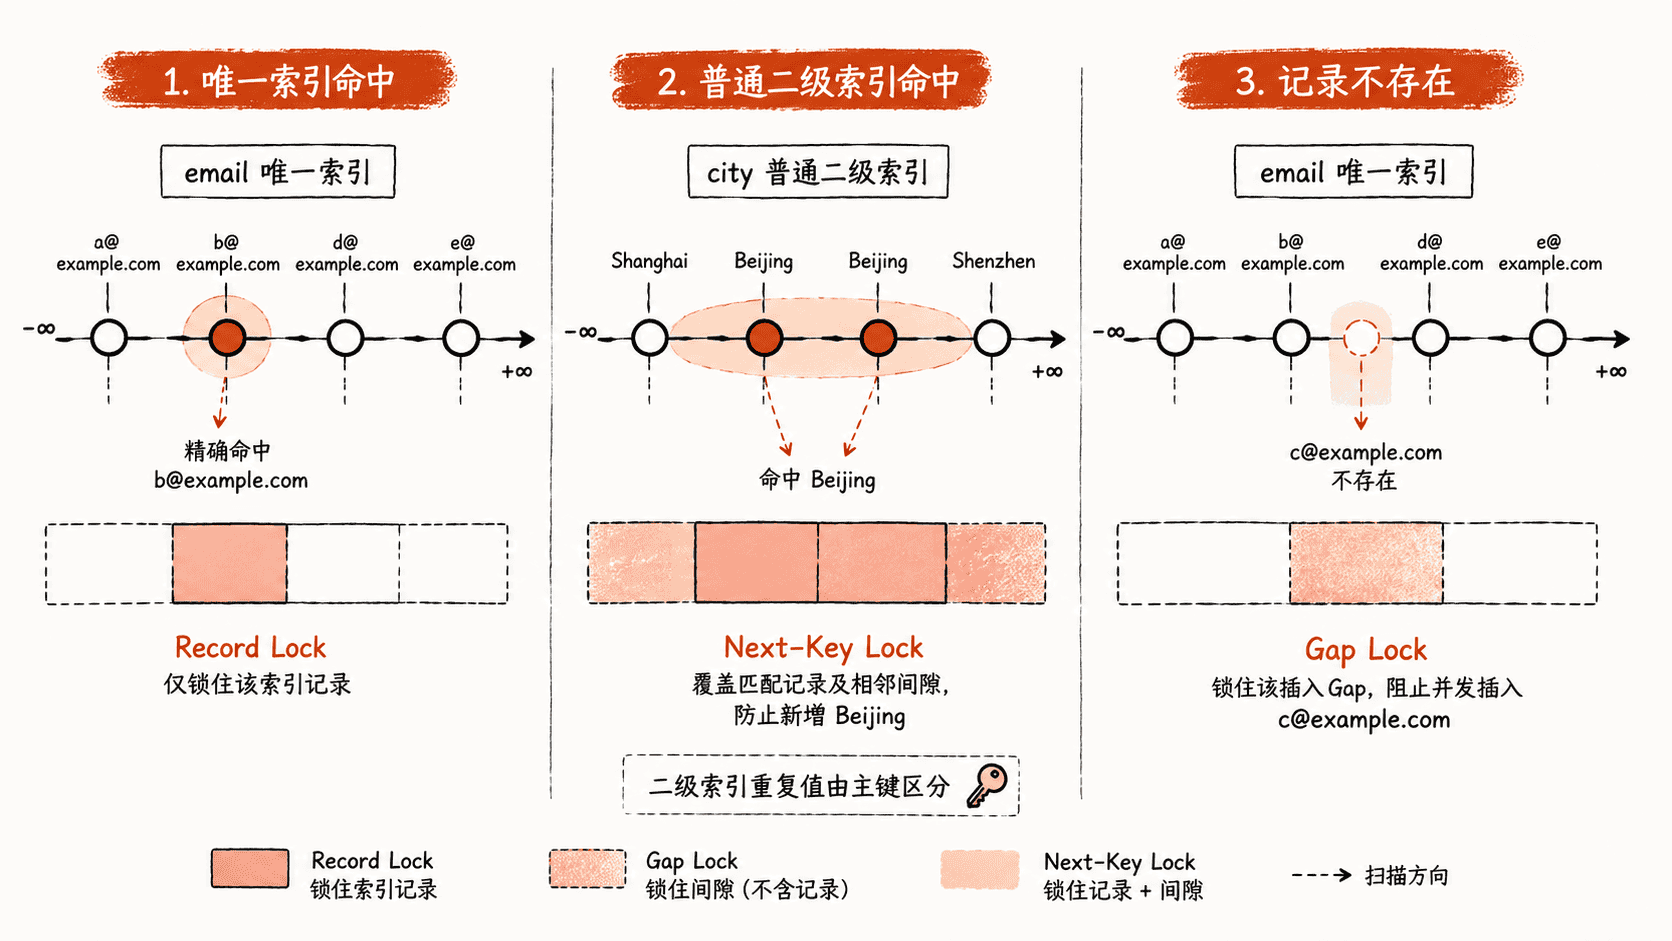
建立可重复的测试数据
下面同时准备唯一索引 uk_email 和普通二级索引 idx_city。后续三个实验都在 REPEATABLE READ 下执行。
DROP TABLE IF EXISTS customer_lock_demo;
CREATE TABLE customer_lock_demo (
  id BIGINT PRIMARY KEY,
  email VARCHAR(64) NOT NULL,
  city VARCHAR(32) NOT NULL,
  UNIQUE KEY uk_email (email),
  KEY idx_city (city)
) ENGINE=InnoDB;

INSERT INTO customer_lock_demo (id, email, city) VALUES
(1, 'a@example.com', 'Beijing'),
(2, 'b@example.com', 'Beijing'),
(3, 'd@example.com', 'Shanghai'),
(4, 'e@example.com', 'Shenzhen');
预期结果
表 customer_lock_demo 创建成功,并写入 4 行数据。唯一索引命中只需精确锁定记录
会话 A 通过唯一索引命中 b@example.com,并保持事务不提交。
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;
START TRANSACTION;

SELECT id, email, city
FROM customer_lock_demo
WHERE email = 'b@example.com'
FOR UPDATE;
预期输出
+----+---------------+---------+
| id | email         | city    |
+----+---------------+---------+
|  2 | b@example.com | Beijing |
+----+---------------+---------+
1 row in set
会话 B 插入另一个不同的唯一键。因为会话 A 不需要用相邻间隙来防止第二个 b@example.com 出现,这个插入可以完成。
INSERT INTO customer_lock_demo (id, email, city)
VALUES (10, 'bb@example.com', 'Guangzhou');
预期输出
Query OK, 1 row affected实验结束后在会话 A 提交。
COMMIT;预期输出
Query OK, 0 rows affected普通二级索引命中要保护整个等值区间
现在会话 A 改为锁定所有 city = 'Beijing' 的记录。普通索引允许以后再出现第三个 Beijing,所以只锁两条现有记录并不能阻止幻行。
START TRANSACTION;

SELECT id, email, city
FROM customer_lock_demo
WHERE city = 'Beijing'
FOR UPDATE;
预期输出
+----+---------------+---------+
| id | email         | city    |
+----+---------------+---------+
|  1 | a@example.com | Beijing |
|  2 | b@example.com | Beijing |
+----+---------------+---------+
2 rows in set
会话 B 尝试再插入一个 Beijing。为了让实验快速返回,先缩短锁等待时间。
SET SESSION innodb_lock_wait_timeout = 2;

INSERT INTO customer_lock_demo (id, email, city)
VALUES (11, 'x@example.com', 'Beijing');
预期输出
ERROR 1205 (HY000): Lock wait timeout exceeded; try restarting transaction会话 A 提交后,相关记录锁和间隙锁一起释放。
COMMIT;预期输出
Query OK, 0 rows affected记录不存在时锁住的是插入位置
最后看唯一索引“查无此值”的情况。当前数据中没有 c@example.com,但它按索引顺序应位于 bb@example.com 与 d@example.com 之间。会话 A 的锁定读虽然返回空集,仍需要保护这个插入位置,避免事务期间突然出现满足条件的新记录。
START TRANSACTION;

SELECT id, email, city
FROM customer_lock_demo
WHERE email = 'c@example.com'
FOR UPDATE;
预期输出
Empty set会话 B 此时插入同一个唯一键会等待,并在超时后报错。
SET SESSION innodb_lock_wait_timeout = 2;

INSERT INTO customer_lock_demo (id, email, city)
VALUES (12, 'c@example.com', 'Chengdu');
预期输出
ERROR 1205 (HY000): Lock wait timeout exceeded; try restarting transaction完成实验后在会话 A 提交。
COMMIT;预期输出
Query OK, 0 rows affected推导等值查询时,可以固定采用同一顺序:先用 EXPLAIN 确认访问索引,再判断该索引是否唯一、条件是否命中,随后把匹配键和插入位置放到有序索引线上,最后用并发写入验证。真正决定锁范围的是索引访问路径,不是 SQL 表面上有没有写等号。