
MySQL / 系统课时
构造高并发订单事务场景
构造高并发订单事务场景
要演练锁等待和死锁,先要有一个可重复、可量化的订单事务负载。本课用订单创建、双 SKU 库存扣减和状态更新组成同一事务,再让并发线程采用相反的加锁顺序,得到可用于后续治理对比的吞吐、延迟、锁等待和死锁基线。
学习目标
- 搭建可随时重置的订单与库存实验表
- 用多线程事务稳定制造热点锁竞争和可观察的死锁
- 记录吞吐、P95 延迟、行锁等待和死锁数量作为演练基线
准备可重复的实验数据
先在独立测试实例中创建实验库。两条库存记录会成为热点资源,订单表只记录事务是否最终提交;不要在生产库执行本课负载。
CREATE DATABASE IF NOT EXISTS lock_lab;
USE lock_lab;

DROP TABLE IF EXISTS orders;
DROP TABLE IF EXISTS inventory;

CREATE TABLE inventory (
  sku_id BIGINT PRIMARY KEY,
  stock INT NOT NULL
) ENGINE = InnoDB;

CREATE TABLE orders (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  worker_id INT NOT NULL,
  status VARCHAR(16) NOT NULL,
  created_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP
) ENGINE = InnoDB;

INSERT INTO inventory (sku_id, stock)
VALUES (1, 10000), (2, 10000);

SELECT COUNT(*) AS inventory_rows FROM inventory;
SELECT COUNT(*) AS order_rows FROM orders;
预期结果
+----------------+
| inventory_rows |
+----------------+
|              2 |
+----------------+

+------------+
| order_rows |
+------------+
|          0 |
+------------+
后续每轮演练前重新清空 orders 并把两条库存恢复到相同值,才能让不同方案的指标具有可比性。
用对向锁顺序制造竞争
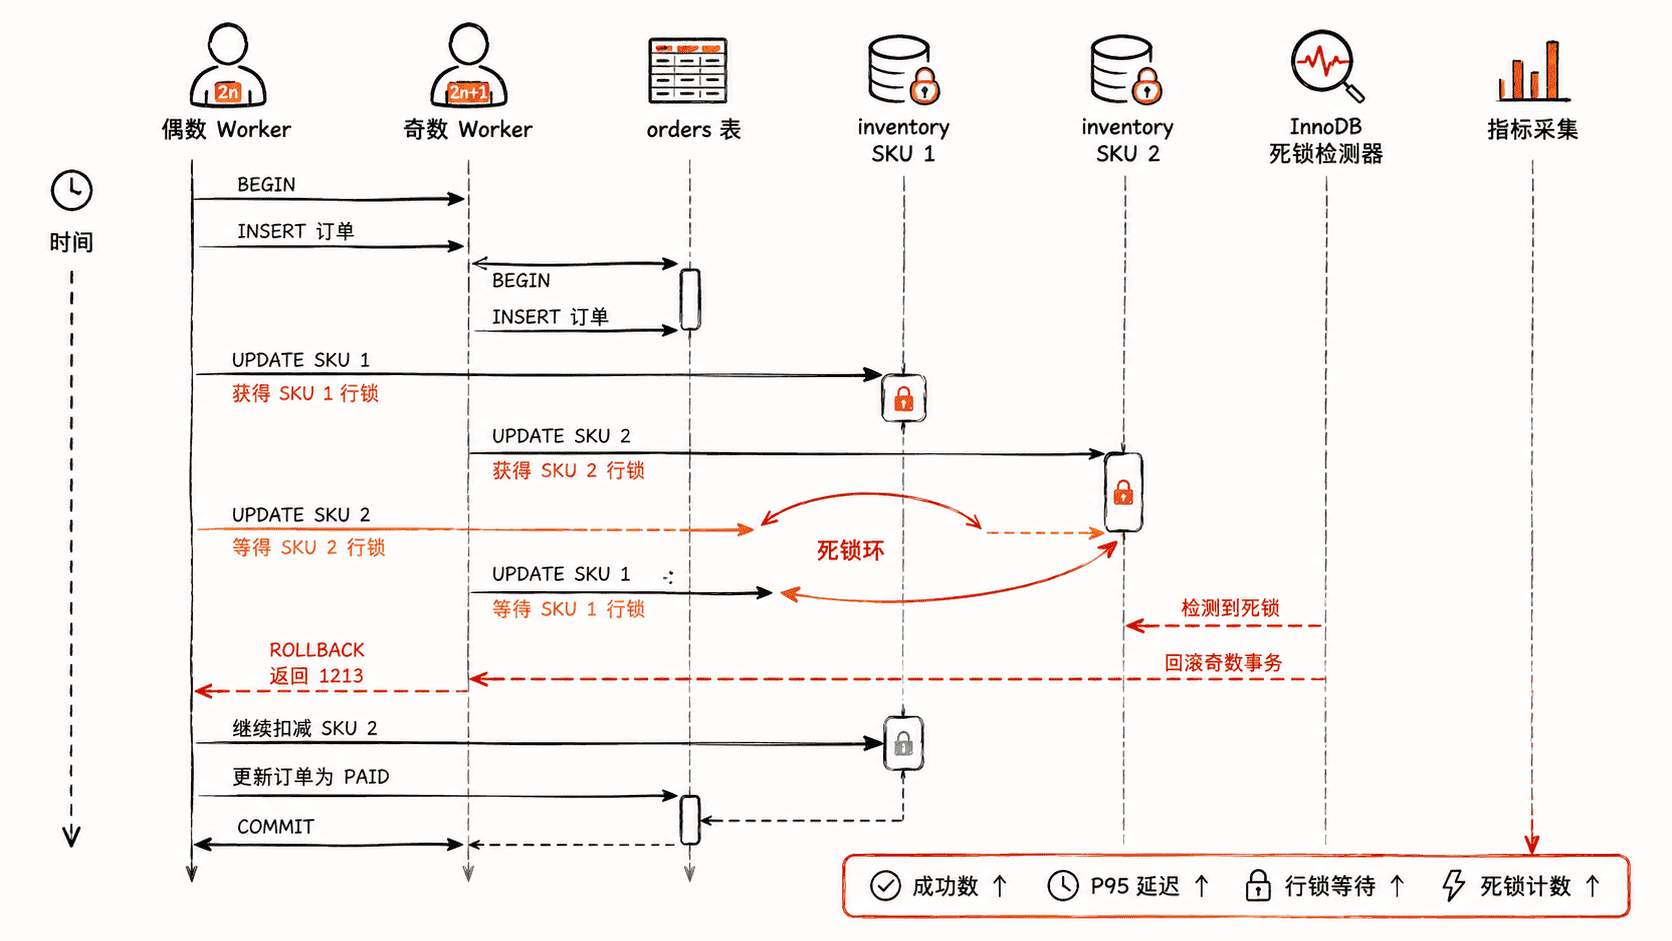
下面的程序需要 Python 3 和 mysql-connector-python。8 个线程各执行 20 个事务:偶数线程先锁 SKU 1 再锁 SKU 2,奇数线程反过来;两次扣减之间故意暂停 30 毫秒,扩大等待窗口。MySQL 检测到等待环时会回滚其中一个事务并返回 1213。
from concurrent.futures import ThreadPoolExecutor
import os
import statistics
import time

import mysql.connector
from mysql.connector import Error

THREADS = 8
TX_PER_WORKER = 20
SLEEP_BETWEEN_LOCKS = 0.03

CONFIG = {
    "host": os.getenv("MYSQL_HOST", "127.0.0.1"),
    "port": int(os.getenv("MYSQL_PORT", "3306")),
    "user": os.getenv("MYSQL_USER", "root"),
    "password": os.getenv("MYSQL_PASSWORD", ""),
    "database": "lock_lab",
}


def worker(worker_id):
    conn = mysql.connector.connect(**CONFIG)
    cur = conn.cursor()
    committed = 0
    deadlocks = 0
    other_errors = 0
    latencies = []

    try:
        for _ in range(TX_PER_WORKER):
            started = time.perf_counter()
            try:
                conn.start_transaction(isolation_level="READ COMMITTED")
                cur.execute(
                    "INSERT INTO orders(worker_id, status) VALUES (%s, 'CREATED')",
                    (worker_id,),
                )
                order_id = cur.lastrowid

                # 两类线程故意采用相反的行锁顺序,形成等待环的必要条件。
                sku_order = (1, 2) if worker_id % 2 == 0 else (2, 1)
                for sku_id in sku_order:
                    cur.execute(
                        "UPDATE inventory SET stock = stock - 1 WHERE sku_id = %s",
                        (sku_id,),
                    )
                    time.sleep(SLEEP_BETWEEN_LOCKS)

                cur.execute(
                    "UPDATE orders SET status = 'PAID' WHERE id = %s",
                    (order_id,),
                )
                conn.commit()
                committed += 1
                latencies.append(time.perf_counter() - started)
            except Error as exc:
                conn.rollback()
                if exc.errno == 1213:
                    deadlocks += 1
                else:
                    other_errors += 1
            except Exception:
                conn.rollback()
                other_errors += 1
    finally:
        cur.close()
        conn.close()

    return committed, deadlocks, other_errors, latencies


started = time.perf_counter()
with ThreadPoolExecutor(max_workers=THREADS) as pool:
    results = list(pool.map(worker, range(THREADS)))
wall_seconds = time.perf_counter() - started

committed = sum(item[0] for item in results)
deadlocks = sum(item[1] for item in results)
other_errors = sum(item[2] for item in results)
latencies = [value for item in results for value in item[3]]

if len(latencies) >= 2:
    p95 = statistics.quantiles(latencies, n=100, method="inclusive")[94]
elif latencies:
    p95 = latencies[0]
else:
    p95 = 0.0

print(
    f"attempts={THREADS * TX_PER_WORKER} committed={committed} "
    f"deadlocks={deadlocks} other_errors={other_errors}"
)
print(f"throughput_tps={committed / wall_seconds:.2f} p95_ms={p95 * 1000:.2f}")
预期输出
attempts=160 committed=<VALUE> deadlocks=<VALUE> other_errors=<VALUE>
throughput_tps=<VALUE> p95_ms=<VALUE>
具体数值取决于 CPU、连接延迟和线程调度。若一直没有死锁,可先确认线程确实并行,再适度提高线程数或 SLEEP_BETWEEN_LOCKS;不要通过扩大生产负载来“验证”演练效果。
记录数据库侧锁指标
程序给出吞吐与端到端延迟,数据库侧还要记录累计行锁等待和死锁计数。下面的查询在压测前执行一次、压测后再执行一次,两次 VARIABLE_VALUE 相减就是本轮增量。
SELECT
  VARIABLE_NAME,
  VARIABLE_VALUE
FROM performance_schema.global_status
WHERE VARIABLE_NAME IN ('Innodb_row_lock_waits', 'Innodb_deadlocks')
ORDER BY VARIABLE_NAME;
预期结果
+-----------------------+----------------+
| VARIABLE_NAME         | VARIABLE_VALUE |
+-----------------------+----------------+
| Innodb_deadlocks      | <VALUE>        |
| Innodb_row_lock_waits | <VALUE>        |
+-----------------------+----------------+
Innodb_deadlocks 和 Innodb_row_lock_waits 都是实例启动以来的累计值,所以不能只看压测后的绝对值。基线至少应保存本轮增量、成功提交数、吞吐 TPS 和 P95 延迟,并注明线程数、每线程事务数及隔离级别。
固定变量后再做治理对比
一轮有效演练应满足:总尝试次数为 160,committed + deadlocks + other_errors = 160,且 other_errors 理想情况下为 0;同时锁等待或死锁指标有可观察变化。若死锁数为 0,也要保留结果,因为线程调度本身具有随机性。
后续比较“统一加锁顺序”“缩短事务”“调整隔离级别”等治理方案时,只改变一个变量,其余线程数、数据规模、暂停时间和事务逻辑保持不变。这样得到的吞吐、P95 和锁指标差异才可以归因到治理措施,而不是测试条件变化。