
MySQL / 系统课时
解读 InnoDB 死锁日志
解读 InnoDB 死锁日志
LATEST DETECTED DEADLOCK 是还原 InnoDB 死锁现场的核心证据。本课给出一套固定阅读顺序:先认出参与事务和当前 SQL,再配对“已持有锁”与“正在等待的锁”,最后把日志还原成等待环并确认被回滚的牺牲事务。
学习目标
- 从 InnoDB 状态中定位最近一次死锁片段
- 识别事务、SQL、持有锁、等待锁和牺牲者
- 根据锁对象与等待方向还原触发死锁的执行时序
先取得完整的死锁片段
死锁发生后,可在有足够权限的连接中执行 SHOW ENGINE INNODB STATUS。它返回的是 InnoDB 综合状态,其中 LATEST DETECTED DEADLOCK 只保留最近一次检测到的用户事务死锁,因此排查时应完整截取该段,而不是只保存最后一行 1213 错误。
SHOW ENGINE INNODB STATUS\G预期结果(关键结构;实际时间、事务 ID、页号、线程 ID、表名和 SQL 会不同)
------------------------
LATEST DETECTED DEADLOCK
------------------------
<TIME>
*** (1) TRANSACTION:
TRANSACTION <ID>, ACTIVE <VALUE> sec
...
UPDATE account_balance SET ... WHERE id = 2

*** (1) HOLDS THE LOCK(S):
RECORD LOCKS ... index PRIMARY of table `demo`.`account_balance` ... lock mode X ...

*** (1) WAITING FOR THIS LOCK TO BE GRANTED:
RECORD LOCKS ... index PRIMARY of table `demo`.`account_balance` ... lock_mode X ... waiting

*** (2) TRANSACTION:
TRANSACTION <ID>, ACTIVE <VALUE> sec
...
UPDATE account_balance SET ... WHERE id = 1

*** (2) HOLDS THE LOCK(S):
RECORD LOCKS ... index PRIMARY of table `demo`.`account_balance` ... lock mode X ...

*** (2) WAITING FOR THIS LOCK TO BE GRANTED:
RECORD LOCKS ... index PRIMARY of table `demo`.`account_balance` ... lock_mode X ... waiting

*** WE ROLL BACK TRANSACTION (2)<TIME>、<ID> 与 <VALUE> 都是动态值。不同 MySQL 版本和具体锁类型会让字段细节有所差异,但“事务 → 持有锁 → 等待锁 → 回滚事务”的主结构保持稳定。
按事务块提取四类信息
阅读时不要从物理记录十六进制开始。先为每个 *** (n) TRANSACTION 建一张最小卡片,只记录事务 ID、MySQL thread id、当前 SQL、已持有锁和等待锁。这样能迅速把长日志压缩成两三条依赖关系。
锁行里最有价值的是对象和模式。index PRIMARY of table ... 告诉你冲突发生在哪张表、哪个索引;lock mode X 表示排他锁;waiting 表示该锁尚未获得;locks rec but not gap 表示锁针对索引记录而非前置间隙。若看到 gap、next-key 或不同索引名,则要结合 SQL 谓词和索引访问路径重新判断资源范围。
事务编号 (1)、(2) 只是日志中的参与者标签,不应被当成业务开始顺序。真正的先后关系要从“谁已经持有什么、谁正在等什么”推出来。
把日志还原成等待环
假设事务 1 的 HOLDS THE LOCK(S) 指向 id=1,而它的 WAITING FOR THIS LOCK TO BE GRANTED 指向 id=2;事务 2 则正好相反。可以先写成两条等待边:T1 等待 T2 持有的 id=2,T2 等待 T1 持有的 id=1。两条边闭合后,死锁环已经成立。
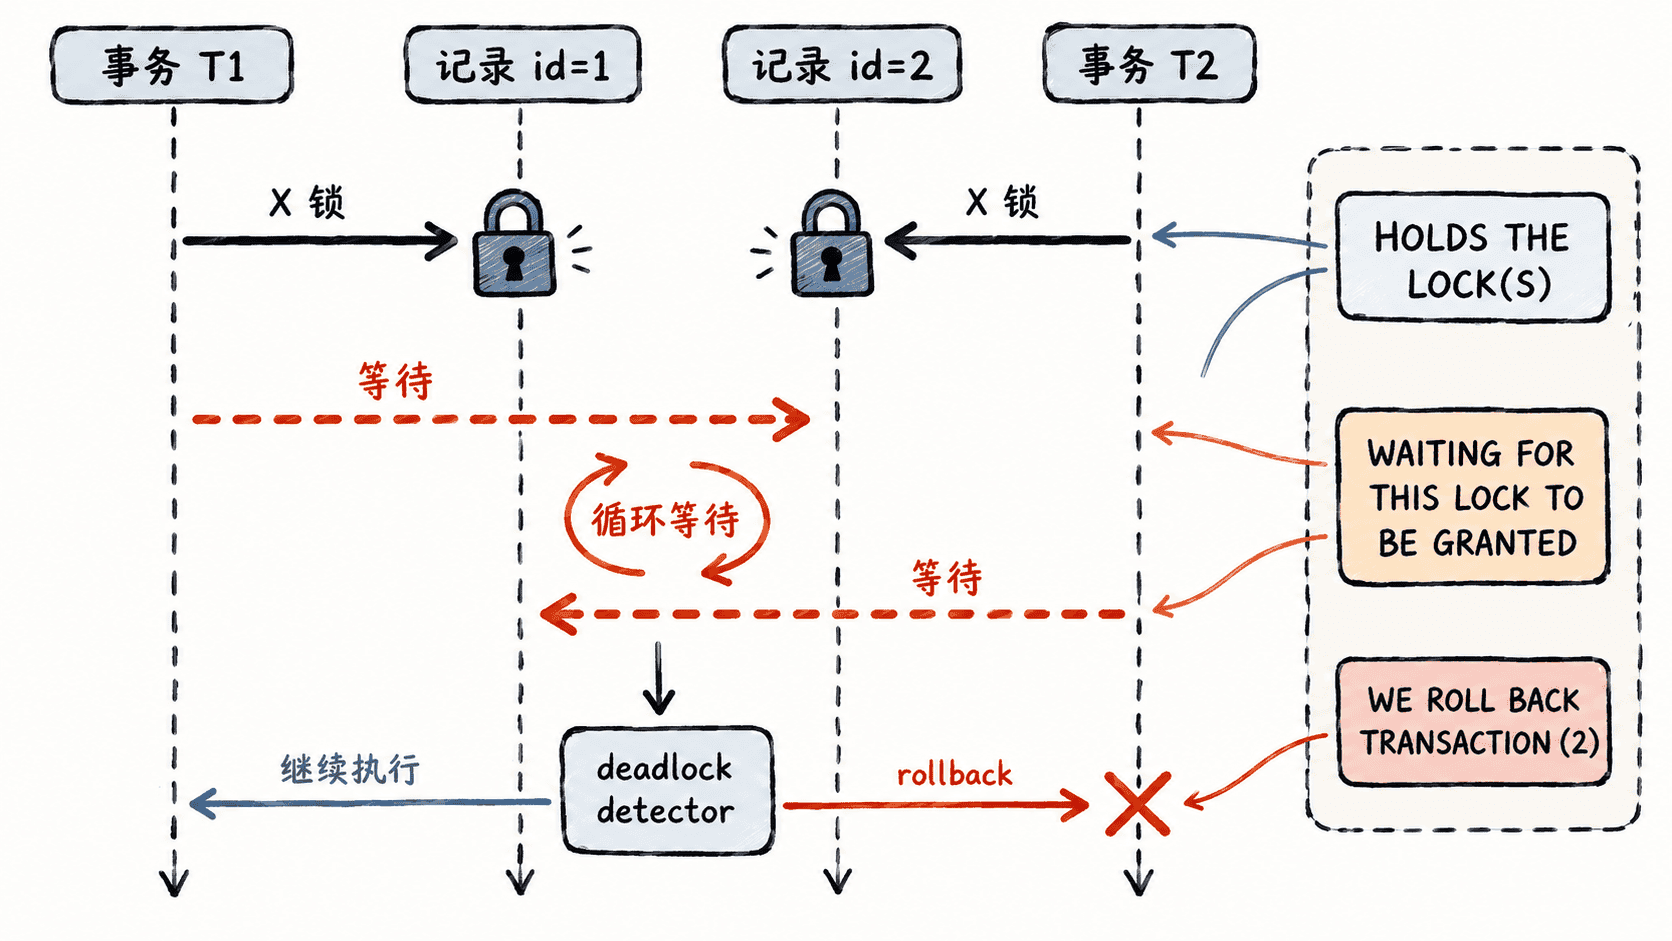
还原时序时只需要证明“持有发生在等待之前”,不必从事务 ID 大小推断时间。当前 SQL 通常是最后触发等待的语句,而此前让事务获得第一把锁的语句可能不在当前 SQL 行里,因此还应结合 HOLDS THE LOCK(S)、应用调用链或慢日志判断事务之前执行过什么。
找到牺牲者但不要误判根因
*** WE ROLL BACK TRANSACTION (2) 明确告诉你 InnoDB 最终回滚了哪个事务。牺牲者只是为了打破环而被选中的事务,不等于它就是“写错代码的一方”;死锁通常由至少两条业务路径共同构成,真正需要修复的是互相冲突的资源访问顺序或过大的锁定范围。
死锁检测完成后,牺牲事务已被回滚,另一事务通常会解除等待继续运行。因此事后再查看实时锁等待表时,可能已经看不到原来的环。这也是死锁报告比单纯查看当前等待更适合做事后分析的原因。
用固定检查顺序完成定位
面对一段长死锁日志,可以稳定按以下顺序处理:
- 找到
LATEST DETECTED DEADLOCK,确认报告对应的时间窗口。 - 分别记录每个事务的 ID、线程、当前 SQL 和涉及的表。
- 对每个事务配对
HOLDS THE LOCK(S)与WAITING FOR THIS LOCK TO BE GRANTED。 - 用“等待者 → 持有者”画出依赖边,确认是否闭合以及锁对象属于哪个索引记录或范围。
- 读取
WE ROLL BACK TRANSACTION确认牺牲者,再回到应用事务代码检查资源访问顺序、事务长度和索引命中情况。
如果死锁频繁发生,仅依赖 LATEST DETECTED DEADLOCK 会覆盖旧现场。诊断窗口可以临时启用 innodb_print_all_deadlocks,让每次死锁都写入 MySQL 错误日志;完成采集后再关闭,避免长期增加日志噪声。最终修复应以统一锁顺序、缩短事务和缩小扫描范围为主,同时保留对 1213 的事务级重试。