
MySQL / 系统课时
认识事务并发故障链路
认识事务并发故障链路
并发故障难排,不是因为“锁”本身难懂,而是业务慢请求、SQL、事务边界、索引访问、锁等待与资源消耗会互相放大。本课建立一条可验证的因果链,让你知道出现超时、卡顿或吞吐下降时该先看什么、再追到哪里。
学习目标
- 把业务请求、SQL、事务、索引访问、锁等待和资源指标串成完整因果链
- 区分锁等待、死锁与资源拥塞,避免把所有慢请求都归因于锁
- 使用 MySQL 8.x 性能视图确认等待者、阻塞者和竞争对象
把现象连成一条因果链
一次并发故障通常从业务请求变慢开始,但真正的根因可能位于更深层。请求进入应用后执行 SQL,SQL 被事务边界包裹;InnoDB 根据执行计划访问索引记录并申请记录锁、间隙锁或表级意向锁。若目标锁已被其他事务持有,请求进入等待,连接被占住,最终可能继续放大线程、CPU、I/O 或连接池压力。
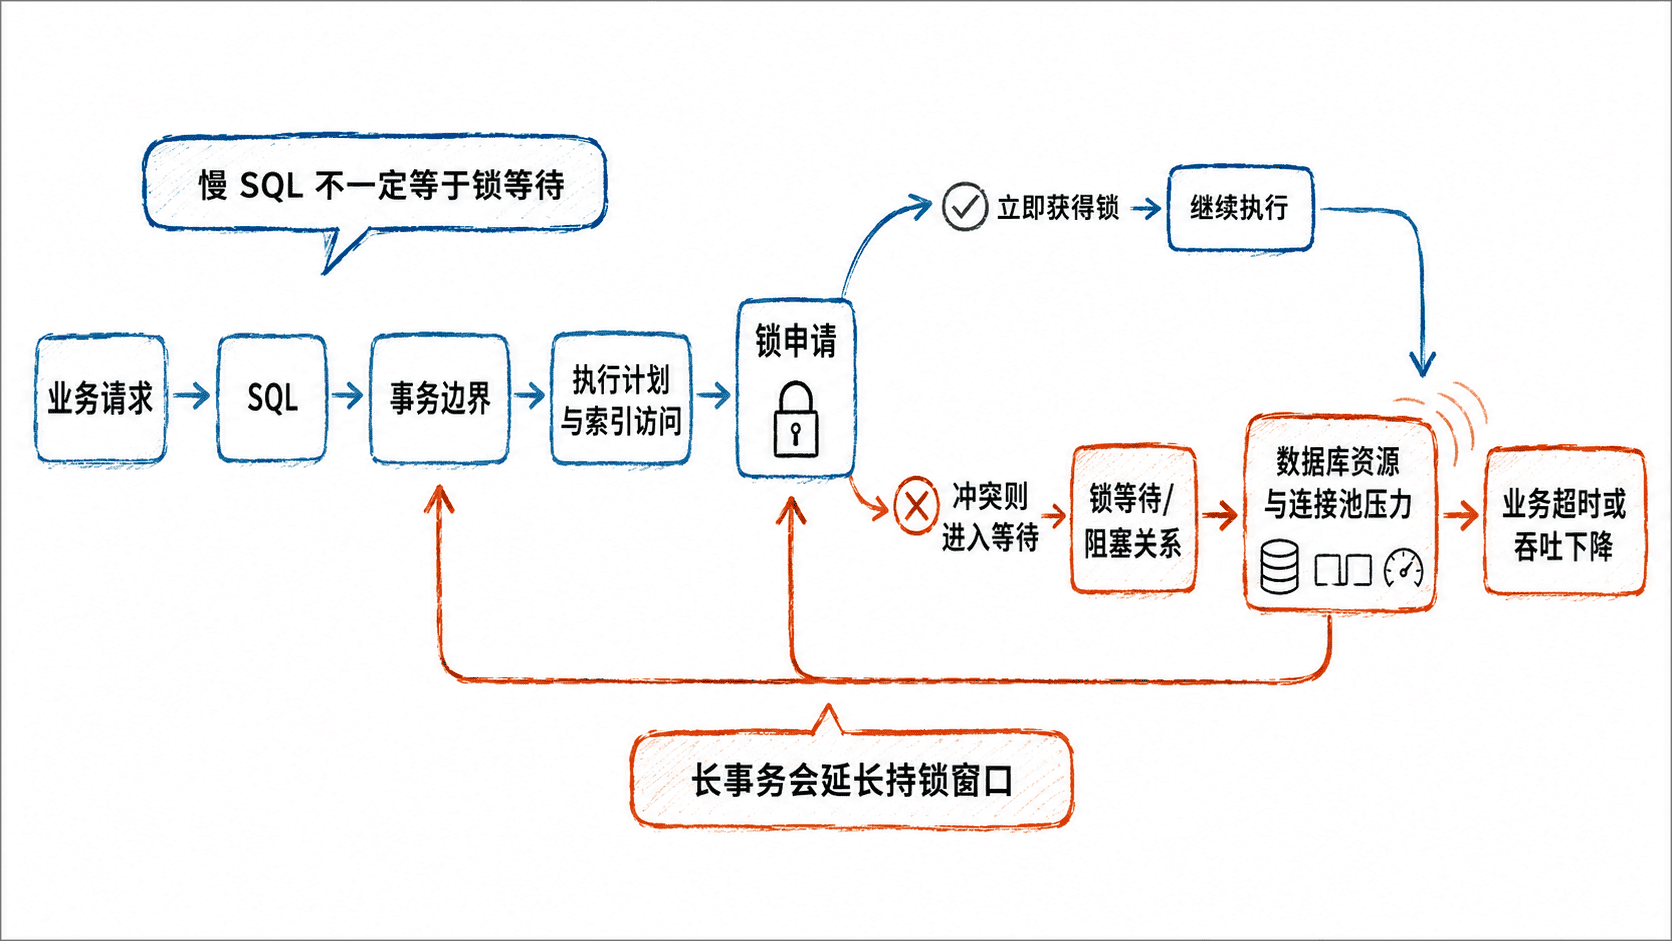
分析时不要从“数据库很慢”直接跳到某个锁类型。真正需要确认的是:哪个请求受影响、执行了哪条 SQL、它属于哪个事务、访问了哪个索引范围、在等待谁,以及等待期间数据库资源是否也已饱和。
并发分析先回答核心问题
一个可复用的排查过程至少要回答下面这些问题:
- 现象是什么:是单个请求超时、某类写入变慢,还是整体吞吐下降。
- 事务边界在哪里:事务何时开始、何时提交,是否存在空闲但未提交的长事务。
- 访问路径是什么:SQL 使用哪个索引,实际扫描和锁定的记录范围有多大。
- 谁在等待谁:等待事务、阻塞事务与竞争对象能否对应起来。
- 等待如何结束:阻塞者提交、锁等待超时,还是 InnoDB 检测到死锁并回滚一个事务。
- 资源是否放大问题:CPU、I/O、连接数或线程拥塞是否让事务执行和持锁时间进一步拉长。
这六个问题把“现象”转换为可以逐层验证的证据,后续调优才不会停留在猜测。
用性能视图确认等待关系
MySQL 8.x 可以从 performance_schema.data_lock_waits 读取锁等待边,再关联 performance_schema.data_locks 查看等待锁和阻塞锁。下面的查询适合先确认当前是否存在 InnoDB 数据锁竞争。
SELECT
    r.ENGINE_TRANSACTION_ID AS waiting_trx_id,
    b.ENGINE_TRANSACTION_ID AS blocking_trx_id,
    r.OBJECT_SCHEMA,
    r.OBJECT_NAME,
    r.INDEX_NAME,
    r.LOCK_TYPE,
    r.LOCK_MODE AS waiting_lock_mode,
    b.LOCK_MODE AS blocking_lock_mode
FROM performance_schema.data_lock_waits AS w
JOIN performance_schema.data_locks AS r
  ON r.ENGINE_LOCK_ID = w.REQUESTING_ENGINE_LOCK_ID
JOIN performance_schema.data_locks AS b
  ON b.ENGINE_LOCK_ID = w.BLOCKING_ENGINE_LOCK_ID;
预期结果
Empty set (<TIME> sec)在没有锁竞争的空闲环境中,查询通常返回空集;实际存在等待时会出现一行或多行,事务 ID、表名、索引名和锁模式以现场值为准。<TIME> 表示执行耗时,实际值可能不同。
区分三类常见并发故障
锁等待、死锁和资源拥塞表现都可能是“请求很慢”,但证据不同。
| 类型 | 关键证据 | 典型结果 |
|---|---|---|
| 锁等待 | 存在明确 waiting → blocking 关系 | 阻塞者提交后继续,或等待超时 |
| 死锁 | 多个事务形成循环依赖 | InnoDB 选择一个事务回滚以打破循环 |
| 资源拥塞 | CPU、I/O、连接或线程饱和,但不一定有锁阻塞链 | SQL 与事务整体变慢,持锁时间被动延长 |
资源拥塞还可能反过来制造更严重的锁问题:事务本来只需几十毫秒完成,但因为 I/O 或连接排队被拉长到数秒,锁自然持有得更久。因此,并发分析既要看锁图,也要看资源时间线。
固定排查顺序
遇到并发故障时,先锁定业务时间窗口和受影响请求,再映射到 SQL 与事务;随后检查执行计划和索引访问范围,确认是否出现锁等待图;最后把等待持续时间与 CPU、I/O、连接数等资源指标对齐。只有这些证据能连成同一时间线,才足以判断真正的根因。
这条链路的价值不在于记住某个性能视图,而在于始终从“业务现象”追到“数据库内部证据”,再把修复点放在最早导致竞争扩大的那一层。