
Go / 系统课时
完成 HTTP 故障演练
完成 HTTP 故障演练
本篇通过一个可复现的 Go 服务注入慢下游、错误超时预算和 goroutine 泄漏。你会从 504 出发,用结构化日志、核心指标、httptrace 与 pprof 建立证据链,再修复上下文和结果通道并验证资源回收。
学习目标
- 能构造慢下游与错误超时预算,复现请求超时和 goroutine 泄漏。
- 能把日志、指标、
httptrace和pprof串成从现象到根因的证据链。 - 能用超时分层、上下文传播和可退出并发验证修复是否真正生效。
先定义故障与判定标准
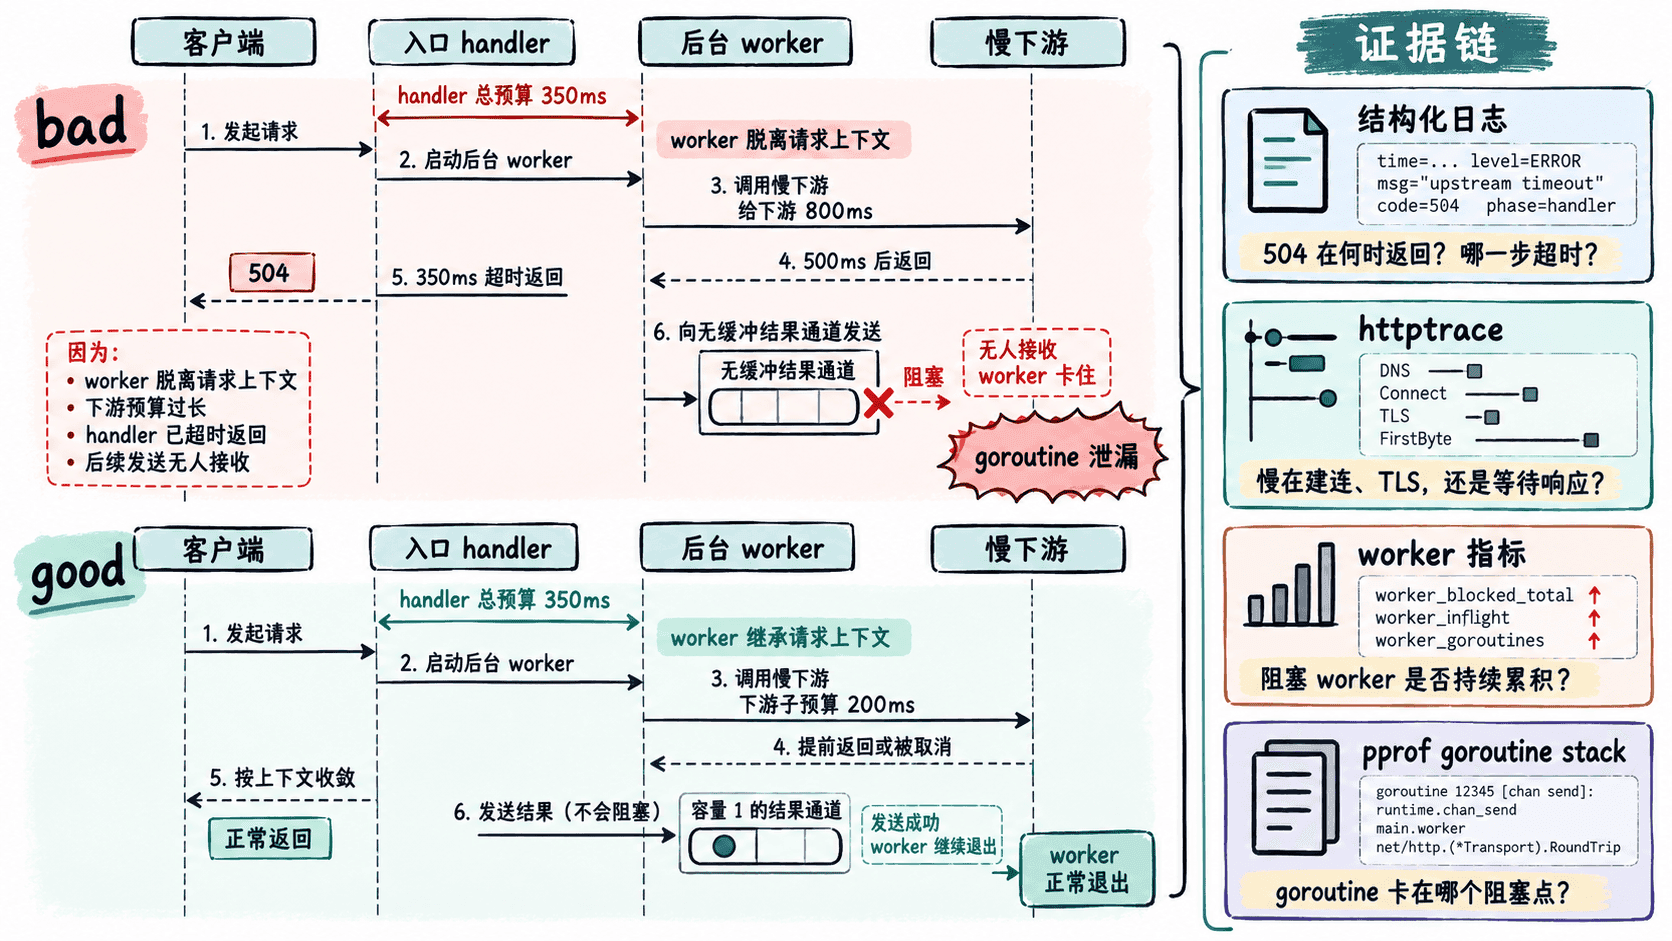
实验把入口请求预算设为 350 ms,下游固定耗时 500 ms。bad 模式故意让后台 worker 脱离请求上下文,并给下游 800 ms 超时;处理器先在 350 ms 返回 504,worker 随后完成请求,却阻塞在无人接收的无缓冲通道发送上,于是每次请求都会多留下一个 goroutine。
good 模式把下游调用绑定到入口上下文,并把子预算收紧到 200 ms,同时把结果通道改为容量 1。这样下游会在入口预算耗尽前被取消,即使处理器提前返回,worker 也能完成发送并退出。修复是否有效不能只看“仍然返回 504”,还要看超时发生位置、worker 指标和 goroutine profile 是否稳定。
搭建可复现实验服务
下面的单文件程序只依赖 Go 标准库。应用端口为 8080,慢下游为 8081,诊断端口为 6060;如果端口冲突,可替换为其他本地端口,并同步修改代码中的地址。
package main

import (
    "context"
    "errors"
    "fmt"
    "io"
    "log"
    "log/slog"
    "net"
    "net/http"
    "net/http/httptrace"
    _ "net/http/pprof"
    "os"
    "runtime"
    "sync/atomic"
    "time"
)

type result struct {
    err error
}

var (
    requestsTotal atomic.Int64
    timeoutsTotal atomic.Int64
    inflight      atomic.Int64
    workers       atomic.Int64
)

func main() {
    slog.SetDefault(slog.New(slog.NewJSONHandler(os.Stdout, nil)))

    downstream := http.NewServeMux()
    downstream.HandleFunc("/slow", func(w http.ResponseWriter, r *http.Request) {
        // 固定 500 ms 的下游耗时,专门用于制造超时。
        select {
        case <-time.After(500 * time.Millisecond):
            _, _ = io.WriteString(w, "ok\n")
        case <-r.Context().Done():
            return
        }
    })

    downLn := mustListen("127.0.0.1:8081")
    adminLn := mustListen("127.0.0.1:6060")
    appLn := mustListen("127.0.0.1:8080")

    go func() {
        slog.Info("downstream listening", "addr", downLn.Addr().String())
        if err := http.Serve(downLn, downstream); err != nil {
            log.Fatal(err)
        }
    }()
    go func() {
        // pprof 只绑定回环地址,避免把诊断端点直接暴露到公网。
        slog.Info("pprof listening", "addr", adminLn.Addr().String())
        if err := http.Serve(adminLn, http.DefaultServeMux); err != nil {
            log.Fatal(err)
        }
    }()

    app := http.NewServeMux()
    app.HandleFunc("/demo", demo)
    app.HandleFunc("/metrics", metrics)

    slog.Info("app listening", "addr", appLn.Addr().String())
    log.Fatal(http.Serve(appLn, app))
}

func demo(w http.ResponseWriter, r *http.Request) {
    requestsTotal.Add(1)
    inflight.Add(1)
    defer inflight.Add(-1)

    mode := r.URL.Query().Get("mode")
    if mode == "" {
        mode = "bad"
    }
    if mode != "bad" && mode != "good" {
        http.Error(w, "mode must be bad or good", http.StatusBadRequest)
        return
    }

    start := time.Now()
    requestCtx, cancel := context.WithTimeout(r.Context(), 350*time.Millisecond)
    defer cancel()

    resultCh := make(chan result)
    if mode == "good" {
        // 容量 1 允许 worker 在 handler 已返回时也能完成发送并退出。
        resultCh = make(chan result, 1)
    }

    workers.Add(1)
    go func() {
        defer workers.Add(-1)

        workerCtx := context.Background()
        childBudget := 800 * time.Millisecond
        if mode == "good" {
            // 修复点:传播请求上下文,并给下游留下更短的子预算。
            workerCtx = requestCtx
            childBudget = 200 * time.Millisecond
        }
        childCtx, childCancel := context.WithTimeout(workerCtx, childBudget)
        defer childCancel()

        req, err := http.NewRequestWithContext(
            childCtx,
            http.MethodGet,
            "http://127.0.0.1:8081/slow",
            nil,
        )
        if err != nil {
            resultCh <- result{err: err}
            return
        }

        traceStart := time.Now()
        trace := &httptrace.ClientTrace{
            GotConn: func(httptrace.GotConnInfo) {
                slog.Info("httptrace",
                    "mode", mode,
                    "event", "got_conn",
                    "elapsed_ms", time.Since(traceStart).Milliseconds())
            },
            GotFirstResponseByte: func() {
                slog.Info("httptrace",
                    "mode", mode,
                    "event", "got_first_response_byte",
                    "elapsed_ms", time.Since(traceStart).Milliseconds())
            },
        }
        req = req.WithContext(httptrace.WithClientTrace(req.Context(), trace))

        resp, err := http.DefaultClient.Do(req)
        if err == nil {
            _, _ = io.Copy(io.Discard, resp.Body)
            _ = resp.Body.Close()
        }

        // bad 模式下 handler 已经超时退出,这个无缓冲发送会永久阻塞。
        resultCh <- result{err: err}
    }()

    select {
    case res := <-resultCh:
        elapsed := time.Since(start).Milliseconds()
        if res.err != nil {
            if errors.Is(res.err, context.DeadlineExceeded) {
                timeoutsTotal.Add(1)
                slog.Warn("downstream timeout",
                    "mode", mode, "elapsed_ms", elapsed, "err", res.err)
                http.Error(w, "downstream timeout", http.StatusGatewayTimeout)
                return
            }
            slog.Error("downstream error",
                "mode", mode, "elapsed_ms", elapsed, "err", res.err)
            http.Error(w, "bad gateway", http.StatusBadGateway)
            return
        }

        slog.Info("request complete", "mode", mode, "elapsed_ms", elapsed)
        _, _ = io.WriteString(w, "ok\n")

    case <-requestCtx.Done():
        timeoutsTotal.Add(1)
        slog.Warn("handler timeout",
            "mode", mode,
            "elapsed_ms", time.Since(start).Milliseconds(),
            "err", requestCtx.Err())
        http.Error(w, "handler timeout", http.StatusGatewayTimeout)
    }
}

func metrics(w http.ResponseWriter, _ *http.Request) {
    w.Header().Set("Content-Type", "text/plain; version=0.0.4")
    _, _ = fmt.Fprintf(w,
        "http_requests_total %d\nhttp_timeouts_total %d\nhttp_inflight %d\nhttp_workers %d\ngo_goroutines %d\n",
        requestsTotal.Load(),
        timeoutsTotal.Load(),
        inflight.Load(),
        workers.Load(),
        runtime.NumGoroutine(),
    )
}

func mustListen(addr string) net.Listener {
    ln, err := net.Listen("tcp", addr)
    if err != nil {
        log.Fatal(err)
    }
    return ln
}
预期结果:保存为 main.go 后应能直接编译运行;bad 与 good 共用同一条请求链,只在上下文、子超时和结果通道三个位置存在故障版与修复版差异。
启动服务:
go run main.go预期输出:
{"time":"<TIME>","level":"INFO","msg":"downstream listening","addr":"127.0.0.1:8081"}
{"time":"<TIME>","level":"INFO","msg":"pprof listening","addr":"127.0.0.1:6060"}
{"time":"<TIME>","level":"INFO","msg":"app listening","addr":"127.0.0.1:8080"}三条启动日志的先后顺序可能不同,<TIME> 也会随实际运行时间变化。
建立故障证据链
先连续发送 10 个 bad 请求,再读取核心指标和 goroutine profile。这里故意串行请求,便于观察每次故障如何增加一个无法退出的 worker。
for i in {1..10}; do
  curl -s -o /dev/null -w '%{http_code}\n' 'http://127.0.0.1:8080/demo?mode=bad'
done
sleep 1
curl -s 'http://127.0.0.1:8080/metrics'
curl -s 'http://127.0.0.1:6060/debug/pprof/goroutine?debug=2' | grep -E 'chan send|main\.demo'
预期输出:
504
504
504
504
504
504
504
504
504
504
http_requests_total 10
http_timeouts_total 10
http_inflight 0
http_workers 10
go_goroutines <N>
goroutine <ID> [chan send]:
main.demo.func1()
...<N>、<ID> 和重复栈行会因运行环境不同而变化。此时证据链是闭合的:客户端只告诉你“504”;结构化日志会出现约 350 ms 的 handler timeout;httptrace 还能在稍后记录 bad 请求约 500 ms 才收到首字节;http_workers 从 0 累积到 10;最后 pprof 把增长直接定位到 main.demo.func1 的 chan send。这比单看超时日志更能证明“请求已经结束,但后台 goroutine 仍活着”。
验证修复是否真正生效
不重启进程,继续发送 10 个 good 请求。已有的 10 个坏 worker 不会自动消失,所以验证重点不是指标回到 0,而是它不再从 10 增长到 20。
for i in {1..10}; do
  curl -s -o /dev/null -w '%{http_code}\n' 'http://127.0.0.1:8080/demo?mode=good'
done
sleep 1
curl -s 'http://127.0.0.1:8080/metrics'
预期输出:
504
504
504
504
504
504
504
504
504
504
http_requests_total 20
http_timeouts_total 20
http_inflight 0
http_workers 10
go_goroutines <N>
good 仍返回 504 是预期行为,因为 500 ms 的下游本来就超过 200 ms 子预算;不同之处是日志会从约 350 ms 的 handler timeout 变成约 200 ms 的 downstream timeout,worker 在发送结果后正常退出,http_workers 不再增长。重启进程并只压测 good 模式时,该指标应在请求结束后回到 0。
把演练方法带回生产
生产排障时,先固定“症状、时间点、请求范围”再采证据。HTTP 状态码和延迟分位数用于确认影响面;结构化日志确认哪个超时层先触发;httptrace 判断时间消耗在连接、等待首字节还是响应读取;goroutine 指标发现持续增长;最后用 pprof 栈把增长归到具体阻塞点。不要一开始就只抓 profile,也不要只凭单条日志推断泄漏。
超时预算应从外向内递减,并预留排队、序列化和返回响应的时间;后台任务如果属于请求生命周期,就必须传播 r.Context()。只有真正需要脱离请求的异步任务才应使用独立上下文,并且还要有明确的停止条件、队列上限和生命周期管理。pprof 与诊断指标应放在受控的管理端口或内部网络,不应直接暴露到公网。
这次演练的验收标准不是“修复后没有任何错误”,而是故障被更早、更准确地终止,资源能回收,并且日志、指标、trace 与 profile 对同一个根因给出一致证据。