
Go / 系统课时
实现有边界的重试
实现有边界的重试
调用下游 HTTP 服务时,重试必须有明确边界:只重试可安全重复的方法和瞬时故障,限制尝试次数,并让退避等待与每次请求共同受同一个总体 deadline 约束。这样才能提升短暂故障下的成功率,同时避免把下游故障放大成重试风暴。
学习目标
- 判断哪些 HTTP 方法、网络错误和状态码适合重试
- 实现有限次数、指数退避与随机抖动,并受总体 deadline 约束
- 正确处理失败响应体,避免重试破坏连接复用或业务幂等性
先确定什么可以重试
重试首先看操作是否允许重复执行。GET、HEAD 等读取请求通常可以直接重试;PUT、DELETE 在 HTTP 语义上具备幂等性,但仍要确认请求体可重放、服务端实现没有额外副作用。POST、PATCH 默认不应自动重试,除非业务已经使用幂等键等机制保证重复请求只生效一次。
错误类别也要收窄。连接临时失败、请求超时,以及 408、429、502、503、504 这类可能恢复的响应可以进入重试判断;认证失败、参数错误等大多数 4xx 不会因为再发一次就变好。对于 429 或 503,生产客户端还应在允许的总体时间内优先考虑服务端返回的 Retry-After。
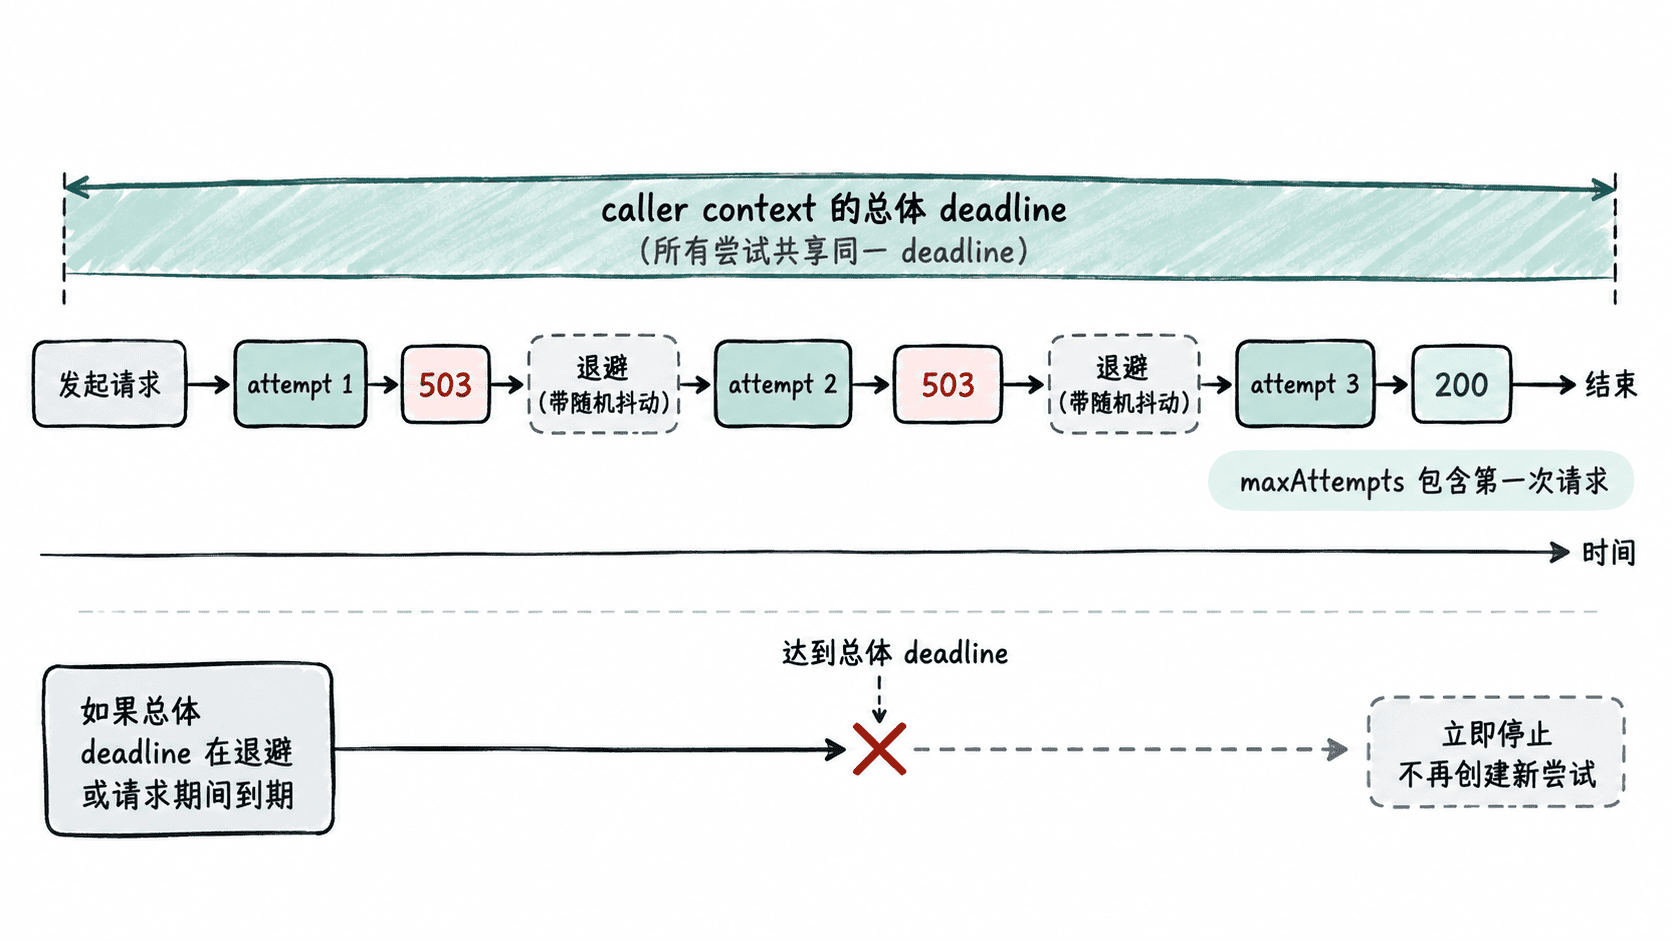
用同一个 deadline 包住所有尝试
下面的完整示例用本地测试服务器模拟前两次返回 503、第三次成功。客户端最多尝试 4 次,采用带随机抖动的指数退避;每次重新创建请求,但始终绑定同一个 context.Context,因此总体 2 秒一到,正在进行的请求或下一次退避都会被取消。
package main

import (
	"context"
	"errors"
	"fmt"
	"io"
	"math/rand"
	"net/http"
	"net/http/httptest"
	"sync/atomic"
	"time"
)

func retryableStatus(code int) bool {
	switch code {
	case http.StatusRequestTimeout,
		http.StatusTooManyRequests,
		http.StatusBadGateway,
		http.StatusServiceUnavailable,
		http.StatusGatewayTimeout:
		return true
	default:
		return false
	}
}

func retryDelay(attempt int) time.Duration {
	base := 100 * time.Millisecond << (attempt - 1)
	if base > 800*time.Millisecond {
		base = 800 * time.Millisecond
	}
	// Full jitter:把同一时刻失败的大量客户端打散。
	return time.Duration(rand.Int63n(int64(base) + 1))
}

func getWithRetry(
	ctx context.Context,
	client *http.Client,
	url string,
	maxAttempts int,
) (*http.Response, error) {
	if maxAttempts < 1 {
		return nil, fmt.Errorf("maxAttempts must be at least 1")
	}

	var lastErr error
	for attempt := 1; attempt <= maxAttempts; attempt++ {
		req, err := http.NewRequestWithContext(ctx, http.MethodGet, url, nil)
		if err != nil {
			return nil, err
		}

		resp, err := client.Do(req)
		if err == nil && !retryableStatus(resp.StatusCode) {
			return resp, nil
		}

		if err != nil {
			if errors.Is(err, context.Canceled) ||
				errors.Is(err, context.DeadlineExceeded) {
				return nil, err
			}
			lastErr = err
		} else {
			// 重试前读完并关闭响应体,便于 Transport 复用连接。
			_, _ = io.Copy(io.Discard, resp.Body)
			_ = resp.Body.Close()
			lastErr = fmt.Errorf("retryable status: %s", resp.Status)
		}

		if attempt == maxAttempts {
			return nil, lastErr
		}

		timer := time.NewTimer(retryDelay(attempt))
		select {
		case <-ctx.Done():
			timer.Stop()
			return nil, ctx.Err()
		case <-timer.C:
		}
	}

	return nil, lastErr
}

func main() {
	var attempts atomic.Int32

	upstream := httptest.NewServer(http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
		n := attempts.Add(1)
		if n < 3 {
			http.Error(w, "temporary", http.StatusServiceUnavailable)
			return
		}
		_, _ = fmt.Fprint(w, "ok")
	}))
	defer upstream.Close()

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Second)
	defer cancel()

	resp, err := getWithRetry(ctx, upstream.Client(), upstream.URL, 4)
	if err != nil {
		panic(err)
	}
	defer resp.Body.Close()

	body, err := io.ReadAll(resp.Body)
	if err != nil {
		panic(err)
	}

	fmt.Printf("status=%d body=%s attempts=%d\n",
		resp.StatusCode, body, attempts.Load())
}
预期输出:
status=200 body=ok attempts=3随机抖动只影响等待时长,因此输出中的尝试次数仍是 3。若下游持续失败并耗尽 4 次机会,函数返回最后一个可重试错误;若 2 秒总体 deadline 先到,则直接返回 context deadline exceeded,不会为了“凑满次数”继续请求。
避免把重试变成故障放大器
maxAttempts 应理解为总尝试次数而不是“额外重试次数”,否则不同代码很容易出现一次偏差。退避应设置上限并加入抖动,防止大量实例同时收到故障后按完全相同的节奏再次冲击下游。
还要给整个调用链留预算。例如入口请求只剩 800 毫秒时,下游重试就不能再配置 3 秒的独立超时。所有尝试共享调用方 context,能保证重试不会越过上层已经确定的截止时间。
对于带请求体的方法,只有在请求体可以重新构造或通过 Request.GetBody 重放时才具备自动重试的技术条件;是否真的允许重复执行,还取决于业务幂等性。把“可重放”和“可重复生效”同时满足,才是安全重试的边界。