
Go / 系统课时
限制请求与响应资源
限制请求与响应资源
HTTP 请求能进入 handler,并不代表资源消耗就是可控的。请求头、请求体、解码后的业务对象和响应生成各有独立边界。本节用一个可运行服务同时约束这些层次,并验证超限请求会在正确位置被拒绝。
学习目标
- 使用
MaxHeaderBytes与http.MaxBytesReader分别约束请求头和请求体 - 在 JSON 解码后继续限制集合数量与字段长度,避免业务对象放大
- 让响应规模由业务上限、分页或流式传输控制,而不是依赖无界缓冲
为每一层设置独立上限
http.Server.MaxHeaderBytes 控制服务端解析请求头时的大小预算,不限制请求体;http.MaxBytesReader 则包裹 r.Body,读取超过上限时会产生 *http.MaxBytesError。ReadHeaderTimeout 只限制读取请求头所花的时间,也不能替代字节上限。
即使请求体很小,解码后的对象仍可能违反业务规则,例如项目过多或单个字符串过长。因此还要在解码后检查集合数量和字段长度;响应侧则应由业务规则决定最大结果集,或直接采用流式传输。
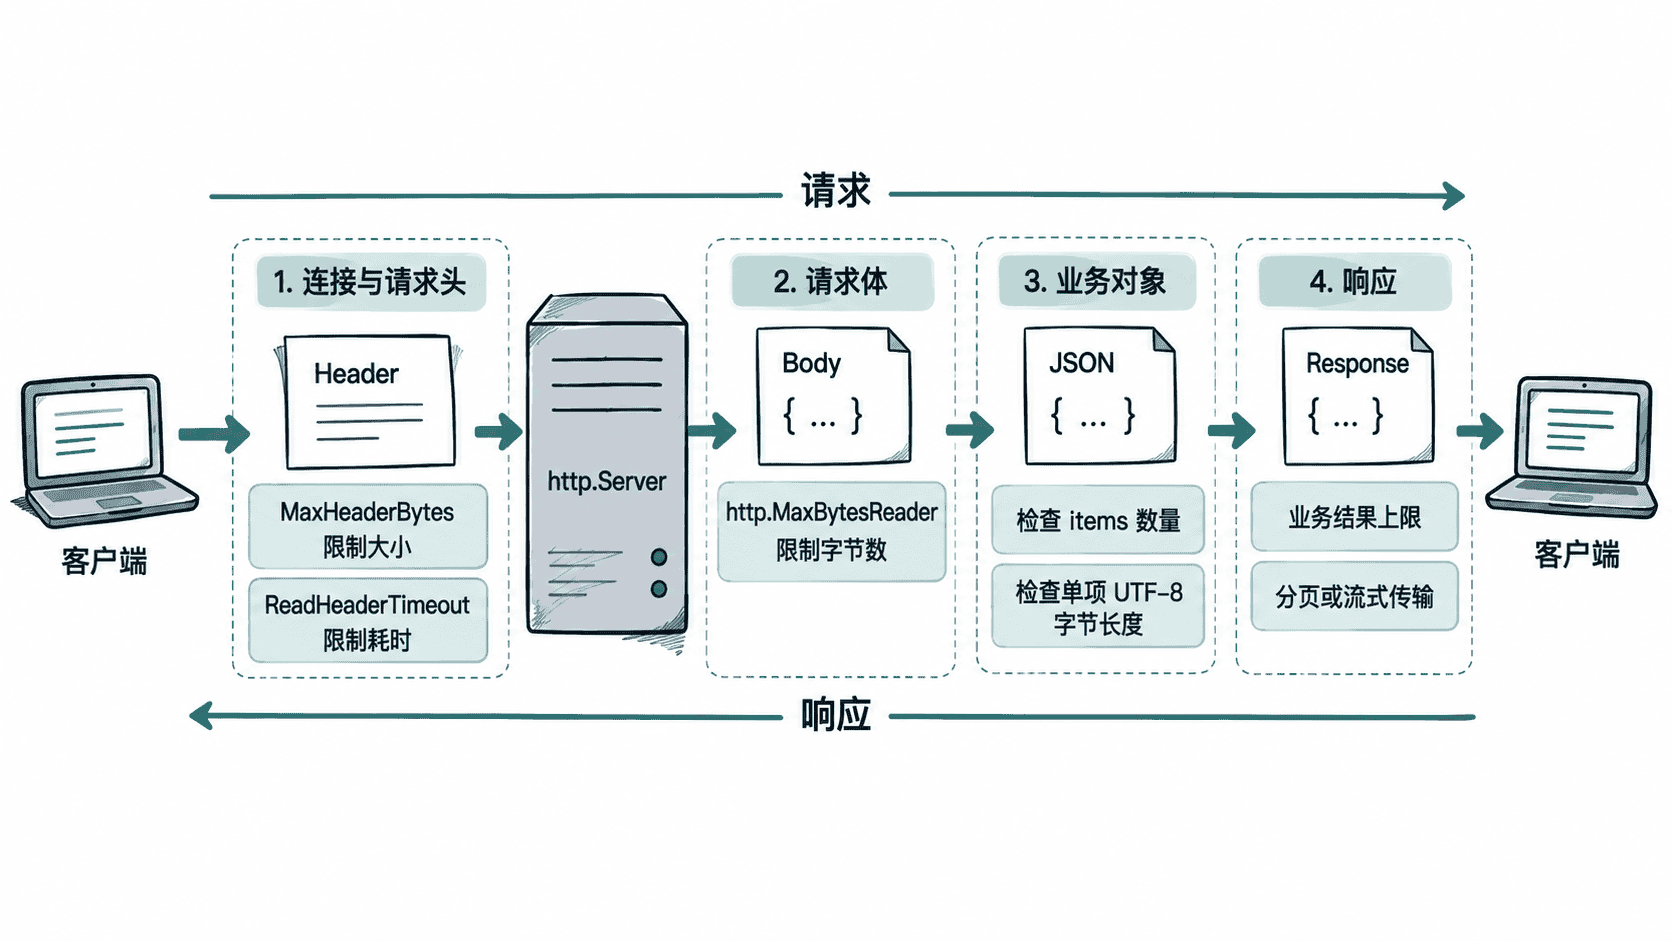
用一个服务限制 Header、Body 与业务对象
下面的服务把 MaxHeaderBytes 设为 8 KiB,把请求体限制为 1 KiB,并规定 items 最多 3 项、每项最多 16 个 UTF-8 字节。响应只编码已经通过校验的数据,因此结果规模也有确定上界。
package main

import (
    "encoding/json"
    "errors"
    "fmt"
    "io"
    "log"
    "net/http"
    "time"
)

const (
    maxBodyBytes int64 = 1024
    maxItems           = 3
    maxItemBytes       = 16
)

type request struct {
    Items []string `json:"items"`
}

type response struct {
    Items []string `json:"items"`
}

func decodeRequest(body io.Reader, dst any) error {
    decoder := json.NewDecoder(body)
    decoder.DisallowUnknownFields()

    if err := decoder.Decode(dst); err != nil {
        return err
    }
    // 只允许一个顶层 JSON 值,防止合法对象后再追加第二个值。
    if err := decoder.Decode(new(any)); err != io.EOF {
        return errors.New("request must contain exactly one JSON value")
    }
    return nil
}

func itemsHandler(w http.ResponseWriter, r *http.Request) {
    if r.Method != http.MethodPost {
        http.Error(w, "method not allowed", http.StatusMethodNotAllowed)
        return
    }

    // Body 上限独立于 Server 的 Header 上限。
    r.Body = http.MaxBytesReader(w, r.Body, maxBodyBytes)
    defer r.Body.Close()

    var req request
    if err := decodeRequest(r.Body, &req); err != nil {
        var limitErr *http.MaxBytesError
        switch {
        case errors.As(err, &limitErr):
            http.Error(w, "request body too large", http.StatusRequestEntityTooLarge)
        default:
            http.Error(w, "invalid json", http.StatusBadRequest)
        }
        return
    }

    if len(req.Items) > maxItems {
        http.Error(w, "too many items", http.StatusUnprocessableEntity)
        return
    }
    for _, item := range req.Items {
        if len([]byte(item)) > maxItemBytes {
            http.Error(w, "item too long", http.StatusUnprocessableEntity)
            return
        }
    }

    w.Header().Set("Content-Type", "application/json; charset=utf-8")
    if err := json.NewEncoder(w).Encode(response{Items: req.Items}); err != nil {
        log.Printf("encode response: %v", err)
    }
}

func main() {
    router := http.NewServeMux()
    router.HandleFunc("/items", itemsHandler)

    server := &http.Server{
        Addr:              ":8080",
        Handler:           router,
        MaxHeaderBytes:    8 << 10,
        ReadHeaderTimeout: 5 * time.Second,
    }

    fmt.Println("listening on :8080")
    log.Fatal(server.ListenAndServe())
}
预期输出
listening on :8080服务端没有先用 io.ReadAll 把整个 Body 聚合进内存,而是让 JSON 解码器直接从受限读取器消费数据。若本机 8080 端口已被占用,需要同步修改 Addr 和后续验证命令中的端口。
验证各层限制
启动服务后,用同一个脚本依次验证合法请求、两类业务对象超限、请求体超限和请求头超限。Header 测试故意发送远大于 8 KiB 的值,避免把测试建立在实现缓冲和报文开销附近的临界点上。
curl -sS -o - -w '\nstatus=%{http_code}\n' \
  -X POST http://localhost:8080/items \
  -H 'Content-Type: application/json' \
  -d '{"items":["go","http"]}'

curl -sS -o - -w '\nstatus=%{http_code}\n' \
  -X POST http://localhost:8080/items \
  -H 'Content-Type: application/json' \
  -d '{"items":["a","b","c","d"]}'

curl -sS -o - -w '\nstatus=%{http_code}\n' \
  -X POST http://localhost:8080/items \
  -H 'Content-Type: application/json' \
  -d '{"items":["12345678901234567"]}'

payload=$(printf 'x%.0s' {1..1100})
curl -sS -o - -w '\nstatus=%{http_code}\n' \
  -X POST http://localhost:8080/items \
  -H 'Content-Type: application/json' \
  -d "{\"items\":[\"$payload\"]}"

big_header=$(printf 'h%.0s' {1..20000})
curl -sS -o - -w '\nstatus=%{http_code}\n' \
  -X POST http://localhost:8080/items \
  -H "X-Fill: $big_header" \
  -H 'Content-Type: application/json' \
  -d '{"items":["go"]}'
预期结果
{"items":["go","http"]}

status=200
too many items

status=422
item too long

status=422
request body too large

status=413
431 Request Header Fields Too Large
status=431
前三类限制发生在 handler 内;过大的 Header 会在 http.Server 解析阶段被拒绝,通常根本不会进入 handler。临界值附近的可接受大小会受到请求行和实现缓冲等因素影响,因此自动化测试应使用明显超限的 Header,而不是构造恰好等于 8 KiB 的报文。
响应侧避免无界聚合
net/http 没有替所有 handler 自动限制最大响应 Body 的通用字段。列表接口应限制最大页大小,导出接口应限制可导出的记录数,代理与文件接口则优先流式转发,避免先把全部上游内容读入 []byte。
结构化 JSON 不应在任意字节位置硬截断,否则会产生无效 JSON。应在编码前限制集合数量、字段长度和聚合规模;二进制或文件流只有在协议允许截断或已知长度时,才适合使用 io.LimitReader、io.CopyN 等流式手段。
请求头、请求体、解码后的对象和响应生成必须分别设限。这样才能让单个请求的内存、CPU 与输出规模都保持在可预期范围内。