
Go / 系统课时
建立核心 HTTP 指标
建立核心 HTTP 指标
HTTP 指标的关键不是“多采”,而是用稳定、低基数的维度回答流量、错误和延迟问题。本节用 Go HTTP 中间件建立按路由模板、方法与状态类别聚合的计数器和直方图,并说明如何从直方图计算高分位延迟,同时避免标签基数失控。
学习目标
- 为请求量与请求延迟设计低基数标签,并区分路由模板与原始 URL。
- 用直方图记录延迟分布,理解 p95、p99 等高分位值的聚合方式。
- 识别用户 ID、查询参数、Trace ID 等不应进入常规指标标签的高基数字段。
先定义能回答问题的指标
一组最小但实用的 HTTP 服务指标通常包括请求总数和请求耗时。请求总数适合用 Counter,延迟分布适合用 Histogram。两者都可以使用 method、route、status_class 标签,例如 GET、/users/{id}、2xx。
这里刻意使用路由模板而不是 r.URL.Path。访问 /users/123 与 /users/456 时,原始路径不同,但它们属于同一个业务端点;若直接把路径作为标签,用户数量增长会直接放大时间序列数量。状态也优先聚合为 2xx、4xx、5xx,只有确实需要逐状态码分析时才增加更细指标。
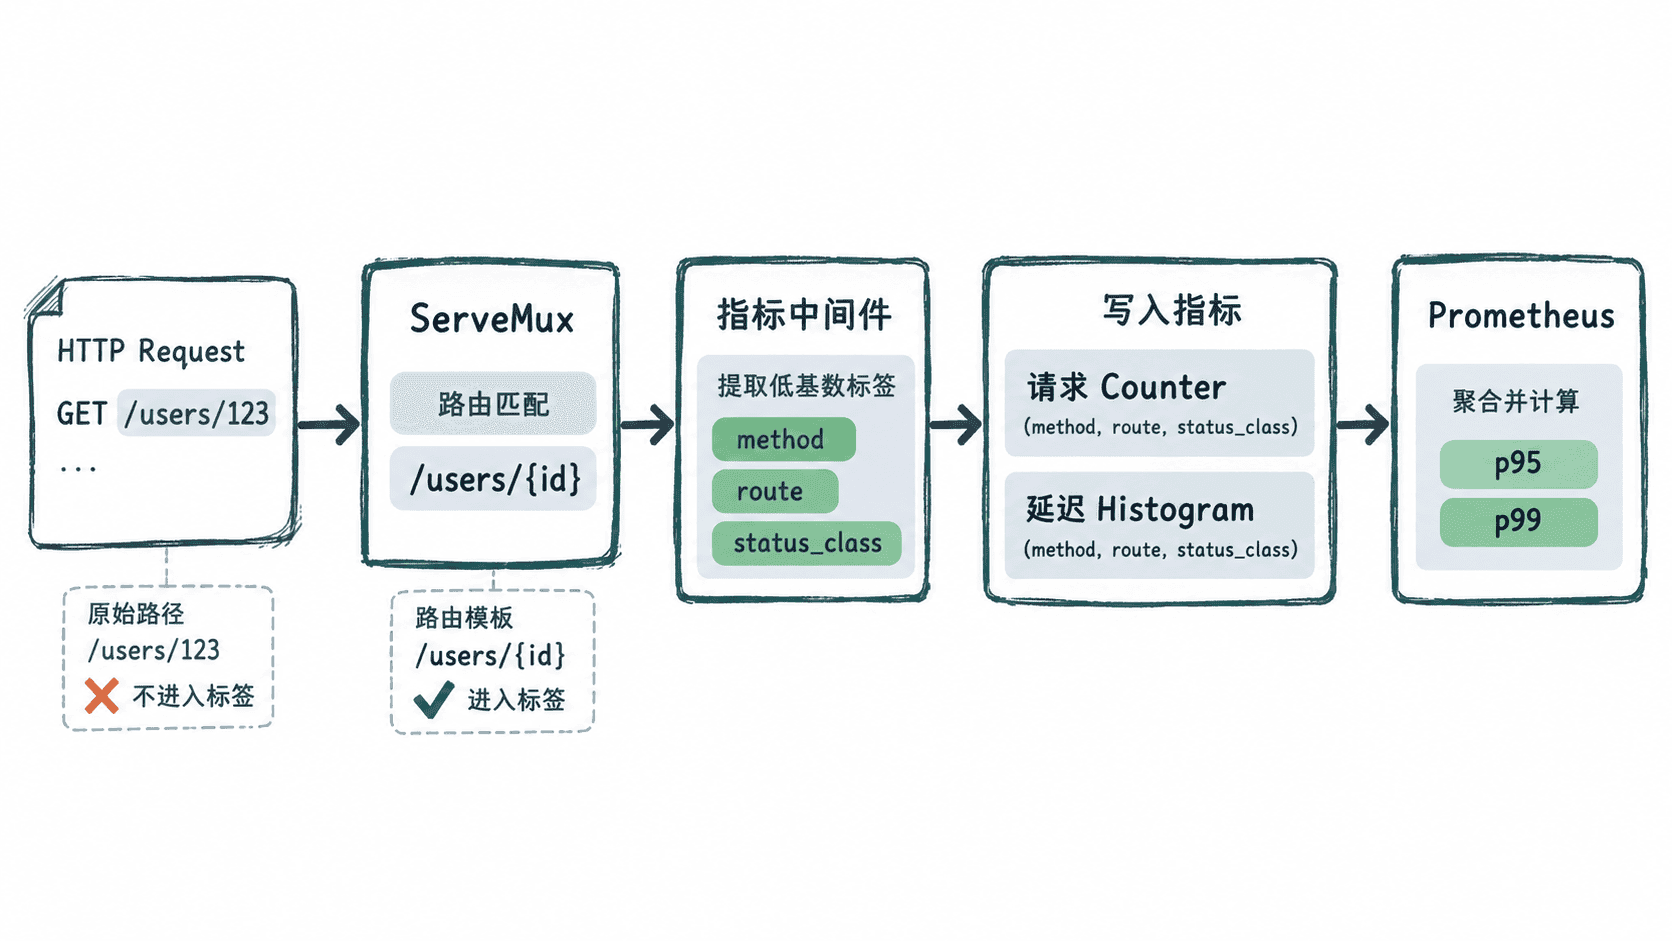
用中间件记录请求量与延迟
下面示例要求 Go 1.22 或更高版本,因为它使用 http.Request.Pattern 获取 ServeMux 已匹配的路由模板。中间件在处理结束后读取模板,这样既能拿到最终状态码,也不会把路径参数值放入标签。
package main

import (
    "fmt"
    "log"
    "net/http"
    "time"

    "github.com/prometheus/client_golang/prometheus"
    "github.com/prometheus/client_golang/prometheus/promhttp"
)

var (
    requests = prometheus.NewCounterVec(
        prometheus.CounterOpts{
            Name: "http_server_requests_total",
            Help: "Total number of HTTP requests.",
        },
        []string{"method", "route", "status_class"},
    )
    duration = prometheus.NewHistogramVec(
        prometheus.HistogramOpts{
            Name:    "http_server_request_duration_seconds",
            Help:    "HTTP request latency in seconds.",
            Buckets: prometheus.ExponentialBuckets(0.005, 2, 10),
        },
        []string{"method", "route", "status_class"},
    )
)

type statusRecorder struct {
    http.ResponseWriter
    status int
    wrote  bool
}

func (w *statusRecorder) WriteHeader(code int) {
    if w.wrote {
        return
    }
    w.status = code
    w.wrote = true
    w.ResponseWriter.WriteHeader(code)
}

func (w *statusRecorder) Write(p []byte) (int, error) {
    if !w.wrote {
        w.WriteHeader(http.StatusOK)
    }
    return w.ResponseWriter.Write(p)
}

func metricsMiddleware(next http.Handler) http.Handler {
    return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
        start := time.Now()
        rec := &statusRecorder{ResponseWriter: w, status: http.StatusOK}

        next.ServeHTTP(rec, r)

        route := r.Pattern
        if route == "" {
            route = "unmatched"
        }
        statusClass := fmt.Sprintf("%dxx", rec.status/100)

        requests.WithLabelValues(r.Method, route, statusClass).Inc()
        duration.WithLabelValues(r.Method, route, statusClass).
            Observe(time.Since(start).Seconds())
    })
}

func main() {
    prometheus.MustRegister(requests, duration)

    mux := http.NewServeMux()
    mux.HandleFunc("/users/{id}", func(w http.ResponseWriter, r *http.Request) {
        if r.Method != http.MethodGet {
            http.Error(w, "method not allowed", http.StatusMethodNotAllowed)
            return
        }
        fmt.Fprintf(w, "user=%s\n", r.PathValue("id"))
    })
    mux.Handle("/metrics", promhttp.Handler())

    log.Println("listening on :8080")
    log.Fatal(http.ListenAndServe(":8080", metricsMiddleware(mux)))
}
预期输出
<TIME> listening on :8080实际日志时间会不同。把示例保存为 main.go 后初始化模块、解析依赖并启动服务:
go mod init example.com/httpmetrics
go mod tidy
go run .
预期输出
go: creating new go.mod: module example.com/httpmetrics
<DEPENDENCY_DOWNLOAD_LOG>
<TIME> listening on :8080
依赖下载日志与实际版本会因本地模块缓存和解析结果而不同。服务保持运行时,在另一个终端执行:
curl -s http://localhost:8080/users/123 >/dev/null
curl -s http://localhost:8080/users/456 >/dev/null
curl -s http://localhost:8080/metrics | grep '^http_server_requests_total'
预期输出
http_server_requests_total{method="GET",route="/users/{id}",status_class="2xx"} 2两个不同 ID 最终落入同一条时间序列,这正是路由模板控制基数的效果。若这里出现 /users/123、/users/456 两个标签值,就说明采集层错误地使用了原始路径。
这个 statusRecorder 为了突出指标逻辑,只处理普通写响应场景。若服务依赖流式刷新、WebSocket 或其他可选 ResponseWriter 接口,生产实现还应保持 http.Flusher、http.Hijacker 等能力,避免观测中间件改变业务行为。
从直方图读取高分位延迟
Histogram 会把每次耗时累加到一组桶中,并额外维护总次数与总耗时。Prometheus 可以先跨实例汇总桶,再用 histogram_quantile 估算 p95、p99;例如按路由和方法计算 5 分钟窗口 p95,可使用表达式 histogram_quantile(0.95, sum by (le, route, method) (rate(http_server_request_duration_seconds_bucket[5m])))。
高分位不是“最慢请求”,而是分布位置。p95 为 200 ms 表示约 95% 的请求不超过 200 ms。桶边界会影响估算精度,因此应围绕实际 SLO 设计,例如重点关注 50 ms、100 ms、250 ms、500 ms、1 s 附近,而不是机械复制默认桶。
与客户端计算分位值的 Summary 相比,Histogram 更适合多实例服务,因为桶计数可以先聚合再求分位。若服务实例很多、需要全局 p95,这一点尤其重要。
把高基数信息留给日志和追踪
user_id、订单号、完整 URL、查询参数、Trace ID、请求体字段通常都不适合作为常规指标标签。它们的取值可能接近请求数,会造成时间序列爆炸、内存占用上升和查询变慢。
上线前可以用一个简单标准检查每个标签:它的可能取值是否有明确上界,新增业务对象是否会持续创造新标签值。只要答案是“会”,就应重新设计标签或改用日志、追踪承载明细。