
游戏客户端架构 / 系统课时
看懂一次缓存友好的遍历
看懂一次缓存友好的遍历
让大量实体每帧更新位置时,真正拖慢循环的未必是加法,而可能是跨内存跳转、把无关字段读进缓存,以及反复判断组件是否存在。本课从 MovementSystem 的访问路径出发,用连续列的可运行示例辨认这些成本。
学习目标
- 找出位置更新真正需要读取和写入的组件列。
- 解释连续访问、剔除无关数据与减少分支的作用。
- 用可运行示例验证查询筛选和批量更新结果。
从系统行为反推数据需求
假设本帧只要做一维运动更新:新位置等于旧位置加上速度乘以帧间隔。MovementSystem 只需要读取 Position.x、Velocity.vx,并写回 Position.x;Health、Inventory 等状态无需参与。
如果每个对象在堆中各占一块,循环可能先读取对象引用、再跳到对象内找字段。即使字段放在同一大结构中,缓存行也可能顺带载入本系统不用的数据。这类访问在对象数量增大时会增加缓存未命中或浪费带宽的风险。
SoA 布局将同类字段放在连续缓冲区中。按行依次读写 x[i] 和 vx[i],有利于缓存行利用、预取以及底层原生代码的向量化;它并不保证每个场景都快,关键是布局应匹配系统实际访问的字段。
看清两种访问路径
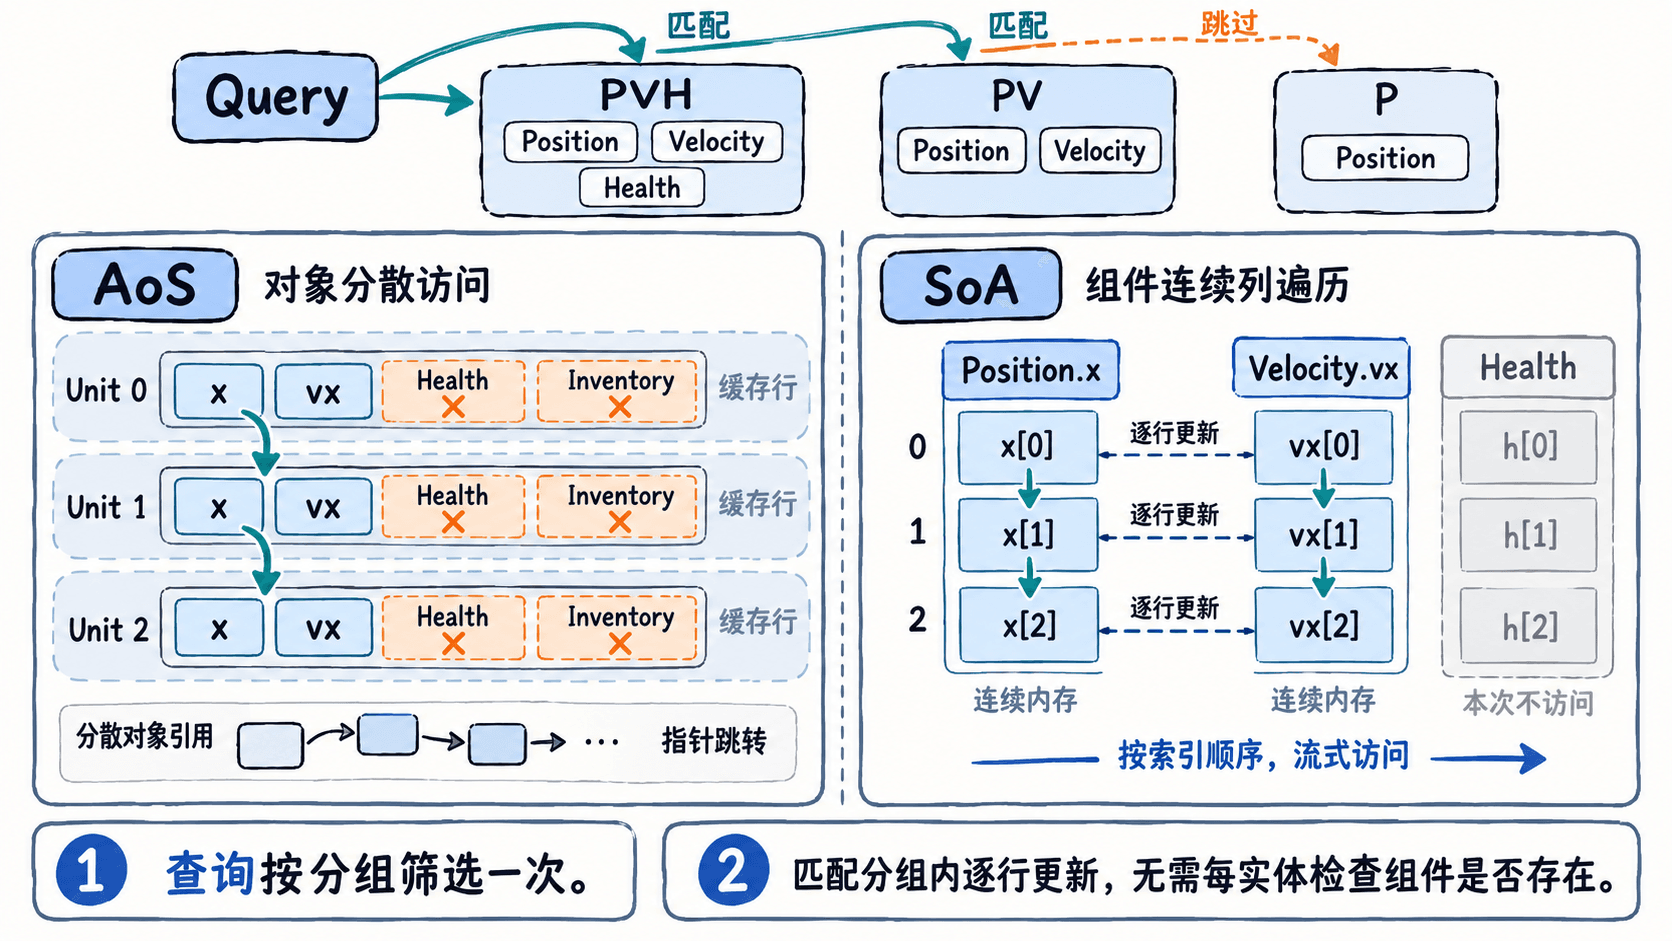
在 Archetype ECS 中,查询可以先选出含有 Position 和 Velocity 的分组,再进入各分组的紧凑循环。这样,“是否有 Velocity”不必在每个实体上重复判断;只有 Position 的实体会在进入循环前被排除。不过,碰撞、状态切换等业务条件仍可能需要分支,不能把“少分支”理解成“完全没有分支”。
运行一个按分组筛选的更新
下例用 Python 标准库 array('f') 保存连续的单精度浮点列。三个分组分别是 PVH、P 和 PV;更新时会命中两个分组,并且不读取 Health 列。
from array import array

groups = [
    {"name": "PVH", "types": {"Position", "Velocity", "Health"},
     "x": array("f", [0.0, 10.0]), "vx": array("f", [1.0, 0.0]),
     "hp": array("i", [100, 80])},
    {"name": "P", "types": {"Position"},
     "x": array("f", [30.0])},
    {"name": "PV", "types": {"Position", "Velocity"},
     "x": array("f", [20.0]), "vx": array("f", [-2.0])},
]
required = {"Position", "Velocity"}
updated = 0
dt = 0.5

for group in groups:
    # 按组件组合判断一次,而非在实体内反复检查
    if not required.issubset(group["types"]):
        continue
    # 即使分组含 Health,内循环也仅触碰运动列
    x, vx = group["x"], group["vx"]
    for i in range(len(x)):
        x[i] += vx[i] * dt
        updated += 1

for group in groups:
    print(group["name"], [round(v, 2) for v in group["x"]])
print("Health", list(groups[0]["hp"]))
print("updated", updated)
预期输出:
PVH [0.5, 10.0]
P [30.0]
PV [19.0]
Health [100, 80]
updated 3
P 分组因缺少 Velocity 被跳过;PVH 虽然有 Health,其血量也完全不受位置更新影响。结果验证了查询条件与字段读写的正确性,但不能据此声称 Python 循环比另一种布局快多少:解释器、字典和循环开销会掩盖底层缓存差异。
三种收益分别来自哪里
连续访问减少对随机地址的依赖。处理相邻位置和速度值时,更容易充分利用已经载入的缓存行。若采用原生数组、合适的对齐方式和批量处理,编译器也更有机会向量化。
剔除无关字段降低访存工作量。位置系统不扫描 Health 列,也不访问仅有 Position 的实体;数据的热点范围因此更小。不过当一个系统需要同时处理实体的大部分字段时,紧凑 AoS 或块内混合布局也可能合适。
减少分支来自提前按组件组合过滤。分组数通常远少于实体数,但若组件组合极度碎片化,查询要跨很多小块,收益也会下降;同一个循环内的数据依赖和不可预测业务分支仍需要另外优化。
怎样验证真实吞吐量
要评估缓存友好是否真的改善帧耗时,应在目标引擎的发布构建中,让两种实现执行同样的更新次数、同样的实体数据与同样的结果校验。先预热,再多次采样每帧系统耗时;如果性能分析器支持,可同时观察缓存未命中、内存带宽与分支预测指标。
排除对象创建、日志、GC、结构迁移和其他系统干扰后再比较。若实体很少,布局改造可能得不偿失;若每帧批量处理大量相同组件,连续访问与分组查询通常更值得优先验证。