
游戏客户端架构 / 系统课时
添加组件为什么会迁移
添加组件为什么会迁移
给实体添加 Health 组件,看似只是多存一个数,实际上可能让实体离开原来的 Archetype,进入另一组 Chunk。本课通过一次完整的组件添加操作,解释数据为什么需要搬移、实体索引如何更新,以及怎样减少不必要的结构变化。
学习目标
- 理解添加组件为什么可能改变实体所属的 Archetype。
- 掌握跨 Archetype 迁移、交换删除与实体位置索引更新的过程。
- 判断哪些操作会产生结构变化成本,并采用合适的优化方式。
组件集合决定实体的存储位置
在基于 Archetype 的 ECS 中,实体按照拥有的组件类型集合分组。同一个 Archetype 的实体具有相同的组件类型布局,一个 Archetype 可以管理多个 Chunk,而 Chunk 通常使用连续的组件列保存数据。
假设当前有两个 Archetype:
- PV:包含 Position、Velocity,适合需要位置和速度更新的实体。
- PVH:包含 Position、Velocity、Health,适合同时需要生命值的实体。
Entity 101 原本属于 PV。当它获得 Health 组件时,新的组件集合变为 Position、Velocity、Health,因此必须进入 PVH。
为什么不直接在原来的 Chunk 中添加一个 Health 字段?因为 Chunk 的组件列布局由所属 Archetype 决定。如果只给其中一行增加新列,该行就不再符合整组实体共享的存储布局。
因此,典型的 Archetype ECS 会为实体找到匹配新组件集合的目标 Chunk,然后把已有组件数据迁移过去。
一次迁移需要更新哪些数据
假设 PV 的某个 Chunk 当前包含两行:
| 行索引 | Entity | Position | Velocity |
|---|---|---|---|
| 0 | 101 | (0, 0) | (1, 0) |
| 1 | 102 | (5, 0) | (0, 1) |
现在给 Entity 101 添加 Health=100。典型的迁移过程如下:
- 通过 Entity 101 的位置索引,找到它当前所在的 PV Chunk 和行号 0。
- 根据新的组件集合 Position、Velocity、Health,查找或创建目标 Archetype,并选择具有空位的 Chunk。
- 将 Entity 101 的 Position、Velocity 复制或搬移到目标行,同时初始化 Health=100。
- 从旧 Chunk 删除 Entity 101。若使用交换删除,将原末行 Entity 102 搬到行号 0,再缩减旧 Chunk 的有效行数。
- 更新实体位置索引,使 Entity 101 指向 PVH 的新行,Entity 102 指向 PV 的行号 0。
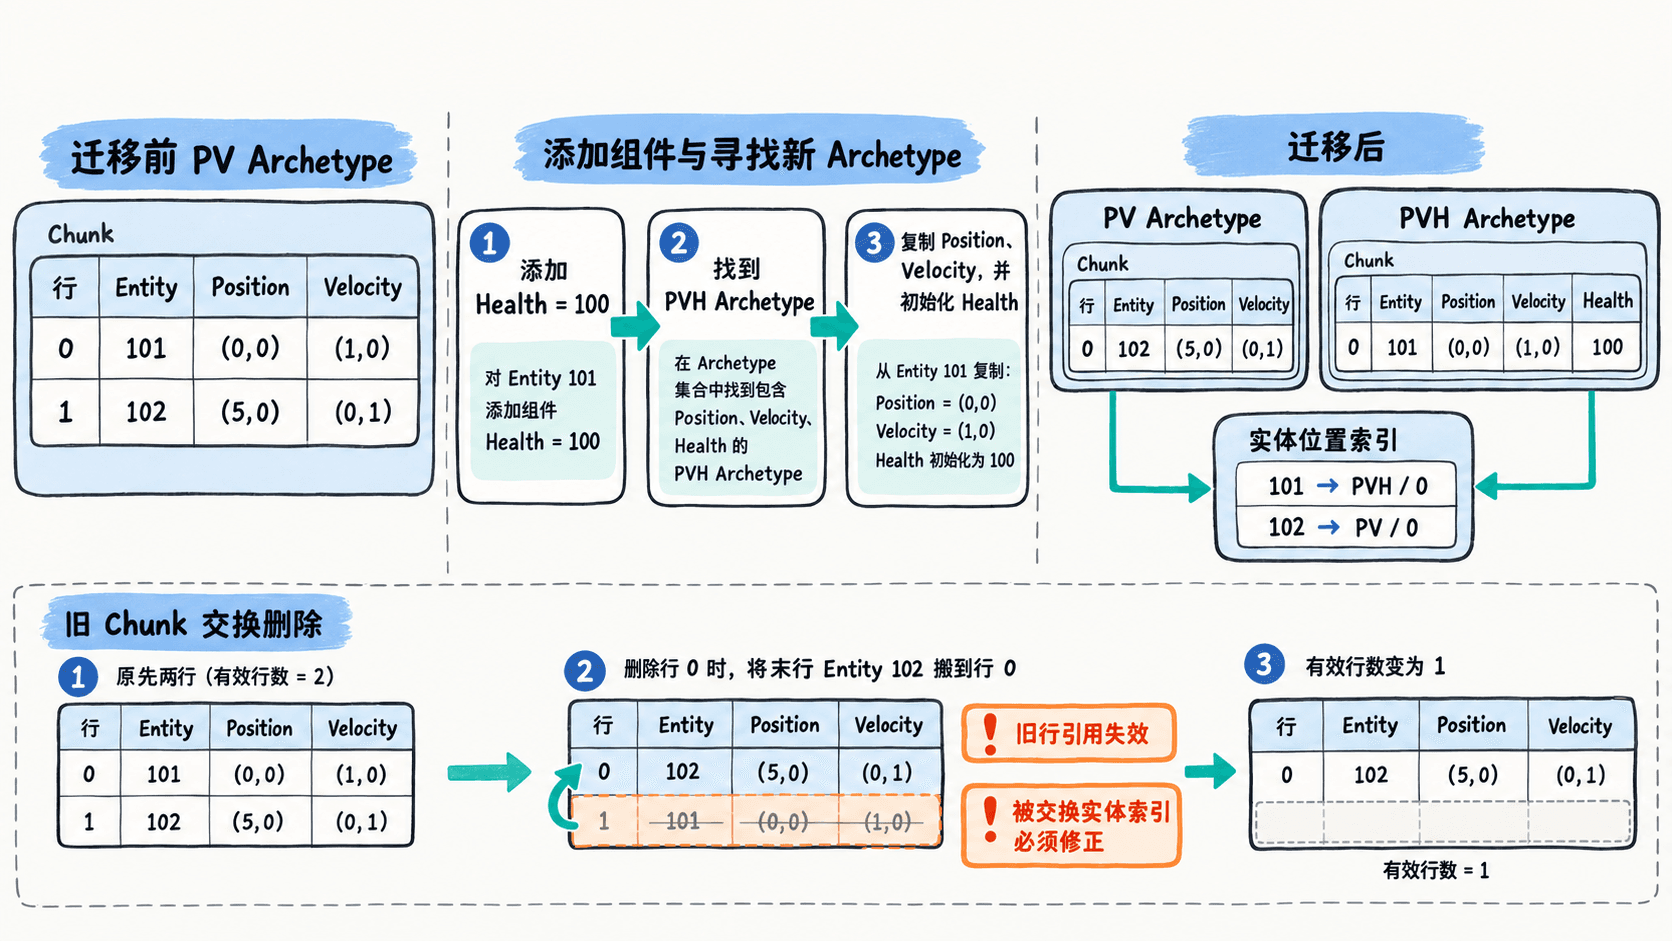
这里最容易遗漏的是第五步。实体迁移完成,不代表所有位置引用都已正确。如果交换删除移动了 Entity 102,却没有更新它的位置索引,后续查询就可能读取错误的行。
还要注意:交换删除不保证实体在 Chunk 中的原始顺序。任何长期缓存的组件行地址、行索引或迭代器,都不能假设结构变化后仍然有效。
用 Python 模拟完整迁移
下面使用标准 Python 字典和列表模拟 Archetype、Chunk 行以及实体位置索引。它并不实现真实的连续组件列,但能够验证组件集合变化、交换删除和索引修正三项关键行为。
# 使用组件类型元组标识 Archetype,列表模拟 Chunk 行
world = {
    ("Position", "Velocity"): [
        {"id": 101, "Position": (0, 0), "Velocity": (1, 0)},
        {"id": 102, "Position": (5, 0), "Velocity": (0, 1)},
    ]
}
locations = {
    101: (("Position", "Velocity"), 0),
    102: (("Position", "Velocity"), 1),
}

def add_component(entity_id, name, value):
    source_key, source_index = locations[entity_id]
    source_rows = world[source_key]
    old_row = source_rows[source_index]

    if name in old_row:
        # 已有组件只更新值,不进行结构迁移
        old_row[name] = value
        return

    target_key = tuple(sorted((*source_key, name)))
    target_rows = world.setdefault(target_key, [])
    target_rows.append({**old_row, name: value})
    locations[entity_id] = (target_key, len(target_rows) - 1)

    # 用旧组末行填补空位,并修正被交换实体的位置
    last_row = source_rows[-1]
    source_rows[source_index] = last_row
    source_rows.pop()
    if source_index < len(source_rows):
        locations[last_row["id"]] = (source_key, source_index)

add_component(101, "Health", 100)
print("PV:", [row["id"] for row in world[("Position", "Velocity")]])
print("PVH:", [row["id"] for row in world[("Health", "Position", "Velocity")]])
print("索引:", locations[101][1], locations[102][1])
预期输出:
PV: [102]
PVH: [101]
索引: 0 0
输出说明 Entity 101 已经进入 PVH,而 Entity 102 在原 PV 中被移动到了行号 0。两个实体的位置索引都与实际存储位置一致。
如果把 add_component(101, "Health", 100) 改成给已经具有 Health 的实体更新生命值,函数会在检查分支直接返回,不再移动组件数据。
真实 ECS 还需要处理 Chunk 容量、组件构造与析构、实体版本、共享组件及并发访问等细节,不能直接把这段教学代码当作生产级实体存储实现。
结构变化为什么可能很贵
添加组件的成本并不只来自新增字段。根据 ECS 的实现以及目标 Chunk 的状态,还可能发生以下工作:
- 查找或创建目标 Archetype,并定位可用的 Chunk 空间。
- 搬移实体已有组件的数据,并初始化新组件。
- 压缩旧 Chunk,修正交换删除影响的实体索引。
- 更新实体到存储位置的映射,并使相关缓存位置失效。
如果一个实体包含大量组件,迁移通常需要处理更多数据。若数千个实体在同一帧内反复添加、删除组件,还可能产生明显的内存带宽开销和运行时间尖峰。
不过,结构变化不必然意味着分配新的 Chunk。目标 Archetype 已经存在且拥有空位时,可以直接复用现有存储空间。
怎样减少不必要的迁移
优化的重点是降低结构变化频率,而不是禁止添加和删除组件。
- 对于只需要修改数值的状态,直接更新已有组件字段,不要先删除再添加同类型组件。
- 对于频繁开关的功能,可考虑使用已有组件中的启用标记,或者 ECS 框架提供的可启用组件能力,但要确认查询能正确过滤禁用状态。
- 对于初始化阶段大量生成的实体,尽量使用最终组件集合直接创建,避免创建后连续进行多次 Archetype 迁移。
- 对于运行阶段集中发生的结构变化,可记录命令并在安全同步点统一执行,避免破坏正在进行的查询遍历。
这些策略也有取舍。例如,长期保留可选组件可能增加内存占用和查询过滤成本。因此应根据组件规模、切换频率和实际性能分析结果选择方案。
实际判断时,先区分操作究竟是更新已有组件值,还是改变组件类型集合。前者通常能够原地完成,后者才需要重点关注迁移成本、索引更新与数据访问安全。