
游戏客户端架构 / 系统课时
查询为什么突然变慢
查询为什么突然变慢
同一战斗场景中的 ECS 查询突然占用更多 CPU,原因未必是实体数量增加。本节把查询拆成组件组合匹配、缓存维护、表或块遍历、实体过滤四部分,用可重复的计数确定退化位置,再选择不会破坏玩法语义的优化方法。
学习目标
- 区分查询缓存更新、组件组合碎片化和低选择性过滤的性能表现。
- 运行诊断模型,观察匹配表数、扫描行数与过滤保留数。
- 根据冷查询、热查询和结构变化后的证据选择修复方案。
先拆开一次查询的成本
以同时读取 Position 和 Velocity 为例,Archetype 型 ECS 通常先匹配包含这两种组件的组件组合,再遍历对应表或 Chunk,最后应用实体级条件。查询耗时可能来自匹配集合更新、更多小块的遍历、组件读取或过滤计算,不能只看返回了多少实体。
不少实现会缓存匹配结果,但失效规则依引擎而异:有的按版本重建,有的增量纳入新 Archetype。发生结构变化不等于每次查询都会全量重建缓存。应当分别观察首次执行、重复执行、创建新组件组合后的表现,而不是直接把卡顿归因于缓存。
还要区分两种过滤问题:1000 个候选中有 950 个通过,属于区分能力弱的低选择性过滤,后续工作量几乎不减;若仅 10 个通过却必须先访问全部 1000 个,则可能是过滤位置过晚。二者都可能浪费工作,但优化方式不同。
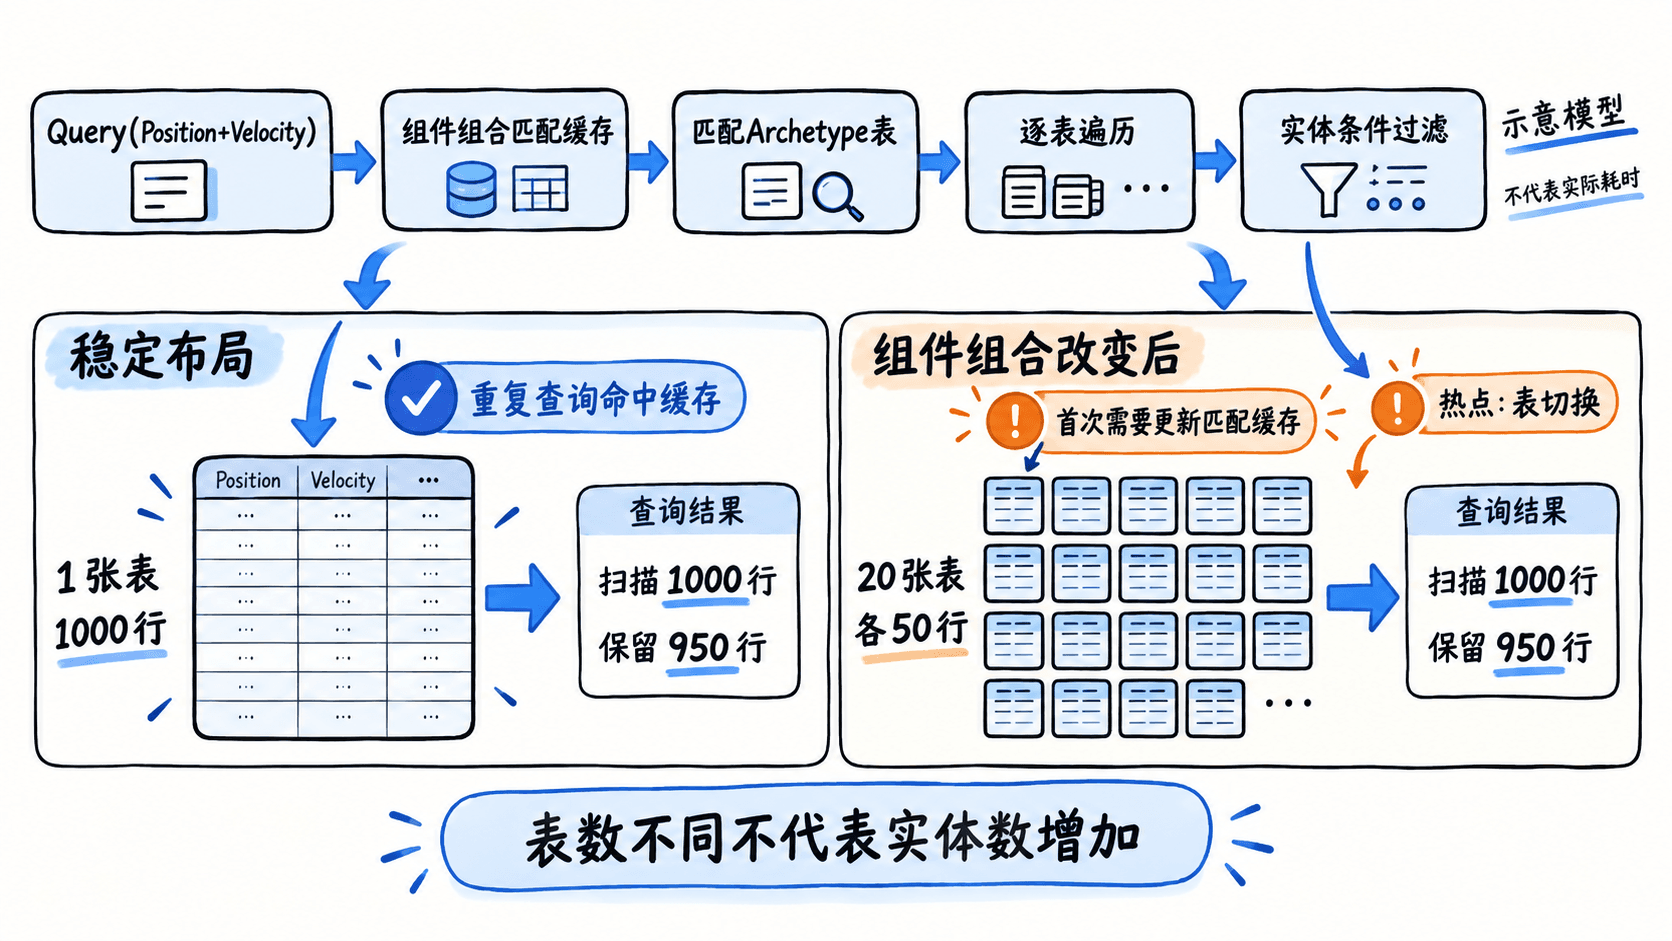
用可运行模型区分三种现象
下面的 Python 3 程序刻意简化了 ECS:tables 表示组件组合到实体集合的映射,version 表示布局变化,缓存只保存匹配的表。这是用于诊断思路的教学模型,并非某个引擎的查询 API,也不用于推断实际耗时。
class QueryModel:
    def __init__(self):
        self.tables = {frozenset({'Position', 'Velocity'}): range(1000)}
        self.version = 0
        self.cache = {}

    def run(self):
        required = frozenset({'Position', 'Velocity'})
        entry = self.cache.get(required)
        rebuilt = entry is None or entry[0] != self.version
        if rebuilt:
            # 示意:表布局版本变化后重建匹配列表
            rows = [ids for mask, ids in self.tables.items()
                    if required.issubset(mask)]
            self.cache[required] = (self.version, rows)
        else:
            rows = entry[1]
        # 过滤通过率高,但依然检查每个候选行
        scanned = sum(len(ids) for ids in rows)
        passed = sum(eid < 950 for ids in rows for eid in ids)
        return f'rebuild={rebuilt} tables={len(rows)} scanned={scanned} passed={passed}'

model = QueryModel()
print('初次:', model.run())
print('热缓存:', model.run())
# 1000 个实体分散到 20 种不同的组件组合
model.tables = {
    frozenset({'Position', 'Velocity', f'Tag{i}'}): range(i * 50, (i + 1) * 50)
    for i in range(20)
}
model.version += 1
print('结构变化后:', model.run())
print('再次:', model.run())
预期输出:
初次: rebuild=True tables=1 scanned=1000 passed=950
热缓存: rebuild=False tables=1 scanned=1000 passed=950
结构变化后: rebuild=True tables=20 scanned=1000 passed=950
再次: rebuild=False tables=20 scanned=1000 passed=950
这组结果把三个信号分开了:版本变更让模型重新计算匹配集合;匹配表从 1 张变成 20 张;扫描行数仍是 1000,且过滤后保留 95%。实际 ECS 中小 Chunk 的切换可能损害局部性,但表数增加并不自动意味着耗时增加 20 倍,必须再用性能采样核实。
根据证据选择修复动作
| 观测信号 | 优先处理 |
|---|---|
| 首次或结构变化后明显慢,连续重复查询正常 | 检查新 Archetype 的生成频率及匹配缓存更新;能复用稳定组合时避免每帧制造新组合 |
| 匹配表、Chunk 数增加,扫描行数基本不变 | 找出频繁出现的临时标签与组件组合,评估改为已有组件的状态字段或更稳定的布局 |
| 大量候选通过过滤,后续处理仍昂贵 | 删除没有区分度的判断;有语义上更精确的查询条件时,尽量提前缩小候选集合 |
| 只有少量候选通过,却仍遍历大量行 | 把便宜的判断前移,或使用引擎支持的 Chunk 级过滤、预分组机制 |
不能为了减少 Archetype 数而把所有状态塞入同一个巨型组件:那会增加无关数据读取,也可能破坏系统所需的查询隔离。先确认哪些状态确实需要作为组件组合的一部分。
在相同负载下验证
对优化前后分别采集冷查询、连续热查询、结构变化后第一帧的数据,记录查询耗时分布、匹配 Chunk 数、候选和通过行数以及分配量。固定实体数、操作脚本和运行环境,重点对比高分位帧耗时,不要仅凭单次计时得出结论。
若查询耗时没有随表数、过滤成本同步变化,应继续检查其他 System、内存分配和同步等待。可靠的优化结论应同时满足:热点确实下降,查询结果一致,且没有把成本转移到结构提交或其他阶段。